半年大盘超百亿,大厂重估卖Token的生意
封面来源丨公开网络,"The Railway Bridge At Argenteuil", Claude Monet,1873
2011年,硅谷风投机构Andreessen Horowitz(a16z)联合创始人马克·安德森写下那句名言“软件正在吞噬世界",SaaS的十年由此开场。而在六年后,黄仁勋补了下半句:软件正在吞噬世界,但AI将吞噬软件。
不过,即使在两年前,大多数人并不相信卖Token能是一门好生意。但在2026年,这已经成为现实。
近期,IDC正式发布了2026年H1报告。2026年上半年,中国公有云MaaS市场收入为106.3亿元,同比增长889.4%。
在公有云大盘多年放缓增速时,能在两年内迅速达到百亿规模的市场屈指可数。
MaaS已经是观测全球AI市场发展的关键性指标。这是一门常被类比为“水电煤”的生意:模型厂商通过API等形式提供服务,企业或个人无需自建模型和算力,便可通过MaaS平台调用模型完成文本生成、代码编写等任务。厂商按Token调用量、算力使用时长或套餐订阅收费,模型调用越多,收入越高。
在2026年的新赛季,火山就拔得头筹——根据IDC《中国AI软件市场半年度》数据显示,在2026年H1,火山就占据了国内公共云MaaS营收大盘的近五成。
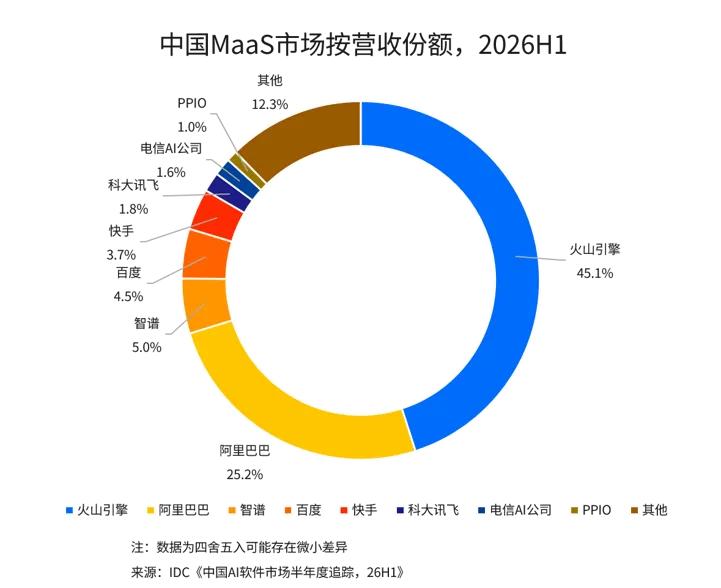
从围绕MaaS指标的讨论中,我们也能窥见市场共识的变化。
2025年,业界还在争论谁才是MaaS市场上Token销量更高、性价比更好的那朵云;到了2026年,面对一年增长近9倍的市场,大家的关注指标也逐渐统一成:MaaS收入。
Anthropic和OpenAI仍然是中国厂商们的“课代表”。近期Anthropic的IPO招股书引起热议,就是因为其商业化增长再一次刷新了市场预期——2026年上半年,Anthropic总收入达到162.86亿美元,其中八成来自按Token量计费的推理收入。
智能体的Token消耗成倍增长,也推高了Anthropic的客单价。招股书显示,2026年三季度,未使用Claude Code的企业版用户月均支出不足75美元;使用Claude Code的前5%高支出企业版用户,花费约是前者的20倍。
这种增长远远没有见顶,引发了国内大厂的激进投入。从今年年中开始的AI办公大赛——
如今,行业共识已经前所未有地清晰:做出顶尖模型。这是迅速拉高Token消耗,并让客户愿意为之付费的最好方式。
大模型商业化的空间也正在被打开。传统云计算的上限,很大程度受制于企业的IT预算,而MaaS对标的是生产力——理论上,一个国家的MaaS市场规模,最终会和它的GDP、人口挂钩。按这个逻辑,国内只是全球市场的一部分,一位云行业人士估算,海外的市场空至少是国内的3-4倍。
我们也独家了解到,从今年下半年开始,火山将开始重点开拓海外市场,并已经开启激进的商业化进程。到年底,火山的海外业务营收占比预计就将接近40%。
比云计算更像“水电煤”的生意
为什么2026年会成为MaaS市场重要的分水岭?一个现象是,市场从追求Token消耗量,逐渐收敛到了追求收入。
追求Token消耗,是因为市场仍处在早期。2025年以前,大部分的AI任务都集中在AI搜索之类的简单对话,交互轮次、对话深度都有限。
当时大部分厂商的主要任务都是提升Token消耗。2025年
转折点来自Anthropic的Claude Opus 4.6,它让模型第一次可以真正进入生产级的Coding和Agent场景——规划任务、依次调用工具、记录执行状态。一次任务可能依次调用十余个工具接口,至交付任务为止,token消耗量也会指数级上升。
当任务从短对话变成长程任务,模型卖的就不只是一次回答,而是真正变成了一种服务。模型厂商在按Token收费时,更容易对应高价值的工作任务。
交互形态改变,也改变了MaaS的增长和生意逻辑。
“从语言模型来看,客户的任务特征已经不太按行业或者模态划分,客户往往什么任务都会跑,所以火山今年的定价细分也是按任务的输入长度,而不是按客户类型划分。”一位火山人士称。
MaaS市场也因此进一步走向成熟。
一个标志是,在Coding打开了生产力场景前后,各个模型厂商都选择了更适合的自己的生态和产品定位,这已经变成了关键的市场竞争策略。
比如,从旗舰模型K2发布后,
但智谱就选择了专注Coding场景,推出了一个体量处在舒适区——数千亿参数的模型,但调用速度相对更快,能完成大多数编程任务,从而实现了快速的商业落地。
2026年上半年,智谱收入增长近4倍,一路走高至9.54亿元,其中超过八成来自API调用。
尽管Seedance系列模型已经保持全球视频领域的SOTA近8个月,但我们接触的大多数AI行业人士表示,目前无论什么模态,都谈不上绝对的护城河。
这也是MaaS和传统云计算最本质的区别。传统云时代,厂商可以通过存储、数据库的产品,把客户的数据留在平台上,迁移成本较高;但在MaaS时代,模型调用链路如果加密,平台很难靠绑定数据来锁住客户。如果另一个厂商发出了更强的SOTA模型,客户随时可能切换模型。
换句话说,比起云计算,MaaS是更像是纯粹的“水电煤”生意。要留住客户,唯一的办法是让模型真正嵌进企业的生产管线——先推出足够SOTA的模型,迅速铺开;用户才会将其用于更多有挑战的任务。
36氪了解到,Seedance在推出之前,只是定位为一个创作类场景,但在创作领域很快达到SOTA,完成商业化覆盖之余,客户自发的一些场景创新也在出现——不少具身公司也会使用Seedance做corner case(一些极端情况)的数据处理。
而当调用量增加后,真实用户反馈也会更多,进而反哺推理工程和产品设计,才能赶在对手追平前跑出下一版更好的模型。
不仅追求收入增长,更要追求智能密度
MaaS比云计算更像水电煤的生意,这个市场的爆发速度,如今看来也比上一个时代更猛烈:中国公有云市场从2009年起步,花费7年时间才跨过百亿元的全年规模门槛;如今MaaS市场把这个时间缩短了一半。
不过,另一个常被讨论的问题是:MaaS更像水电煤生意,看似比传统云更难让让客户产生粘性,为何大厂还要不计代价地往里砸钱?
一方面,传统云计算的上限,本质上受制于企业的IT支出预算;而当AI进入Coding、视频制作、日常办公等核心生产环节,MaaS对标的是生产力预算——企业花的不是给IT提效降本的钱,而是相当于购买了一批虚拟数字员工。
硅谷研究机构SemiAnalysis曾经对50余家企业进行调研,目前大多数Fortune 500企业的人均AI支出还不足100美元/年,而头部高强度用户的年均花费已超过9万美元/员工,两端相差近660倍。这意味着,企业侧Token消耗的真正爆发还没到来。
MaaS有望将市场天花板上限大大拓宽。大多数行业人士的观点是,MaaS的爆发比云计算还要更剧烈。很长一段时间里,MaaS市场都会保持卖方市场阶段。
更多情况下,AI算力供给决定了MaaS市场整体大盘增速。“模型只要能SOTA,那么就是生产多少智能,就能够消耗多少智能。”一位行业人士说。
在MaaS这件事上,当不少云厂商还只是把MaaS当作撬动传统云大单的钩子时,火山早在2023年就把MaaS当作唯一的赌注,相信它能跑出比传统云大得多的市场。
由于模型迭代太快,为了避免工程适配精力被分散,火山并没有推出诸多模型尺寸。无论是语言还是视觉模型,现在火山都只主要聚焦两个模型尺寸:一个大尺寸旗舰模型,第一优先级探索智能上限;而Flash模型则负责上量,迅速铺开商业化。
2023年,当字节的自研基础模型还在起步阶段时,火山就先大量引入三方模型,先切入更多应用场景。类似Flash这样体量的模型,尽管没有贡献最多的收入,在火山上的调用量已经是旗舰模型的数倍,承担了更为广泛的生产力渗透,以及新场景探索的功能。
而在这个过程里,火山也提前磨合好了模型工程、应用与商业化团队的协同链路。
”现在MaaS收入就是火山第一重要的事,一切资源为此让路,”一位行业人士笑称,“你想卖GPU资源也根本没有可卖的,卡都拿去做推理和训练了。“
一位火山人士回忆称,从2025年Q4开始,在看到生产力场景的潜力之后,火山很快调整了战略,让收入而非Token消耗量作为团队最核心的指标。
围绕生产力场景,火山的组织和销售团队在快速成形。在2026年7月整合了飞书、
一系列调整显示出的信号是,由于生产力场景的打开,如今SaaS和Token的生意越发趋同——用户要的是交付任务价值,而非单纯的工具产品席位。
落到商业化上,火山的定价和产品原则也相当稳定:先要有健康的毛利,其次要在市场中有竞争力,最后再根据不同任务需求做差异化。
Seedance的惊人一跃则是2026年颇值得参考的案例之一。
Seedance在短短数月就已经达到了极高覆盖度。除了在参数、生成效果上达到视频领域SOTA外,火山一侧的许多工程化工作,也加速建立起了竞争优势。
Seedance 2.5上线时,火山重点推出了“Draft”(样片)功能,这来自火山团队在2.0爆火的一个观察:专业创作者很少一次就能出满意的镜头,往往要反复抽卡。每次都用1080P甚至4K去试,成本太高,这阻碍了用户继续使用。在Draft上线后,用户先用性价比高的模型生成低分辨率预览,再付正式生成的费用,能节省大多数无效抽卡的成本。
当任务智能密度更高,智能的价值也会随之上升。由于推理成本持续优化,这并没有折损收入,最终,出同等数量成片的总花费,使用Seedance 2.5普遍比用2.0的费用还低。
36氪了解到,Seedance 2.5 Draft已经成为目前用户使用深度极高的操作模式,很大促进了模型的用户使用粘性。
现在,哪怕手握自研旗舰模型,大厂们在应用入口上反而变得前所未有地开放——10月29日,
不只是字节,阿里的
无论自研还是三方,背后的考虑都是趋同的:大厂们都在想办法把复杂任务留在自己的产品中——这不仅是为了拉高眼下的Token消耗,更是为了借高频的生产力入口,摸清哪些才是真正值得重兵投入、智能密度更高的场景。
“我们现在和模型团队就是一体的。”一位
















