从数据中台到知识中台:企业级本体如何让 AI 理解并操作数字化生产环境
2026 年,国家层面密集出台政策推动人工智能与产业深度融合。4 月,工信部、国家数据局联合印发《关于联合实施 2026 年“模数共振”行动的通知》,聚焦 20 个重点行业推动“以模引数、用数赋模”。6 月,国家数据局发布的《关于推进行业高质量数据集建设行动的实施方案》明确提出,面向智能体应用,加强知识库、知识图谱、本体等数据集建设。本体由此从技术概念上升为产业基础设施,企业级 AI 的落地路径也随之面临重新定义。
这意味着,AI 与产业的融合,正从“模型能力比拼”进入“数据与知识基础设施竞争”的新阶段。大模型要真正进入企业生产环境,需要一套能让 AI 理解业务语义、关联复杂计算、驱动系统操作的语义基础设施。
在与中国联通、能源电力、油气、金融等行业客户开展企业级本体建设的过程中,海致反复思考两个问题:本体到底是什么?本体在企业里到底解决什么问题?
本文将从本体与企业数据之间的鸿沟、数据中台到知识中台的升级、本体与图的关系、面向 AI 的多模数据库形态四个层面展开,分享海致在企业级本体建设中的思考与实践。
01 为什么大模型“读不懂”企业?本体与企业数据之间的鸿沟
从通信网络到数据网络,再到语义网络的延伸,是产业数字化的必然走向。
当前,中国企业尤其是像联通这样的大型国有企业,已经完成了数字化转型。数字化转型带来一个本质变化:企业的所有业务都可以被数据描述,而且数据量很大,数据计算的复杂度也很高。这些数据绝大部分以二维关系表(如订单表、客户表)形式存在,并不是一维的、按顺序线性排列的文本数据。
当行业大模型试图进入企业生产环境时,首先遇到的,便是这一数据形态上的鸿沟。
在上一轮行业大模型的建设中,不少公司把企业的语料文本拿去参与大模型训练,但成效甚微。原因在于,大语言模型主要以文本参数为主进行训练,而企业真正的业务数据,大量存在于关系表及其背后的计算之中。
因此,与其说大模型是在“产生幻觉”,不如说它不能很好地理解大量关系表以及关系表背后实际存在的计算。
如果要让大模型去理解这些关系表,就需要做大量类似 Prompt 或 Embedding(文本向量化,即将文字转化为机器可计算的数字矩阵) 的文本解释工作。但人类的认知顺序是先发明了语言,再发明了数据——数据本质上是对语言所描述的现实的进一步抽象和结构化。让大模型从文本逆向理解关系表和复杂计算,这个逆向工程基本上是不可实现的。
从技术层面看,这一问题的根源在于:大模型的核心能力是语义理解与生成,而企业数字化环境的运行逻辑建立在确定性计算之上。关系表之间的关联、聚合、过滤等操作,以及由此形成的业务规则和约束,构成了一个与自然语言平行的形式化系统。大模型擅长的概率生成机制,与这一形式化系统所要求的精确性和可验证性之间存在本质张力。大模型基于概率分布“生成”最可能的答案,这种机制天然带有不确定性;而企业的形式化计算系统要求结果精确、可复现、可验证。这正是大模型直接对接企业数据时容易出错的根本原因。
因此,企业必须回答一个核心问题:如何把海量数据以及底层复杂计算有效地组织起来,让 AI 能够认知。今天所有企业的现代化管理都依托于数字化运营,而数字化运营能解决的问题很直观:所有业务可以量化、可以分析、可以解释、可以溯源。这是纯文本方式难以解决的。
海致构建本体的出发点,就是让 AI 在已经具备的语义环境基础上,与企业更早建设的数字化环境打通。让 AI 通过这些语义理解,去认知数字化生产环境,甚至接管和操作数字化生产环境。这才是企业最需要的。
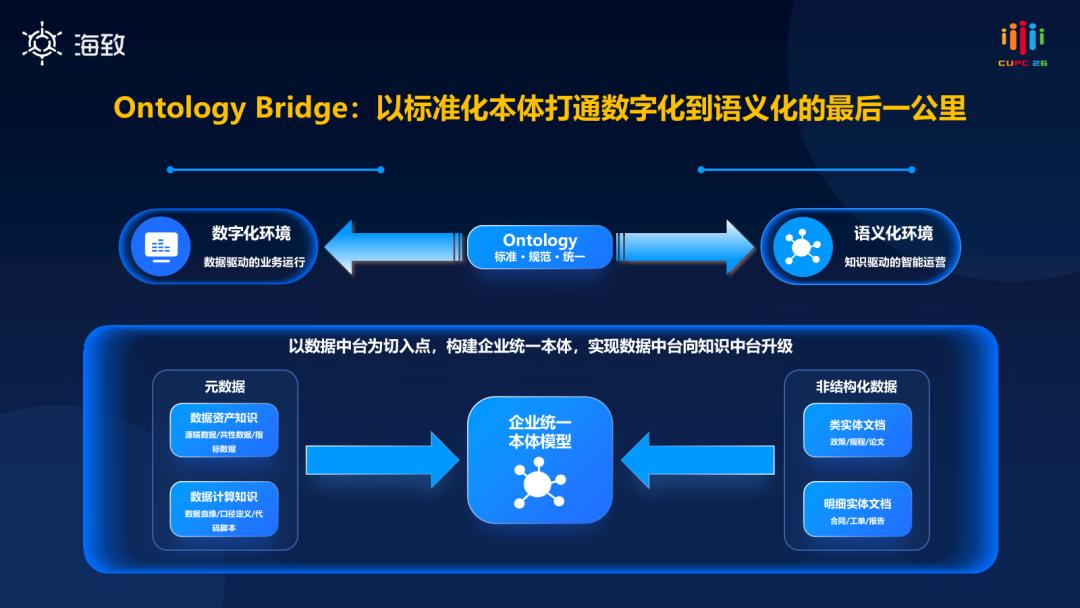
这也引出了本体的核心定位:本体连接的一端是人(依赖自然语言表达业务意图),另一端是机器系统(依赖结构化数据和确定性计算运行)。让人和机器就“同一件事到底是什么”达成共识,正是本体要解决的核心问题。
02 从数据中台到知识中台:纳管的不只是数据
过去建设数据中台时,核心要解决的一个问题是:企业有大量业务系统,但无法让这些业务系统之间达成共识,也不可能有一个程序员对所有业务系统的代码都非常了解。于是,行业普遍采取了一种解法:将底层业务系统的数据抽取出来,在外部建立跨系统的数据共识,进而重新构建跨系统的业务服务。
这是当年建设数据中台的逻辑。
今天,这个逻辑正在经历一次演进:企业的数据中台正升级成知识中台。
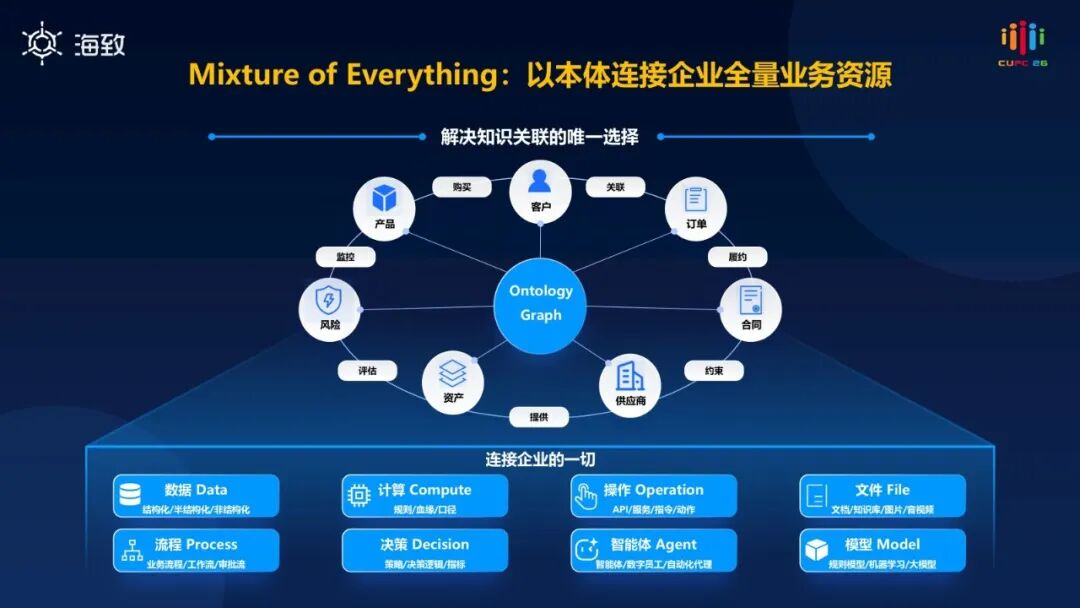
从架构演进的视角来看,数据中台的核心任务是解决“数据在哪”和“数据可用”的问题,其基本单位是表和字段。而知识中台在此基础上进一步回答“数据是什么意思”、“业务规则是什么”、“如何执行动作”。
这一升级的本质,是在原有数据资产层之上叠加一层“语义控制层”:数据中台负责打通数据的物理存取,知识中台则负责打通数据的业务含义和执行路径,使 AI 能够将自然语言问题转化为可验证、可执行、可追溯的语义任务。
知识中台的任务,同样是纳管企业大量的数字化生产环境和系统。但纳管的内容不再只是数据,而是要解释清楚:
- 每一个系统里有什么样的数据;
- 可以进行什么样的计算;
- 基于每一个计算结果可以执行什么样的业务操作;
- 所有业务系统所映射到的业务文本中,存在哪些系统所执行的相关业务规定。
- 这一套内容,才是企业数字化引擎真正的知识。
无论称作知识中台还是知识底座,其本质都是未来承载本体的纳管平台。它不仅能够全面纳管企业的所有数字化业务(包括非结构化语义中的业务),而且纳管的边界也已远超传统数据中台的范畴。
唯有如此,AI 才能理解企业整个数字化生产环境,最后才可能谈到基于 AI Coding 去连接所有系统,自动化完成任务。
在工程实施层面,目前各行业对结构化系统与结构化数据的构建方式,已经研究得比较充分。真正遇到的最大问题是:结构化和非结构化数据到底要不要打通,怎么打通?
从海致的实践经验看,因为海致的目标是让 AI 在理解语义之后操作数字化环境,所以本体的构建路径应该是从结构化向非结构化去衍生,而不是反过来。理由是:统一语义必须具有唯一性和确定性,而企业业务系统作为系统,其数据的唯一性天然优于分散在文档中的描述性文字。
而且,今天要解决的是操作系统的问题:如果系统本身没有这个功能,就不需要在本体中理解它。因此,应优先构建结构化环境中的统一语义,再借助类似 F1A(First Principles Alignment,即面向第一性原理的限定本体生成技术——从最基础、最确定的业务事实出发进行推导,再逐步生成本体)的限定本体生成技术,将文档内容与之对齐。
将非结构化数据纳入之后,它在本体中主要有两个合适用法:第一,将非结构化文档作为知识库进行检索;第二,这些文本信息可以在数字化环境进行复杂计算解析时,提供有效的语料补充。这也是纳入非结构化的必要性。
此外,业务侧和数据侧之间常常难以准确定位,但企业中始终存在两种计算:一类是 OLAP,联机分析处理,即用于业务数据分析和报表生成的计算,回答“发生了什么”;一类是 OLTP,联机事务处理,即用于日常业务操作和交易记录的计算,负责“正在发生什么、该如何处理”。
AI 在构建本体的时候,需要考虑到:初期只是基于数据的核心分析计算,例如经分(经营分析)业务;未来还会衍生到系统与系统之间操作连接的事务性计算,例如供应链管理、客服管理等服务。
从技术架构的角度,传统上 OLAP 和 OLTP 各自维护一套数据模型——数仓分层模型(面向分析场景,按主题、层级组织历史数据)服务于分析场景,而事务模型(面向业务流程,强调实时读写一致性)服务于业务流程,两者之间缺乏统一的语义桥梁。
本体的价值在于,它不是在数据模型之上简单叠加语义标签,而是补充了原有缺失的行为语义(这个动作意味着什么)、动态过程建模(这个流程如何随时间演变)和业务规则约束(什么条件下可以/不可以执行),从而真正打通了 OLAP 到 OLTP 的路线,实现数据分析到业务执行之间的穿透。
但 OLAP 与 OLTP 本质上并不矛盾。关键在于,二者必须遵循同一套统一语义规范,其余问题更多属于工程实现层面。
03 本体与图:统一语义与 Graph Engineering
海致以知识图谱起家,因此经常被客户问到:本体和图是什么关系?
从 OWL(网络本体语言,Web Ontology Language,一种用于定义和构建本体的国际标准语言)的构建方式看,本体也是基于图论的,这一点毫无疑问。W3C(制定互联网 Web 标准的国际标准组织)在 OWL 标准文档中明确:本体定义了用于描述和表征某一知识领域的术语,包含领域内基本概念的计算机可用定义以及概念之间的关系,让知识可以跨系统、跨应用共享和复用。
基于单一场景构建本体时,是否一定要用图数据库来承载和管理它,其实未必。关系表可以,向量索引也可以,选型取决于具体场景的查询和计算需求。
中国企业今天面临的一个复杂问题是:当场景本体越建越多以后,会不会像过去直接建 ODS (操作数据存储,Operational Data Store,指直接汇聚业务系统原始数据的临时存储层)一样,数据越建越散,最后变成资产管理问题?资产管理本身并不困难,真正的难点在于如何避免碎片化——即不同场景各建各的本体,彼此之间无法互认、无法复用。
因此,一个共识逐渐形成:正如当年在数仓中构建 DWD/公共层(这里统一为“数仓公共层”,即数据仓库中对原始数据进行统一清洗、标准化后形成的共享层),就是为了做语义的约束与共识。今天在本体构建上,同样可能要优先构建“图语义”这一统一层。
也就是说,无论数据、计算、操作,归属于哪一个大家互认的业务场景,归属于哪一类大家互认的业务活动,归属于哪一个具体业务对象,在这些层面上,必须达成一致。
只有基于统一语义,才能锚定所有的数据、计算和操作的服务知识。这跟数仓的逻辑是一样的。因此,企业面向智能体、大模型或者人工智能,核心都是把企业知识组织构建变成一项图知识工程,即 Graph Engineering。
此前文章曾对 Graph Engineering 做过系统阐释
Graph Engineering(图谱工程)是一种面向解决方案的知识网络架构。如果说 Harness Engineering 解决的是“如何驾驭模型”,那么 Graph Engineering 解决的则是“模型该信什么”的问题——为模型构建可信、可推理、可演化的结构化世界模型。
在海致的定义中,Graph Engineering 与 AI 工程的整体演进(Prompt Engineering → Context Engineering → Harness Engineering)并非平行,而是垂直嵌套:它正是 Context Engineering 向图谱的深化,也是 Harness Engineering 中“控制层”与“记忆层”的技术内核。
换言之:知识图谱擅长描述“哪些事实彼此关联”(是什么),而企业本体则进一步定义了“这些关联意味着什么、可以触发什么行为”(怎么做)。
因为企业最终会发现,如果想让 AI 把它用好,数据、计算、操作、流程、决策都需要关联;形成 Agent 和专家模型以后,Agent 也需要关联,专家模型也需要关联。
从上到下各层的关联,只靠一个东西去枢纽,就是统一语义。
04 面向 AI 的数据库:图、向量与动态本体
除了业务场景上的思考,海致当前重点推进的另一个问题是:假设企业的内在知识关联非常重要,并且以图的形式存在,那么过去的图数据库和未来面向 AI 的数据库,形态将发生本质改变。
去年,海致承接了工信部“多模数据库”专家项目(面向多种数据类型——关系、图、向量、文档、时序等——统一存储与查询能力的下一代数据库技术方向),该项目实际上正是在回答未来企业知识运营的“存”(存储)与“算”(计算)核心服务形态该如何设计。
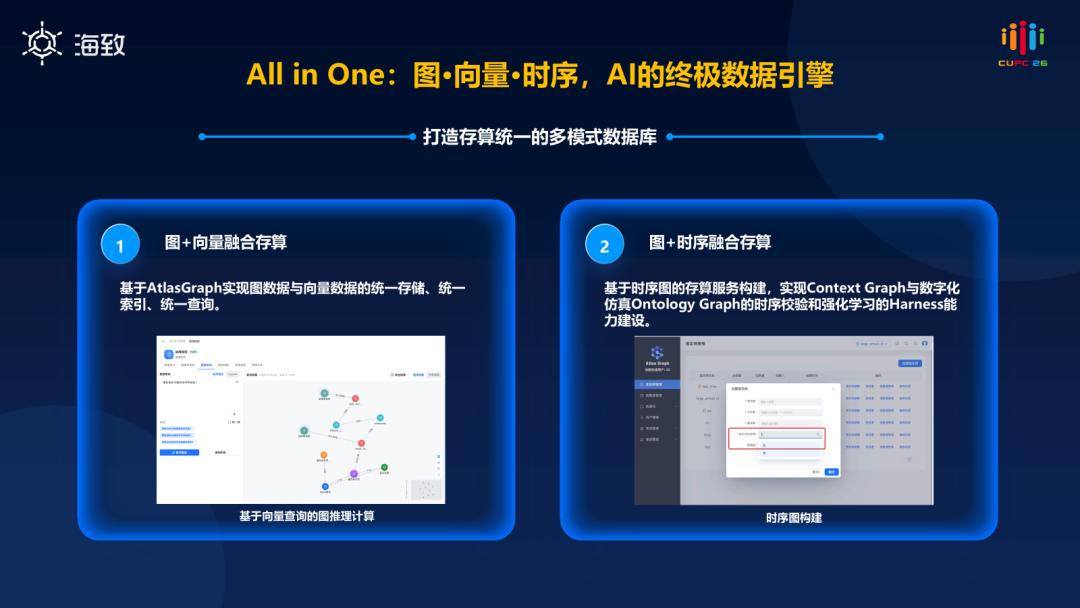
首先第一个层面,是图如何跟向量打通:既可以“用向量查图”(先做语义相似度检索,再顺着图的关联关系扩展),也可以“将图转化为向量”(把图结构编码为向量表示)参与图注意力模型——一种能自动识别图中哪些关联节点更重要的神经网络模型的微调。
这一方向与当前数据库领域的技术演进高度一致
Gartner在《数据库市场指南》中预判,到 2026 年,新建核心系统中采用多模架构的比例将超过 60%。业界普遍认为,多模架构正成为主流选择。多模融合数据库的核心思路,是在同一个引擎中实现关系、向量、图、文档、时序等多种数据模型的统一存储与查询。在检索层面,韩国科学技术院(KAIST)与 GraphAI 的研究团队提出的“Omni RAG”方案表明,向量相似性搜索与图遍历的结合,可以使AI同时挖掘文档语义、知识图谱关系及表格结构化条件,从而锁定更精确的证据,有助于降低智能体的“幻觉”问题。
第二个层面,是时序能力为何必要。今天构建的所有本体,在构建成的那一刻都是静态本体。但未来在企业里,很可能会出现大量的动态本体。
静态知识图谱中的三元组(知识图谱的基本单元,通常表示为“实体-关系-实体”的结构)很少更新,其局限性在于所承载知识的时效性不足。动态知识图谱则通过持续采集和更新知识来保证时效性。时序知识图谱进一步将时间信息(即每条知识“从何时到何时”成立)融入图谱结构,能够更准确地表示知识的动态变化。
所谓动态本体,举例来说,像联通的基础设施运维、IDC 机房运维,所有设备的连接本来就是动态变化的。基于动态连接关系的变化,本体需要具备持续的知识抽取与学习能力,而不能只做一次性建模——这可能才是未来本体建设的核心难点。因为今天不可能只基于企业固定的业务场景,比如经分业务——企业的指标与数据之间的映射关系一旦明确,就可以静态地、不停地按同一套规则计算下去;更多场景需要模型随实际情况的变化而更新。
但未来可能存在这样的情况:在做业务流程设计的时候,业务流程本身会不会发生动态变化?这种动态变化需不需要记录?需不需要被 AI 学习和吸收?
这就是海致当前思考的三个问题:图与向量、静态与动态、时序与学习。
结语
从数据中台到知识中台,从单一场景本体到统一图语义,从静态本体到动态本体,从图数据库到图、向量、时序融合的多模数据库,企业 AI 落地的关键,正在从“让大模型读懂文本”转向“让 AI 理解并操作数字化生产环境”。
而贯穿这一切的枢纽,是统一语义。只有将企业的数据、计算、操作、流程、决策、Agent 和专家模型都通过统一语义关联起来,Graph Engineering 才能真正成为企业知识组织的核心工程,AI 也才能真正进入企业的数字化生产环境,完成从认知到操作的闭环。
本体的终点,不是让 AI 取代人,而是让人和机器在同一套语义体系下达成共识——人负责定义业务意图,机器负责精确执行。统一语义,正是这场共识的起点。
*本文基于海致科技高级副总裁瞿珂在2026中国联通合作伙伴大会上的分享整理撰写
本文来自微信公众号“海致科技”,作者:海致,36氪经授权发布。
















