AMD跟英伟达“掰手腕”,Helios够格吗?
对外销售的商用 GPU 市场目前主要是英伟达和 AMD 两家。MI300 时代 AMD 因为缺少系统级方案(所谓系统,核心就是互连方案)几乎没有吃到 AI 算力的红利。但是现在 Helios 来了,那么:
1)AMD 是否真正具备了与英伟达同台掰手腕的能力?
2)在互连方案的竞争与迭代中,到底有哪些产业链逻辑变化,谁受益谁吃亏?
我们将从互连的角度来研究这一问题。关于AI互联的基础信息,请参考上篇基础梳理。
以下为详细分析
我们从比较英伟达和AMD组网方案差异开始:
一、软实力之争:生态位对战
1.1 Scale-Up:英伟达的黄金标杆 vs 众人抱团取暖
英伟达:黄金标杆的封闭生态。NVLink 与 CUDA、NCCL 软件栈深度绑定,延迟、带宽性能一流,但价格昂贵,且采用封闭生态基本等于被英伟达绑死。为缓解客户顾虑,英伟达 2025 年推出 NVLink Fusion,向第三方 CPU、xPU 部分开放,把 NVLink 转为半开放标准,便于非英伟达芯片接入其芯片域。
AMD:抱团对抗英伟达。UALink,以AMD为主的同盟,来对标NVLink的Scale-Up协议,以Infinity Fabric(早先为CPU间通信协议,目前延伸为GPU间互连)为核心。
后续开源 IF,并提供灵活 I/O 通道支持不同标准,以此推动下一代开放标准 UALink,联盟成员包括 AMD、ALAB、AWS、Google、Meta等。
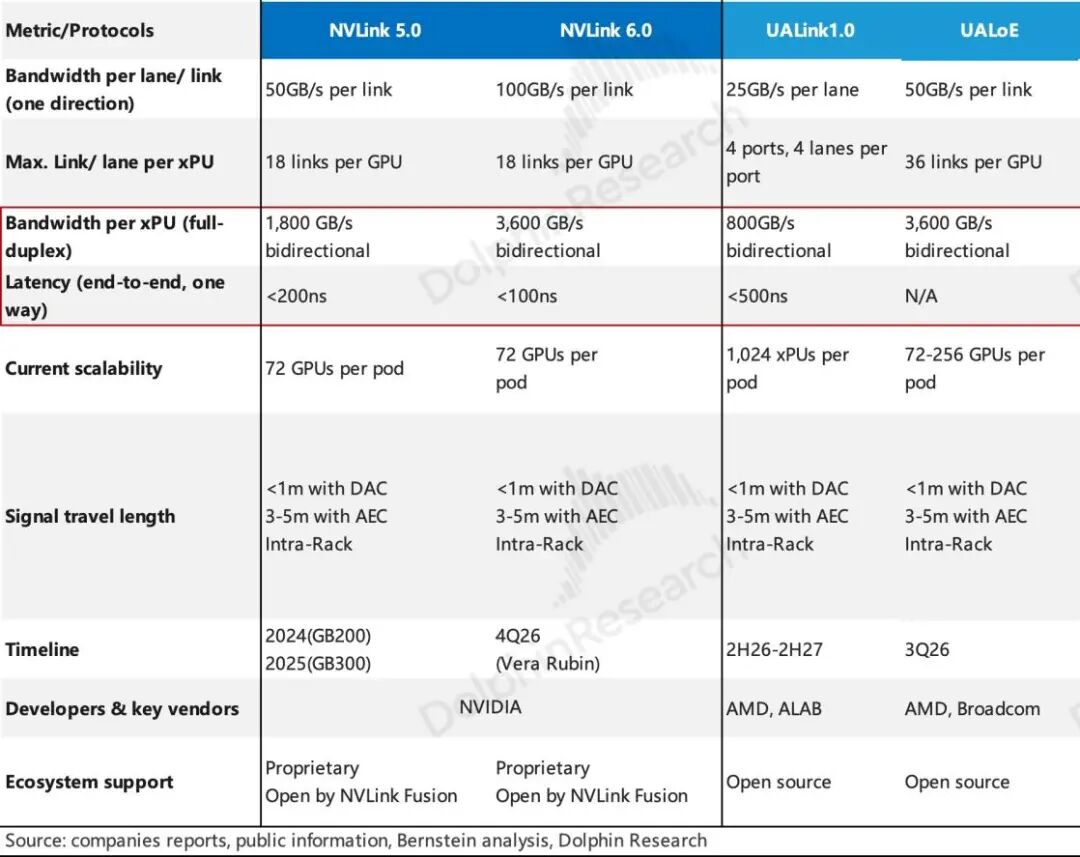
联盟声量大,缺乏硬件很尴尬。由于原生UALink标准的交换芯片仍在 ALAB 与 Marvell 处推进研发与量产,目前Helios方案的Scale-Up协议走的其实是UALoE(UALink over Ethernet),也就是架在以太网上的UALink来过渡。
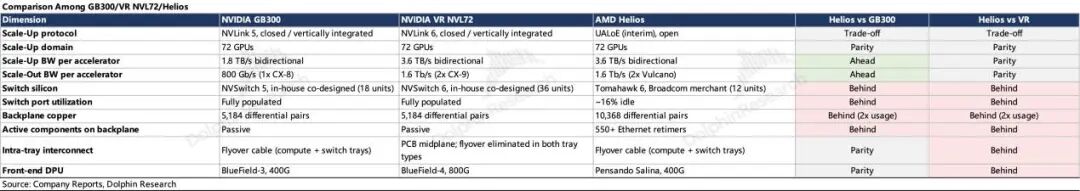
从下表可见,UALoE 的带宽已与 NVLink 6 持平。尽管延迟未披露,但海豚君认为难以匹敌 NVLink:UALoE 底层仍是以太网,数据传递时需在两套标准之间反复封装、解封,叠加以太网本身的转发开销。
1.2 Scale-Out: IB太贵又封闭,以太网胜
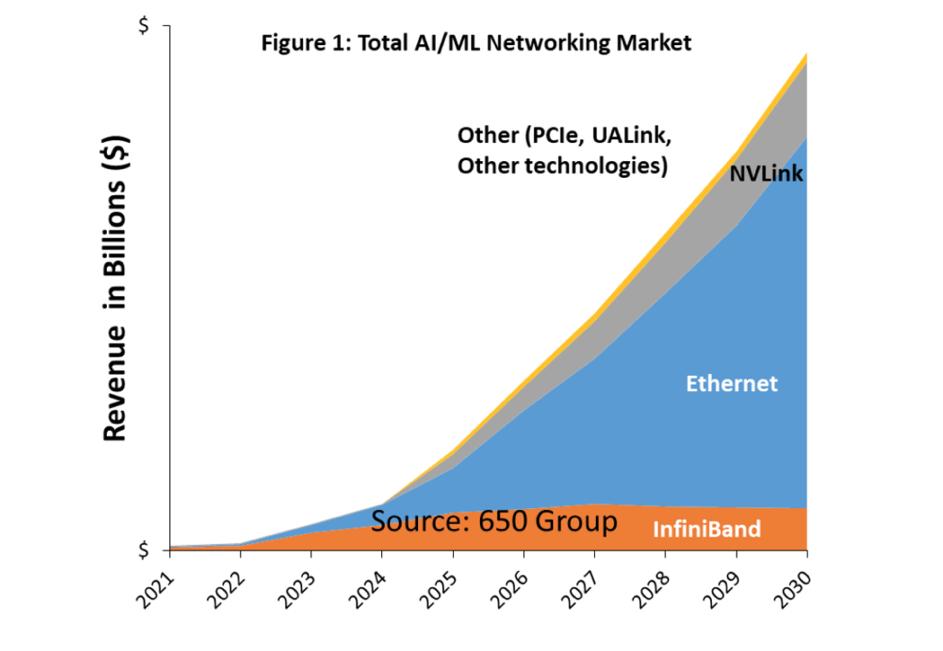
Scale-Out层格局相对清晰,竞争主要在英伟达主导的 InfiniBand 与开放生态的以太网之间展开,英伟达核心硬件是 Quantum交换机、ConnectX 网卡与 BlueField DPU。
如今市场的天平已明显偏向以太网。它本身就具备强兼容性、庞大生态、更低成本与更强扩展性;而随着各厂商纷纷加入以太网阵营(AMD 即为超以太网联盟U
二、组网方案:Helios,迟到的“错位”追赶
组网方案的竞赛,除了协议标准的生态站位,更是硬件按照协议一起组网之后,方案的部署规模与用户接受度。
这里我们重点拿3P市场上两家GPU玩家的组网方案,AMD Helios 和英伟达GB300 NVL72来做对比。
先来看代际差异:AMD的Helios 形态基本参照 GB300 NVL72,实际上市时竞对是GB的换代方案Vera Rubin机架。显然,Helios是在用竞对上一代的架构,打下一代的产品。因此比较时,海豚君重点拿Helios来比较GB300,再看Vera Rubin主要更新了哪些地方。
2.1 AMD:默默无闻的MI300时代
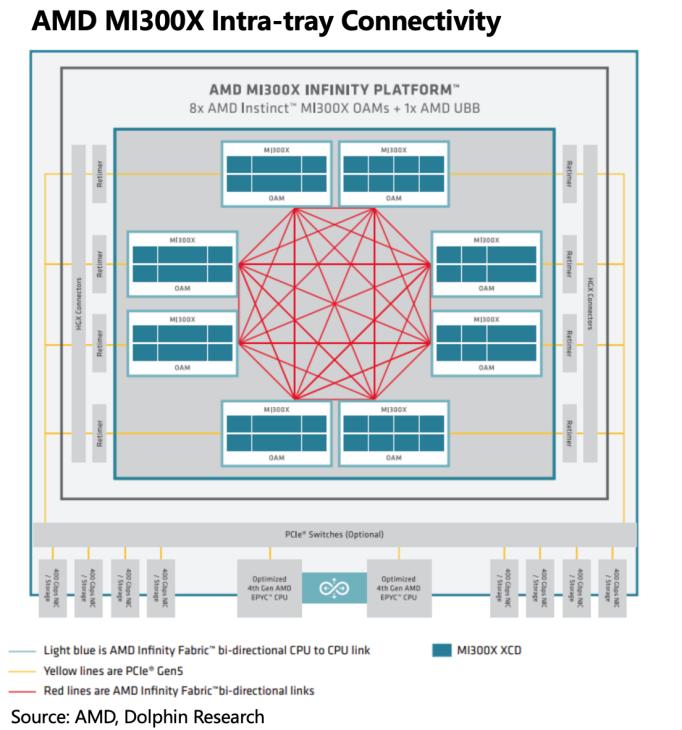
在Helios(MI450平台)之前,AMD以卖芯片MI300为主,GPU之间仅有简单的板内直连方案,缺少可以把几十个GPU直接互联的、像英伟达NV Switch一样的Scale-Up交换芯片。
短板很明显:GPU仅板内直连时,8 个GPU之间是直连的,但超过8张卡的GPU之间互联,就得跳出直连网络,走Scale-Out网络,带宽、延迟同步劣化。
这就是海豚君上篇说的,同一个办公室的同工种同事互传文件,八人之内可以做到两两互传。超过八个,就得走你传我,我再传他人,一直传到最终的人。
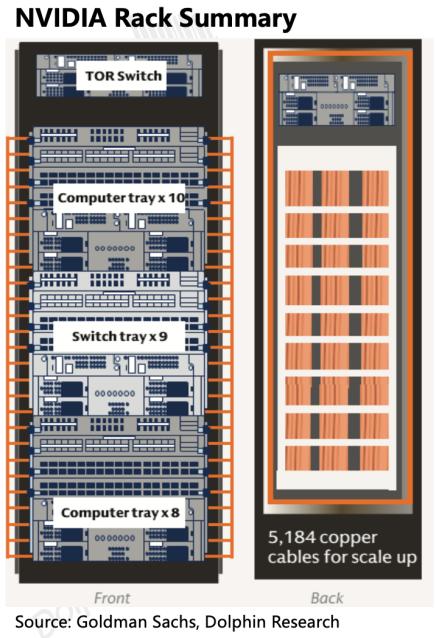
英伟达GB机架内,计算托盘(办公区)与交换托盘(调度室)组成机架(办公楼),用下图对比:可以看到机架正面,9 块交换托盘并非集中置于机架顶部或底部,而是夹在 18 块计算托盘中间。
相当于把调度室设在中间楼层,一个人要传资料的时候,只需要把资料放在中间调度层,调度解析之后,直接一键直投到目的收件人。72人范围内无阻沟通。
当下无论是训练还是推理,数万亿参数+MoE混合专家背景下,到底能集合多少GPU算力是核心竞争点。这直接导致AMD在MI300时代,与英伟达的GB方案完全没法打,尤其是在训练上差距过大。
MI300 打Grace Hopper还是GB,都无还手之力。因此,AMD直到出了对标英伟达GB300的Helios(MI450平台)机架方案,才算是有了上牌桌的可能。
除了CUDA生态上的强悍,海豚君这里重点说一下,英伟达组网上的一大杀手锏——用NVLink串起的GPU Scale-Up互联。
2.2 英伟达GB300关键差异——NVLink为核心的 GPU Scale-Up
英伟达在处理GPU互联时,为了打开互联片数的限制,直接在GPU之间引入了基于NVLink协议的交换芯片,同样命名为NVSwitch。
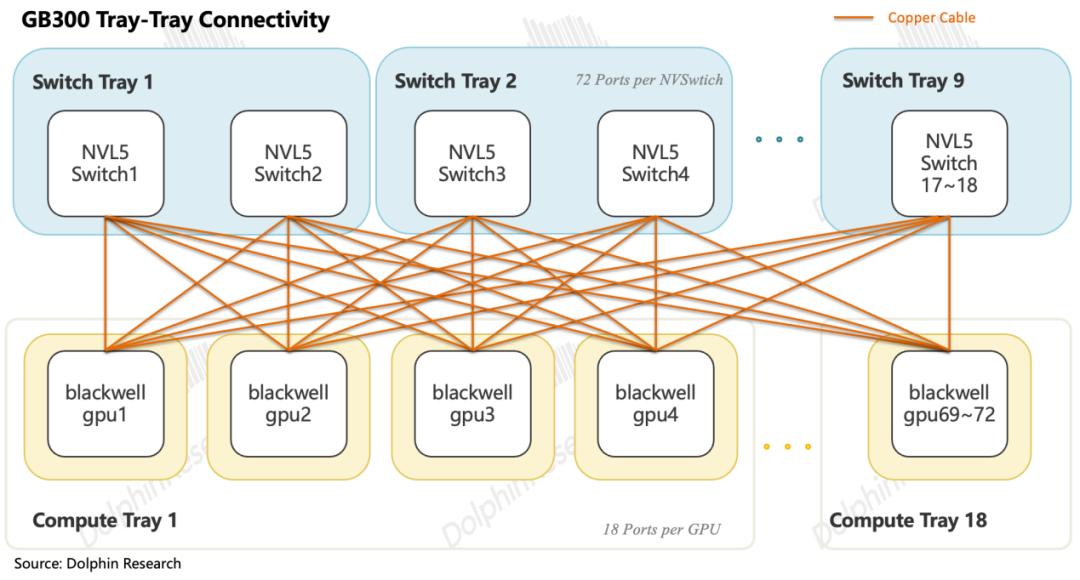
交换芯片的作用是,把18个计算托盘、每计算托盘内的4颗Blackwell GPU,全部通过NVSwitch连接起来。这72个GPU需要交换信息的时候,都各自把信息投给NVSwitch芯片,由这个交换芯片再一站转给另外一个GPU。
具体来看,一个英伟达GB300的结构,一共是18个计算托盘(72颗GPU,)上面10个、下面9个,中间夹着9个交换托盘(18颗NVSwitch 5交换芯片)。
每颗GPU引出18条链路,分别接入18颗NVLink 5的交换芯片。单GPU聚合双向带宽1.8TB/s;每颗NVSwitch 72端口,接满全部GPU,实现任意两颗GPU间单跳互通,无阻塞全互连。
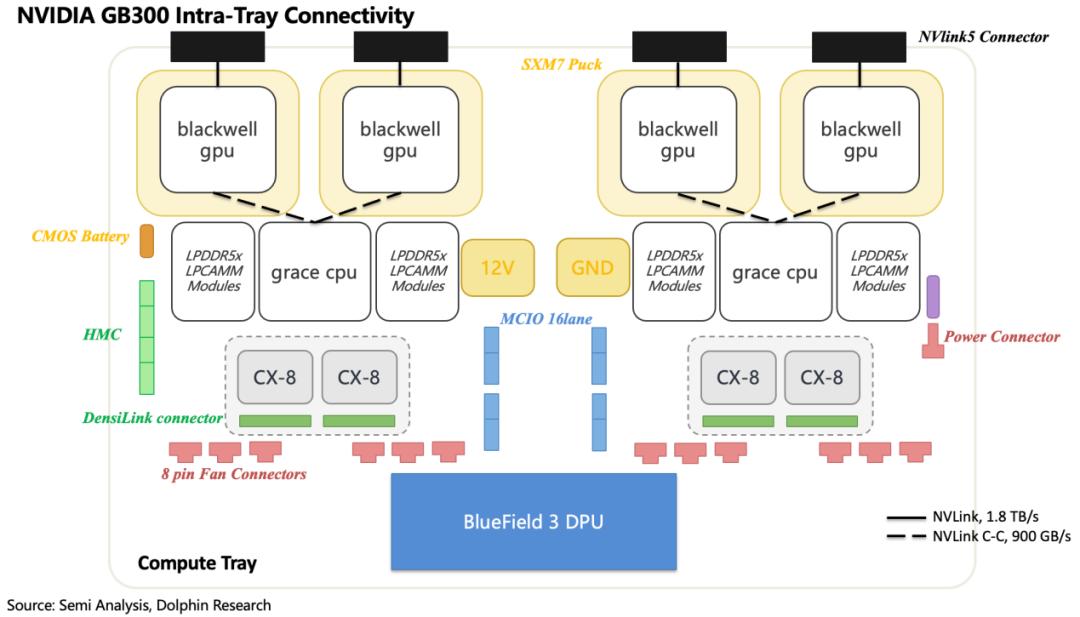
两个GPU之间,无论有多近,其实并不直接互联,而是先走托盘基盘,到托盘边沿的连接器,接上托盘背面的铜线再进入交换托盘(物理路径上是这样实现的:GPU → 托盘走线→托盘连接器 → 背板连接器 → 铜缆 → 交换托盘连接器 → 飞线 → NVSwitch ASIC)。
此外,单个托盘内有两个CPU,而CPU-GPU是用英伟达专属的NVLink C2C(通用方案往往走PCIe),双向带宽900GB/s。
2.3 AMD抄作业:抄了什么?像不像?
Helios在组网灵魂上与英伟达的GB300相似。引入了交换机来连接18个托盘里的72颗GPU,整机架6个交换托盘、12颗Switch ASIC,同样走铜缆背板。由于连接的交换机端口更多,单 GPU双向速度 3.6TB/s, 是GB300的两倍。
但方案实际落地上差异还是比较大:
a. 协议标准:GPU的Scale-Up确实引入了交换机,但协议标准,正如前文所说,不是自己严格意义上的UALink,而是走在以太网的UALoE。
b. 交换机硬件:第三方交换机标品。硬件上,用的是博通的交换机产品——Tomahawk 6,这个交换机属于标准品,普遍用途是Scale-Out,端口非常多,在Helios用于Scale-Up的时候,端口有剩余。
Helios单交换托盘 4 组连接器共 864 条通道、2 颗 TH6 各占 432 条,而单 TH6可用 512 条,约16%的交换容量因此闲置,而英伟达是全部接满的。
此外,由于在托盘内受制于较弱的SerDes能力,加装了以太网Retimer。同时拉高了成本、功耗与组装难度。
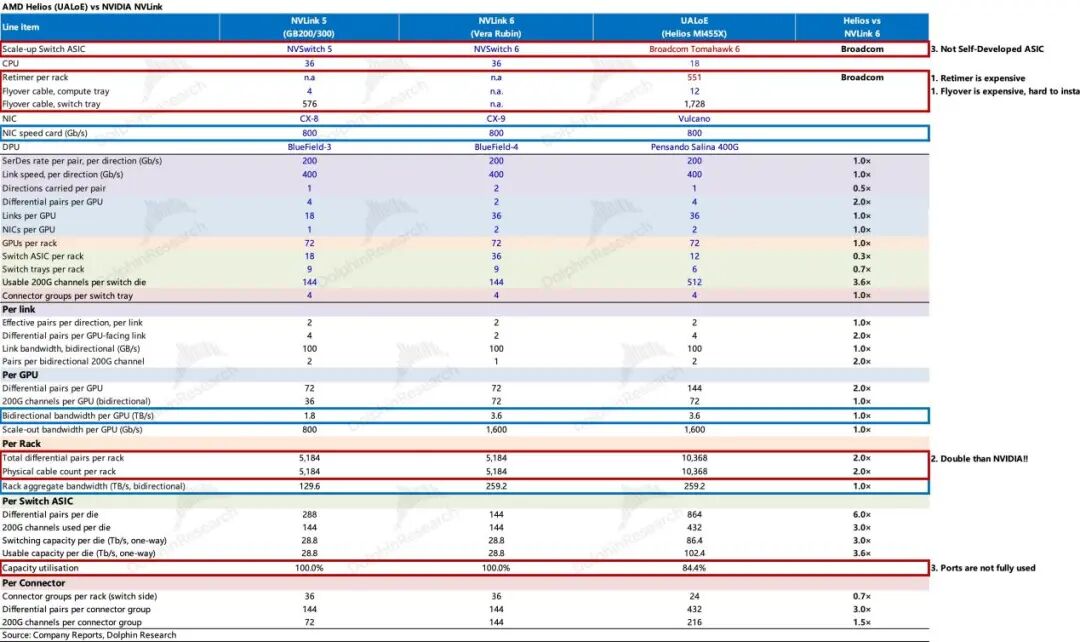
c. 2倍的铜缆用量:一共是10,368根铜缆,足足为英伟达两倍。差异来自于英伟达SerDes可以在同一对DP上同时收发。
d. 交换介质:铜飞线还在。连接器-Switch段保留了GB300设计中的飞线,增加了成本与维护风险。
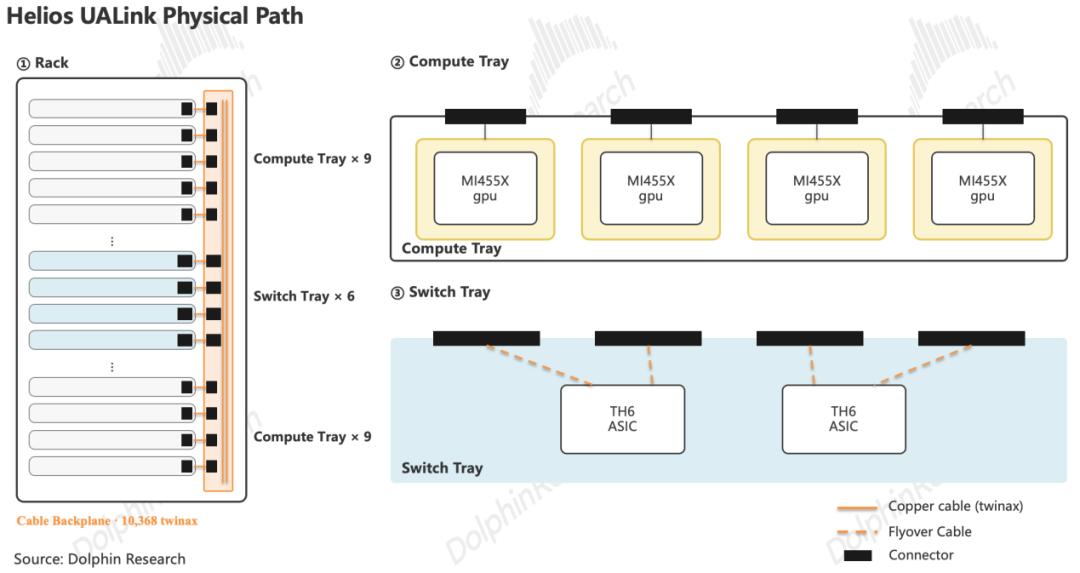
e. CPU配比低,CPU与GPU再次引入飞线连接:每个计算托盘配1颗Venice CPU、4颗MI455X GPU。CPU与GPU 配比由英伟达的 1:2 降为 1:4(核数比也是更低的)。
GPU因为距离CPU比较远,是通过飞线连接Venice CPU与Vulcano网卡,而不是英伟达的NVLink C2C的连接方式。
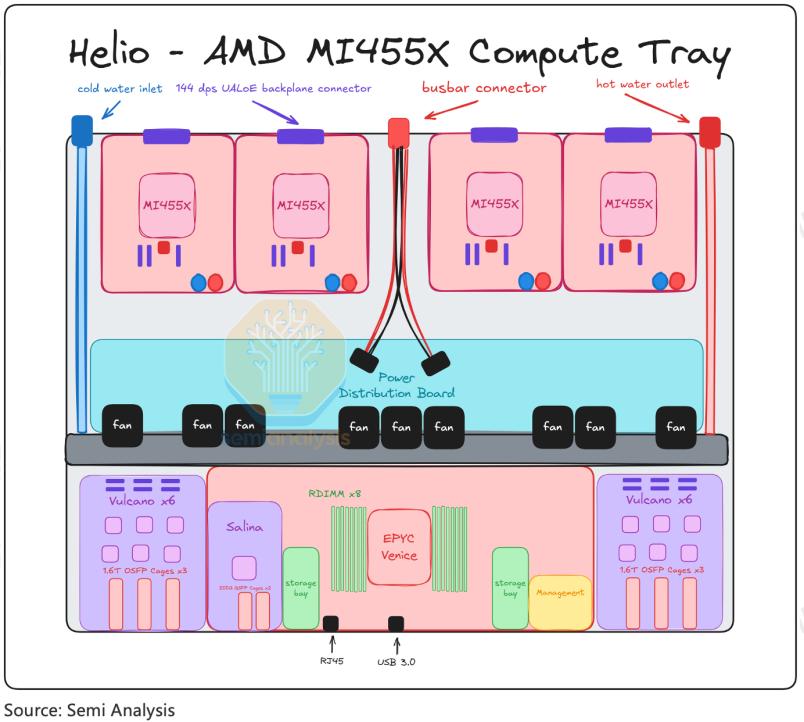
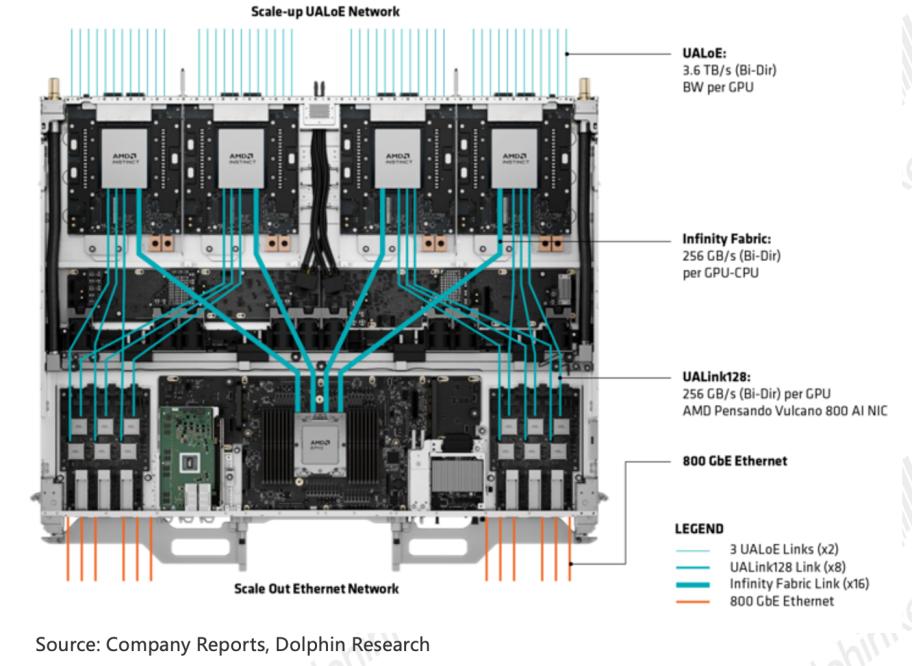
从下图的协议带宽看,海豚君推测AMD中CPU配比下降是因英伟达自研了NVLink C2C (1.8TB/s),CPU以及它所带的内存被纳入 GPU 一致性访问域,需要更高的配比支撑传输;而AMD的CPU-GPU走IF(仅256GB/s),CPU 可能只负责控制与调度,一颗即可覆盖4颗GPU。
2.4 Helios真正的同台竞品:Vera Rubin到底迭代了什么?
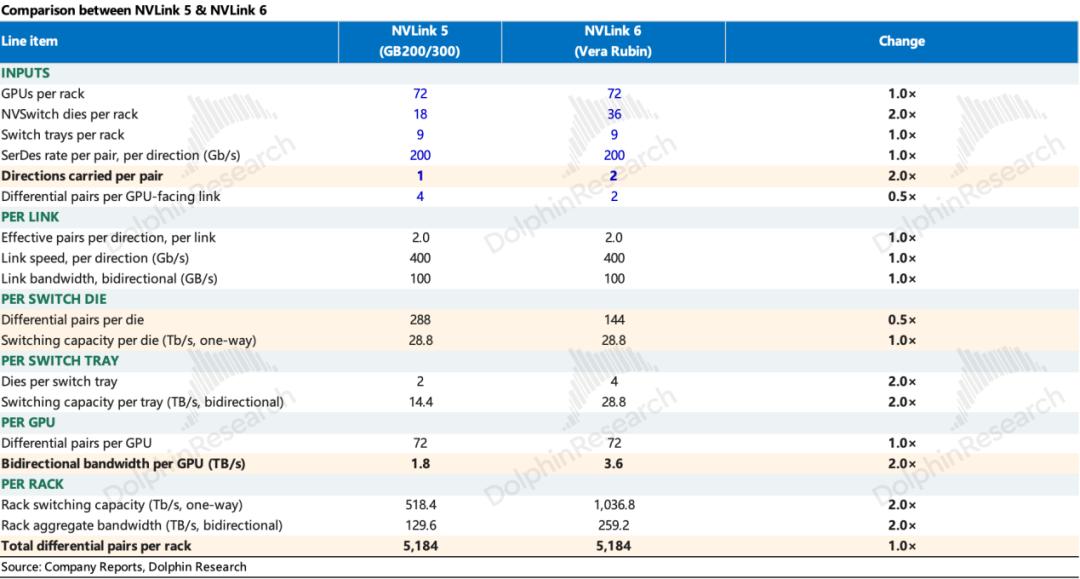
飞线是易耗品,容易坏,修起来比较麻烦。Vera Rubin主要的更新就是取消了飞线,交换芯片升级到了36颗NVLink6,把GPU之间的传输带宽拉到了3.6 TB/s;此外把CPU-GPU间NVLink C2C带宽翻倍至1.8TB/s。
关键是飞线是如何取消的呢?
GB300方案中,计算托盘以一块高度集成的PCB板为核心,GPU、CPU、LPDDR同板。信号出柜的路径是CPU→GPU→NIC网卡→OSFP(出柜接口)→Leaf交换机。其中,从NIC网卡到OSFP这一段走飞线(左图中蓝色虚线),是最容易故障的线路。
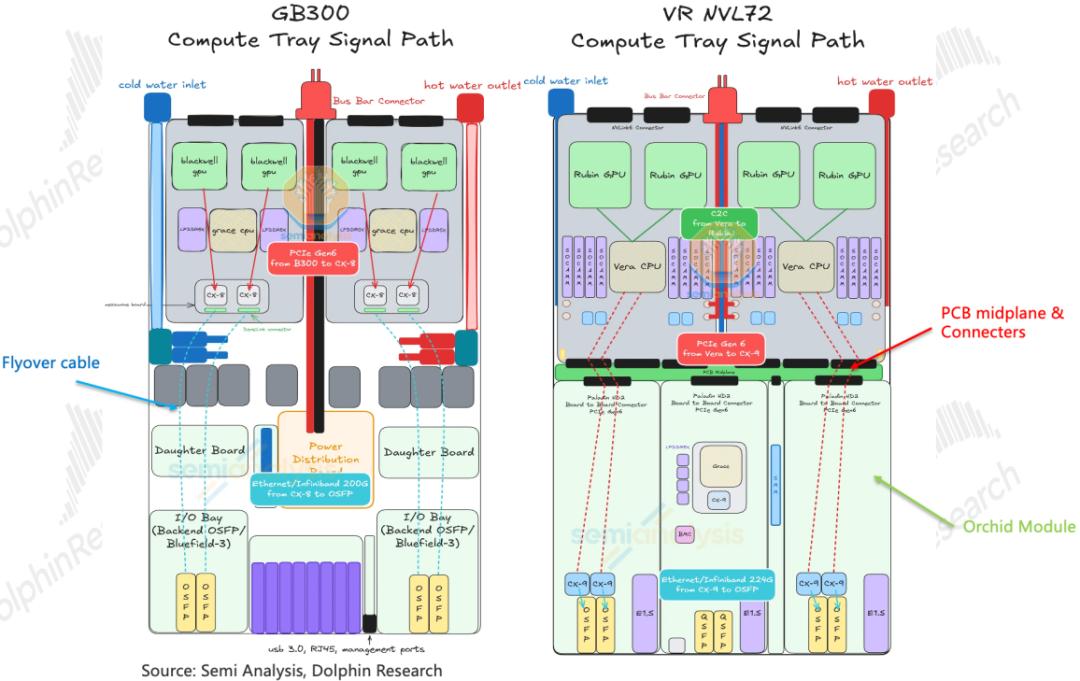
Vera Rubin的解法是将板卡模块化,如CPU和GPU组成计算模块,CX-9紧挨OSFP出口排列,一起做成独立网络通信模块Orchid。
几个独立功能的模块加上一块竖在中间的 PCB 中板,模块之间不再用线缆,而靠板与板连接器盲插对接(右图红色箭头)。易于维护、便于组装。
这样经过盲插对接后,全程是PCB走线。
PCB 上的长距离传输比飞线更易衰减,英伟达因此在配备高速 SerDes 之外,同步升级了 PCB 的材料、层数与面积。
可以看到,英伟达NVL72从GB系列到Vera Rubin,GPU连接方式不变,主要是模块化+PCB板+连接器,来取代飞线,降低组装时间,且容易维护。
而Helios是抄英伟达上一代的设计,通过高成本堆料的方式,拉高了可比参数值,但由于组件非定制、设计等各方面问题,实际成本更高。而同台竞技的是英伟达改良后的Vera Rubin产品。
2.5Scale-Out:没核心差异
该层级的组网方式较为简单,主要是硬件数量以及带宽的升级。我们结合前文Scale-Up的比较分析整理了方案的整体差异比对表。浅红底色的是AMD相较于英伟达落后的部分。
2.6 英伟达的下一代:Rubin Ultra又是一次大变革?
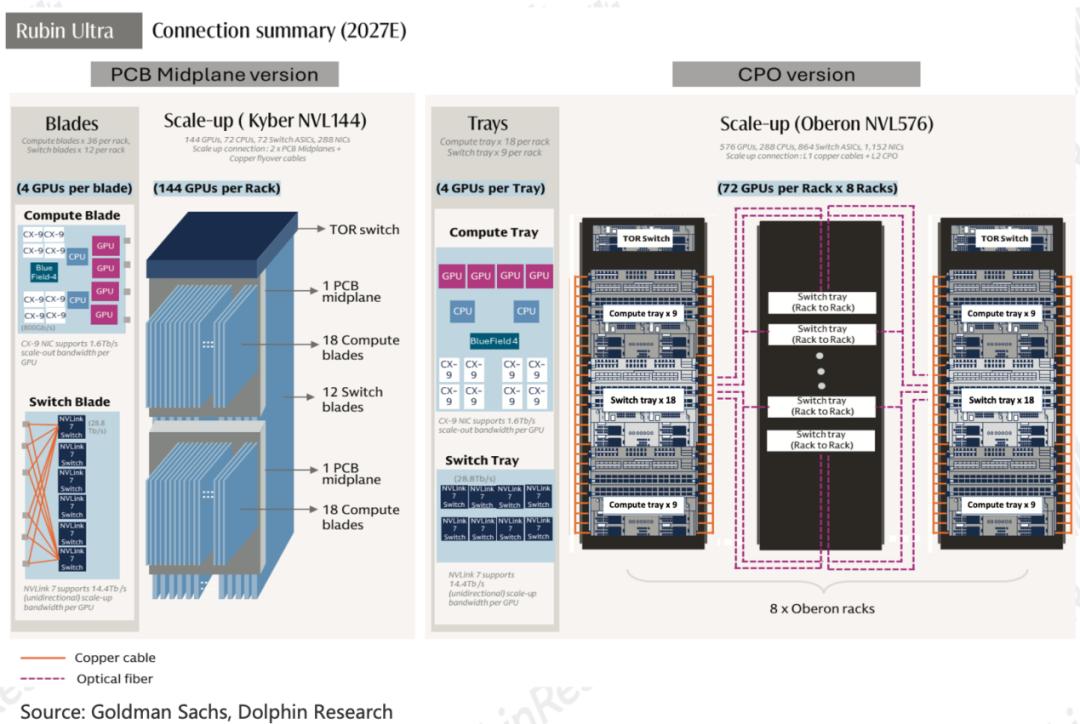
英伟达这边,Vera Rubin的下一代——Rubin Ultra 代际已经酝酿中,可能首次用光跨柜做Scale-Up。
目前,有两种机架形态——Kyber机架 vs传统Oberon机架,在同时考虑中。
a. Kyber 机架(NVL144,见下图左侧):形态重构
计算托盘改为刀片状(Blade),垂直安装在上下两块大型PCB中板的一侧。单刀片集成 4 颗 Rubin Ultra GPU 与 2 颗 Vera CPU,整机柜分 2 个 全功能模块(Canister),各含 18 块刀片,合计 36 块刀片、144 颗 GPU。
PCB中板另一侧交换芯片同步加量:每块交换刀片含 6 颗 NV Link 7 交换芯片,每机架 12 块,合计 72 颗。GPU 经 2 块 PCB 中板(每个 Canister一块)以全互连方式连至各交换刀片。这侧中板另插入管理模块。
b. Oberon 机架(上图右侧):沿用横置托盘
①机架内:布局由 Vera Rubin时,9个交换托盘在中间,上面放10个GPU托盘,下面放8个GPU托盘的10+9+8。
新方案改为 9+18+9。18 个计算托盘等分两组分布于机柜顶部与底部,NVLink 交换托盘翻倍至 18 个、单托盘高度压缩至 0.75U。目的是缩短最远计算托盘与最远交换托盘的间距,以保证铜背板上 NVLink 信号的链路驱动能力。
② 跨机架,用光互联拉高Scale-Up上限:8 个各装 72 颗GPU 的机架,首次引入Scale-Up CPO,做到8个机柜之间Load/Store内存语义的全互联,而非RDMA消息语义的Scale-Out。
三、小结:理论上了牌桌,实际万年备胎
整体而言,在最核心的带宽指标上,Helios无论Scale-Up还是Scale-Out都已基本追平英伟达的机架方案,单 GPU 双向 3.6TB/s 的 Scale-Up 带宽与 Vera Rubin 相当,Scale-Out 侧同样是 800G 网卡。对于下游客户而言,AMD已具备成为替代方案的基本资格。
但理论带宽追平并非全部。AMD 的差距集中在工程实现与自研全栈,沿用GB机架的落后设计直接推高了单机架的物料成本。
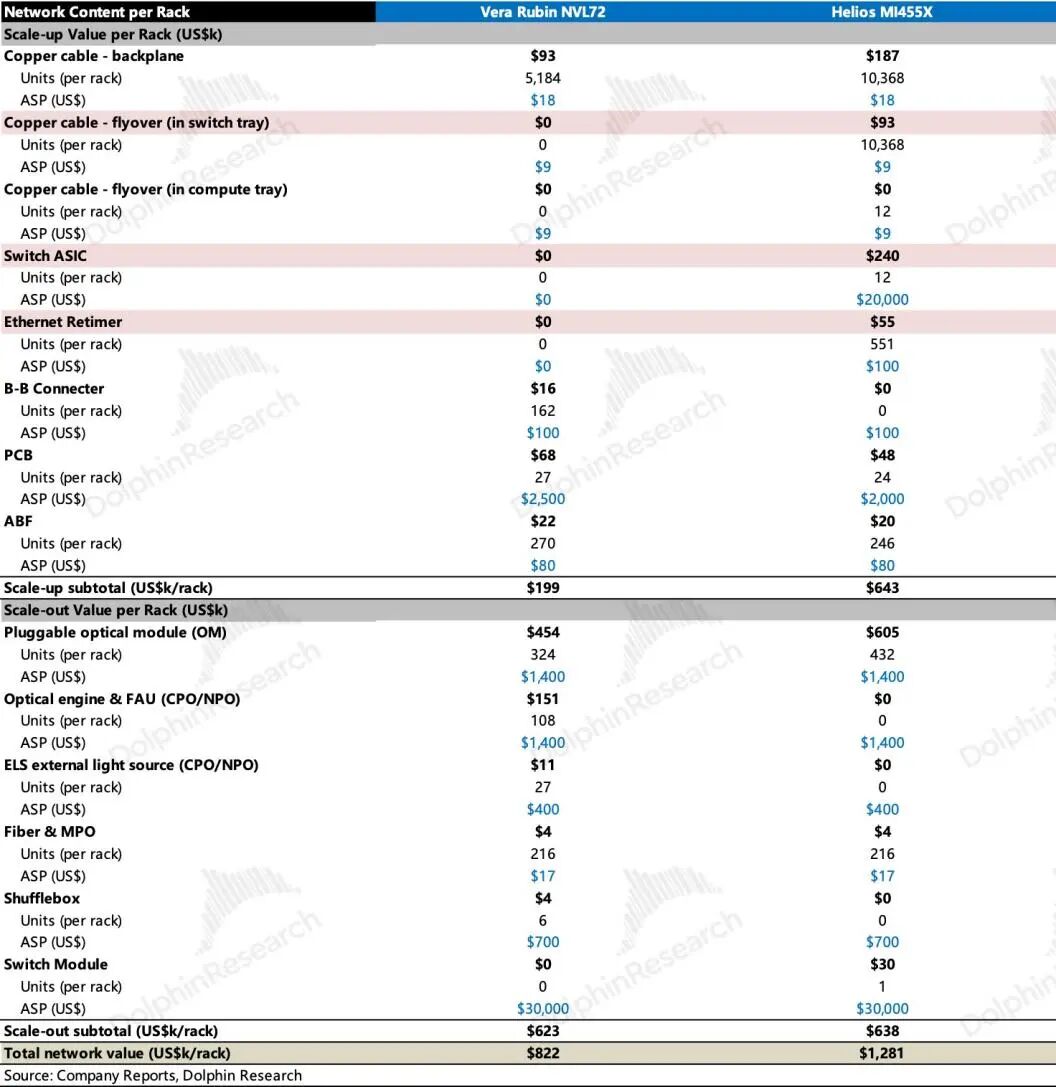
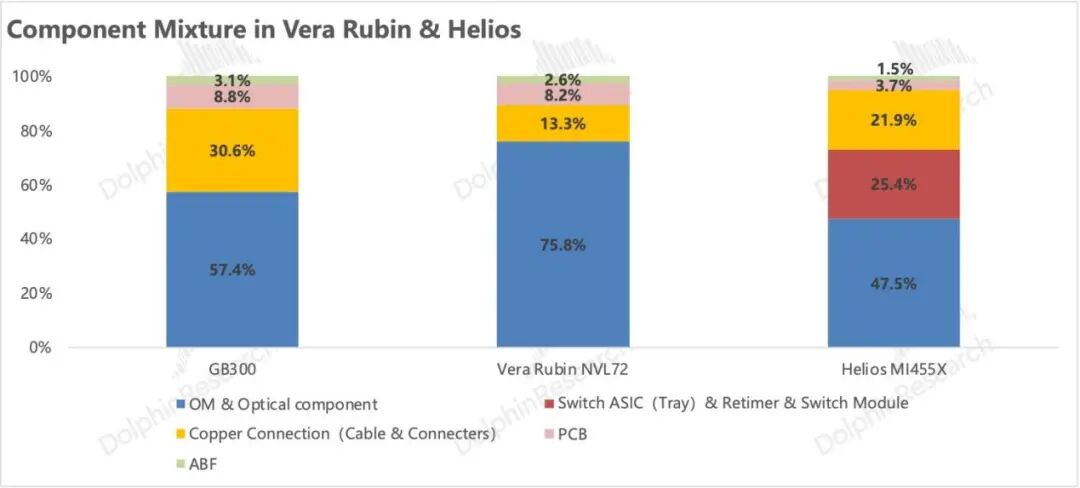
基于海豚君测算,两家厂商的单机架网络物理层的成本(外采口径),即便在英伟达 Scale-Out 侧计入了较为激进的 CPO 预期、从而抬高其成本的前提下,AMD 方案仍接近英伟达的两倍。
这一差距主要来自 Scale-Up 侧:翻倍的铜缆数、外采的交换芯片与Retimer占到了Helios Scale-Up网络成本的60%。
作为追赶者,AMD 面向客户显然会采取相对更低的定价(不考虑存储容量差异),而上文分析的差距将完全反映在其组网方案的毛利上。
Helios由于第三方组件使用较多,即使同样卖机架,它真正留存体内的收入是GPU(Instinct MI455X)+CPU(EPYC Venice)+网卡(Pensando Vulcano)的收入,其他多是低毛利转售业务。
回到机柜级组网竞争,AMD受制于原生UALink道阻且长以及组网上的跟进者策略,而英伟达的机架方案仍在快速迭代,其下一代机架方案物理形态或将发生变化。
AMD的方案与英伟达差距仍然明显。但在目前算力供给紧缺的情形下,这仍是AMD向上的出货周期,公司公开表示 2027 年的需求量已超出最初预期,将继续扩产。
四、产业链梳理:柜内模块化——板代线;柜外GPU加量——光代铜
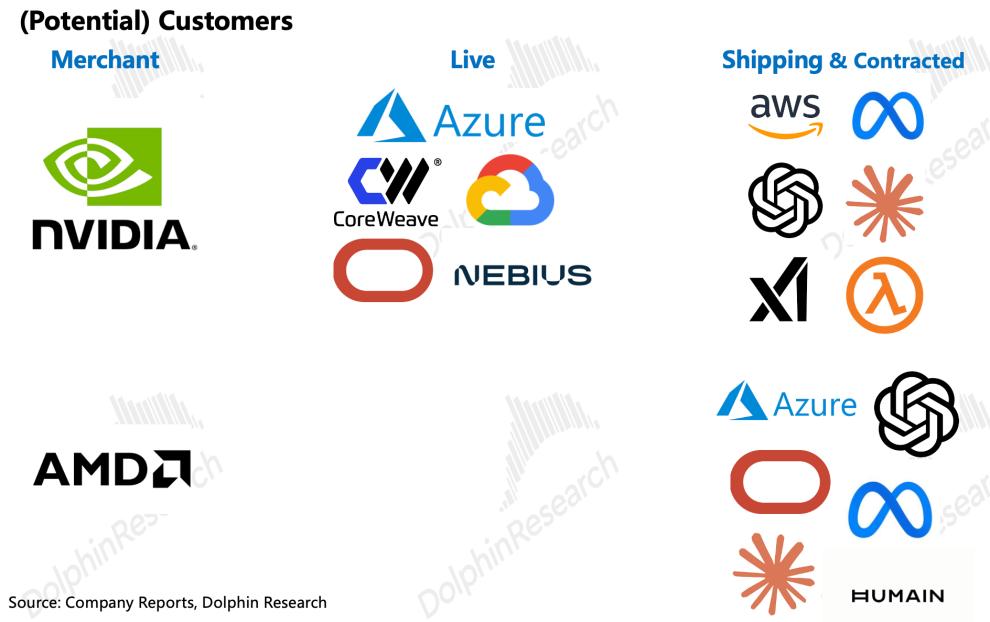
从目前在部署以及拿到订单的下游来看,Vera Rubin 规模发货8 月启动,且已拿到所有主要超大规模客户、AI 云厂商和系统 OEM 的采购订单,市场普遍预期4Q26放量。
Helios 7月下旬量产,首批发货在9月末。规模商业化落后约一个季度,大规模放量或要等到27上半年。
产业链上,AMD的公开信息较少,但前文可见两家机架的硬件规格已经接近(同为3.6TB/s、200G SerDes、铜缆背板加多层PCB),而后文将看到相关环节的竞争格局相对集中。
在基板、PCB、液冷、电源环节,供应链重合度高;差距主要是:①在交换芯片上AMD用的博通交换芯片;②整机组装环节,英伟达用鸿海、广达等,而AMD用Sanmina、Celestica与HPE等偏美链组装厂。
以下,海豚君主要从机架方案对比、迭代中,梳理网络互联供应商的价值变化。
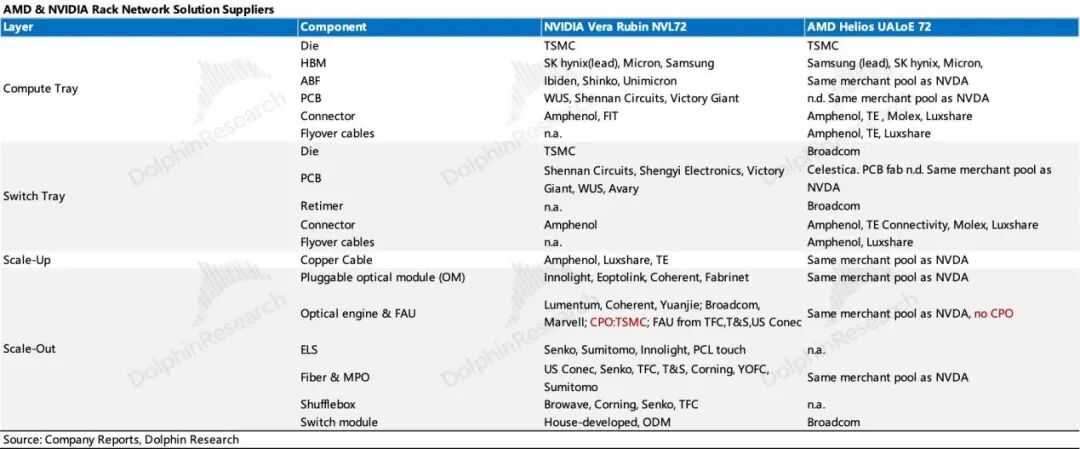
4.1 方案迭代几家欢喜几家愁?
a. AMD链:Helios使AMD从单板8卡推到跨板72卡,交换托盘和Scale-Up层是最直接的增量。
博通供应交换托盘的以太网Retimer、交换芯片;Amphenol提供从连接器到铜缆的整体方案,两者是直接受益标的。
长期来看,UALink原生芯片将由Marvell、ALAB供应,是对博通交换芯片的替代逻辑。另外,海豚君后续要看的谷歌方案,OCS交换机在设计初衷上就是博通叶、脊交换机的一种替代。
b. 英伟达链:铜退,PCB & 光进,连接结构升级
英伟达的机柜连接方案发生了以下两点关键变动:
一是取消了计算托盘与交换托盘的飞线;
二是PCB板的面积、强度都得到了提升。
物理成本测算参考下表,Vera Rubin方案的整体网络连接成本达到了GB方案的1.8倍左右,但同期单卡带宽翻倍,折算下来,单位带宽的网络成本反而下降约10%。
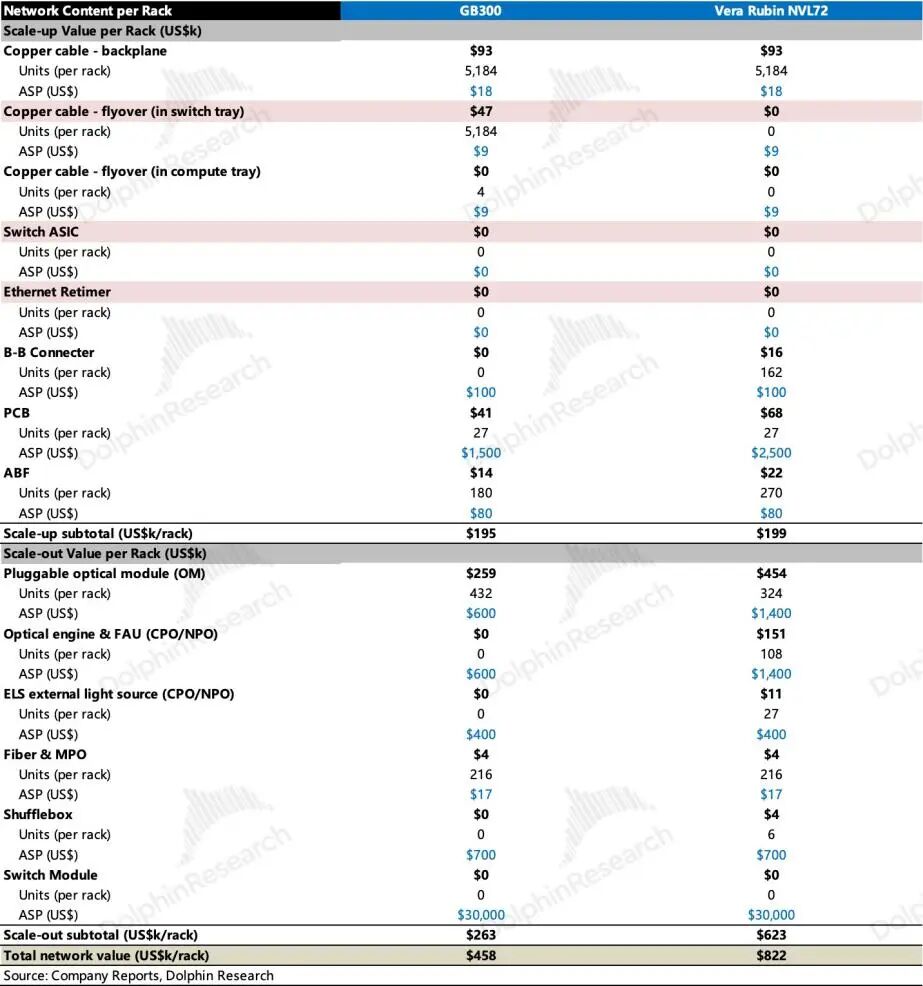
连接:安费诺Amphenol多空交错。飞线(无源铜缆)取消显然对Amphenol利空。但利好是:计算托盘内连接器的ASP相对更高,且接口数增量明显,一定程度上实现了对冲。背板铜缆方案(含连接器)仍然是Amphenol主供,整体安费诺偏中性。
PCB板存在量价齐升的逻辑。量上由更大的组网规模推动机架数量,价上是PCB板的技术升级迭代带来的层数与材料升级。在更长期视角下,Kyber机架将用PCB中板替代机柜内铜缆连接,继续利好PCB厂商,利空机柜铜连接。
4.2 连接产业链价值分配,谁高谁低?
我们按单机架物料测算,把全部网络物料归并为四个环节,价值量由高到低为:光连接(光模块以及光器件)>交换>铜连接(铜缆以及连接器)>PCB & ABF。
1) 光连接:非技术主导的供需错配涨价,持续性存疑
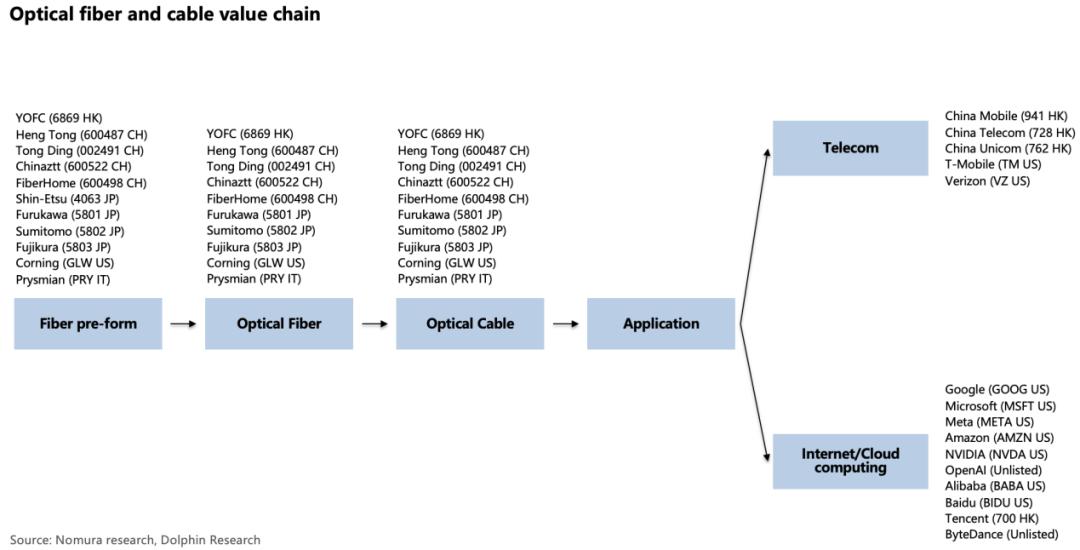
我们已经对单机柜价值量最高的光连接板块进行了深度覆盖,具体内容请参见技术演进、产业链梳理。此处补充光纤光缆产业链。
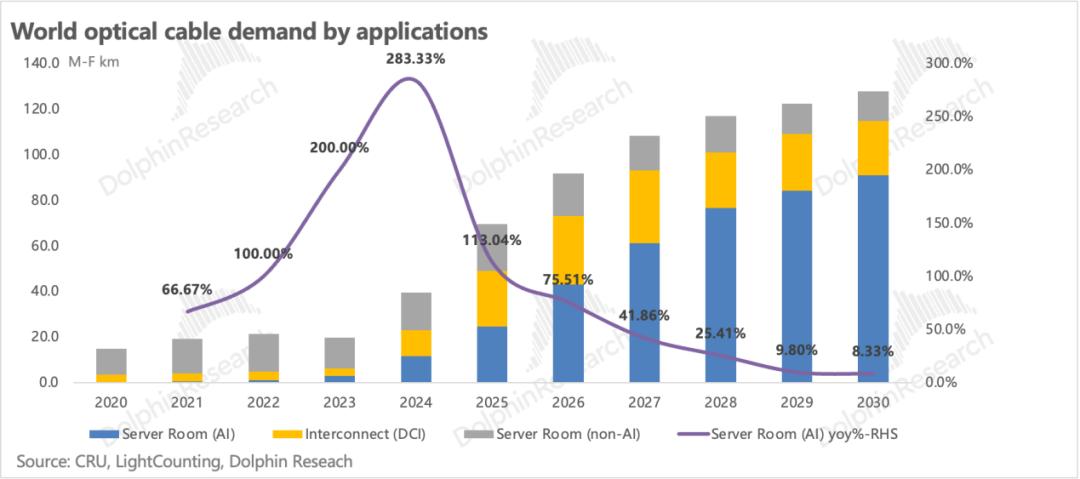
涨价来自供需错配。需求侧是AI集群规模扩张驱动的结构性量升;供给侧瓶颈在最上游的光纤预制棒——超高纯石英玻璃实心棒,决定光纤的光学DNA,用来拉制裸纤,再给裸纤套上“外衣”,就变成大家熟悉的光纤。
光纤预制棒,价值量最大、贡献了产业链近70%利润,对设备与工艺要求最高。
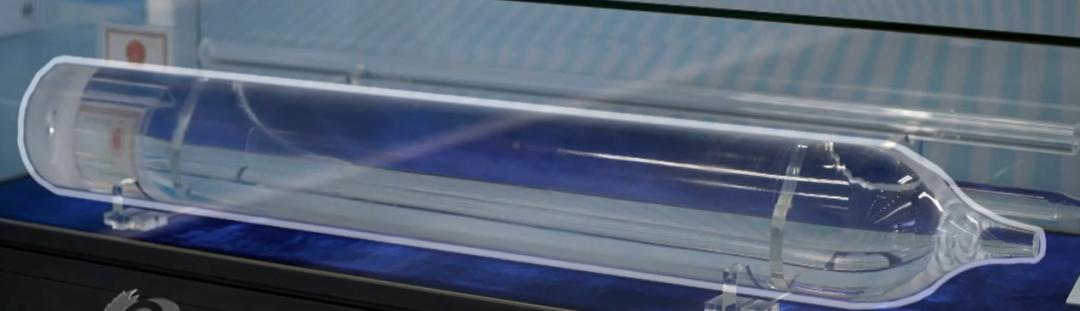
成熟产能由康宁、藤仓、长飞光纤等头部厂商主导,产能大部分不外售;存量玩家扩产谨慎,叠加18–24个月的扩产周期,供给较为刚性,缺口沿链向下传导,推动近一年的整体涨价。
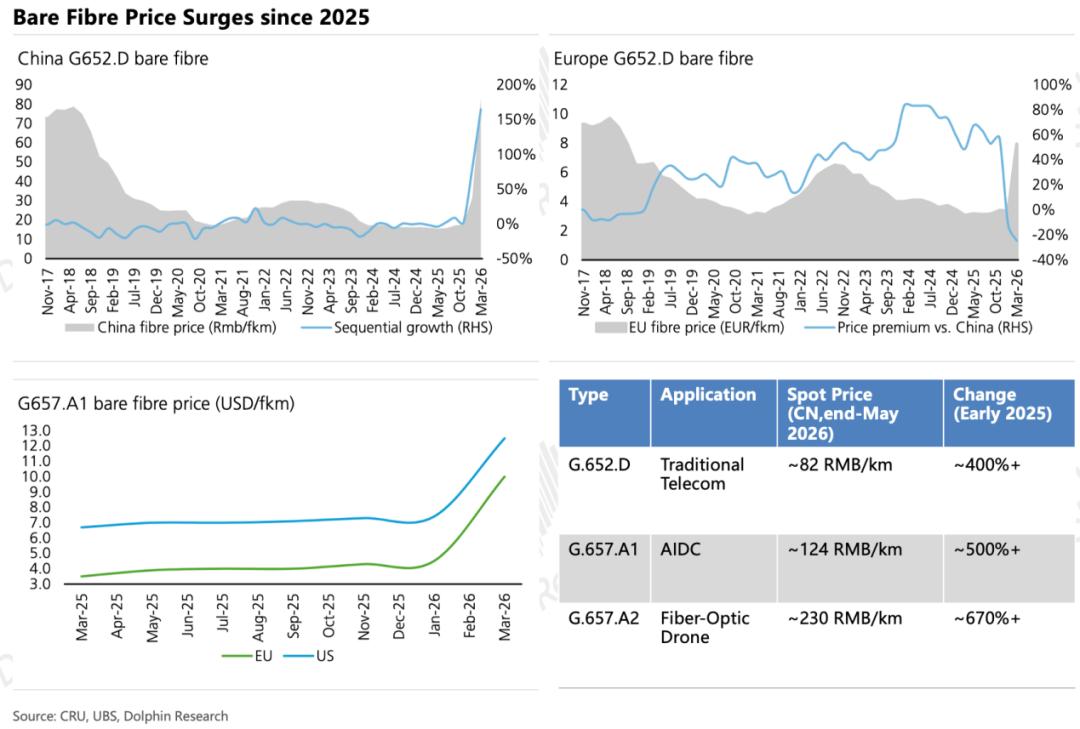
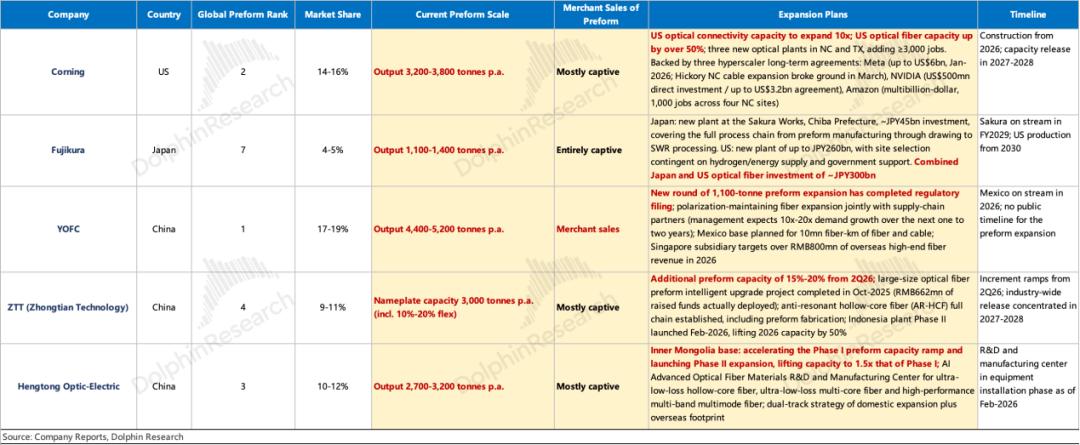
涨价持续性存疑。尽管此前普遍认为预制棒存在制造壁垒,但从新进玩家的扩产情况来看,大族激光(扩产2000吨)、合盛硅业(扩产3200吨)等已开始激进布局预制棒产能,预计27年下半年的产能落地。
另一方面,调研指出国内竞争已经加剧,截至6月数据,G.657.A现货价环比微升,G.652.D环比持平。新技术HCF(空心光纤,长飞光纤领先)目前仍处于商业化早期阶段(累计交付约占全年光纤需求的0.02%),相较CPO这类确定性极强的技术,其推动产业更新的逻辑更弱、涉及环节也更少。
这种技术壁垒有一些但不强的行业,需要考察垂直一体化能力。海豚君建议关注具备预制棒自有产能或全链条垂直整合的龙头企业,如长飞光纤,康宁,亨通光电等,有望在产能出清阶段以议价能力与成本优势胜出。
2) 交换:Scale-Up 走向自研,Scale-Out仍以采购为主
- Scale-Up层面,行业整体趋势是自研交换托盘内的交换芯片。这是为了与对应自研协议协同的理想解决方案,采取通用交换芯片的劣势已在前文方案对比中体现。
- Scale-Out层面则多采购。在我们下一篇对CSP连接方案的行业深度中会看到,尽管CSP在各个环节开启自研,但是高端交换芯片上仍以博通、Marvell、英伟达方案为主,可见SerDes IP、协议协同设计与软件栈形成的壁垒较为稳固。
交换芯片是交换机产业链中技术壁垒与价值量最高的环节。根据Bernstein测算,交换芯片在整个交换机模组中的价值量高达30%,也因此形成了高度集中的竞争格局。市场约70%的份额由博通主导,Marvell与英伟达分别占据约15%与10%。
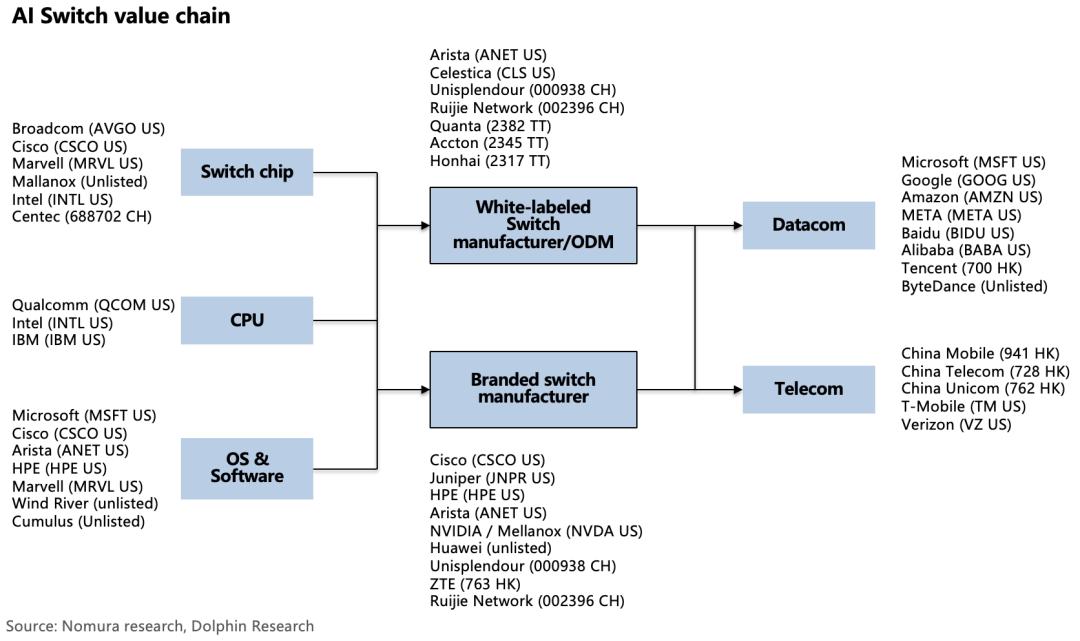
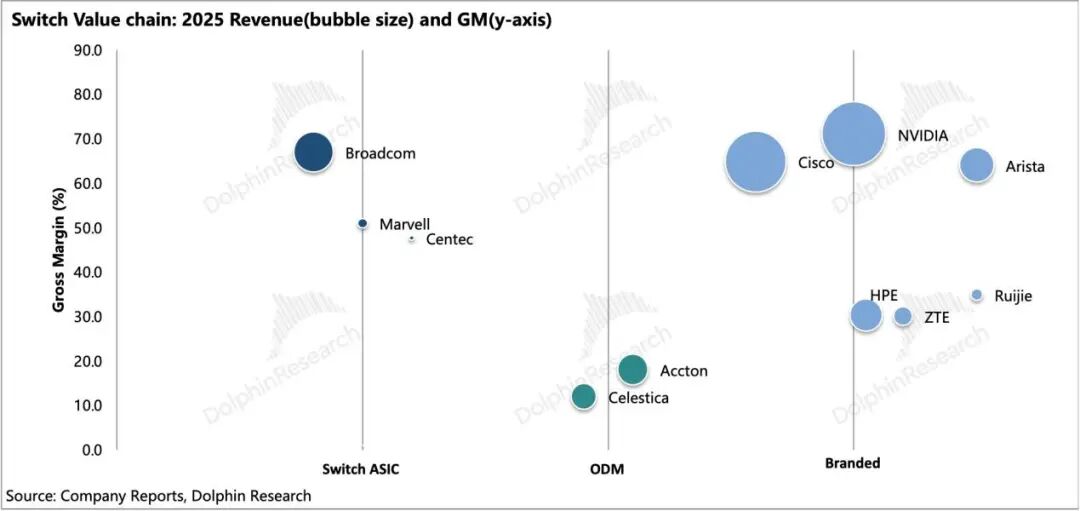
交换芯片的毛利率约50-70%,领先地位的品牌交换机厂商(Arista、Cisco、英伟达)毛利水平超60%,显著高于白牌ODM交换机的10%-20%。因此建议选择高端芯片与品牌交换机享受定价权的厂商:博通、Marvell、Cisco、NVIDIA、Arista。
3) 铜连接
英伟达与AMD的背板铜连接以DAC为主,其受限的物理距离极限并不适用于跨机架的Scale-Up连接方案。而A
4) PCB & ABF
a. PCB/HDI:材料卡在日系,价值落在高层板
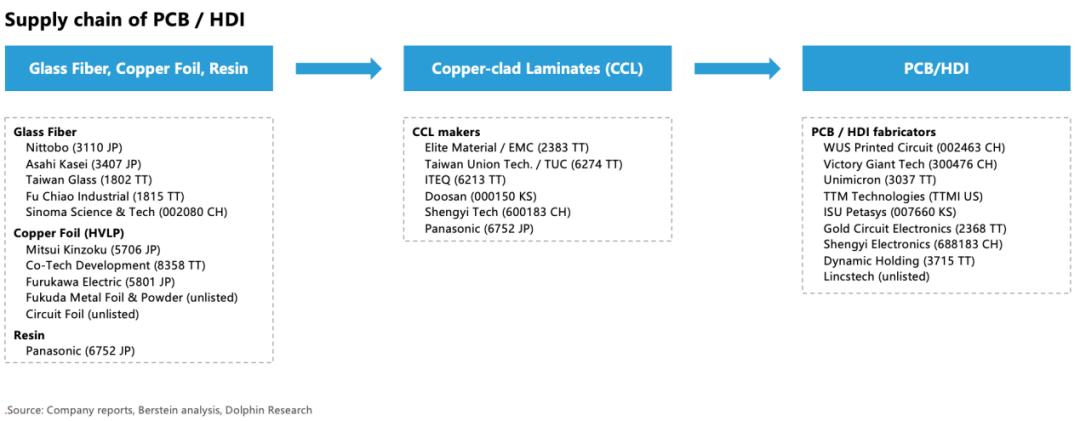
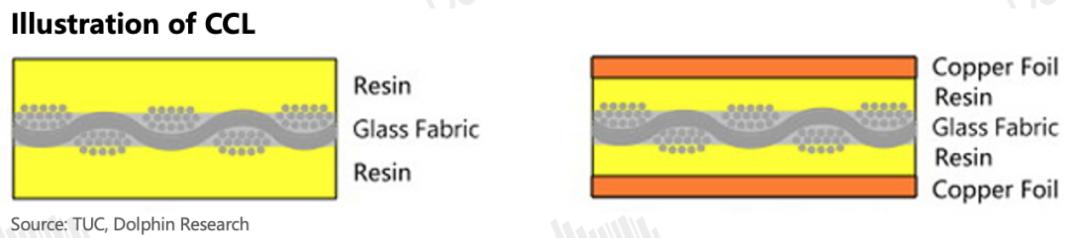
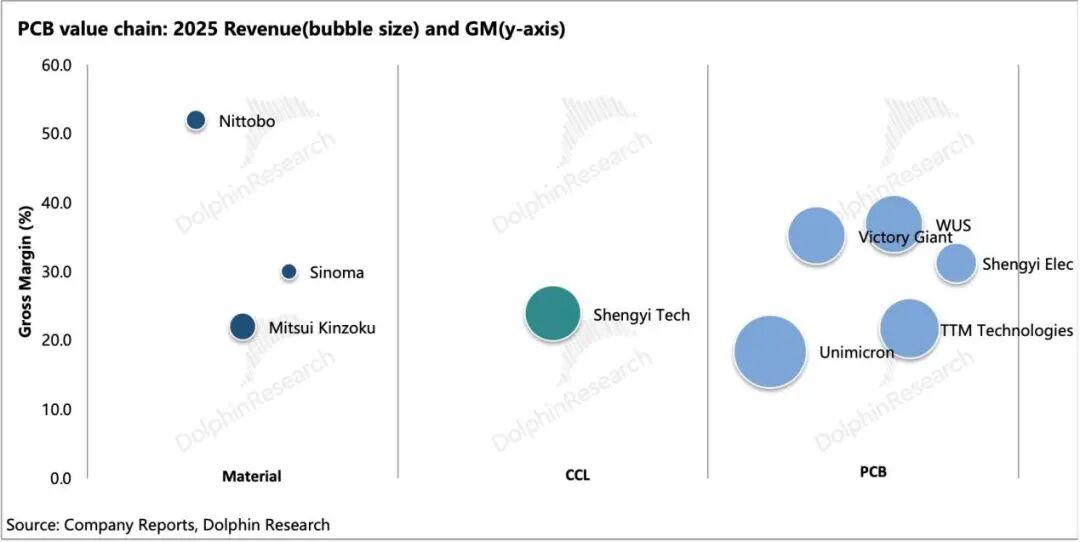
PCB/HDI 的核心是覆铜板(CCL):CCL 约占 PCB 成本的 30%,而 CCL 自身成本又高度集中在三种上游材料——铜箔约 40%、树脂与玻纤布各约 25%。
PCB 厂商的成本与议价能力,由上游两种高端材料决定:玻纤布与铜箔。
VR 代际把 NVLink 飞线全部换成 PCB 走线,板上长距离传输要求极低的介电损耗(Dk 决定时延、Df 决定损耗)与极光滑的铜箔表面。因此这一代必须采用Low Dk/Df 玻纤布与HVLP(高频超低粗糙度)铜箔。这两种材料的供应较为集中:
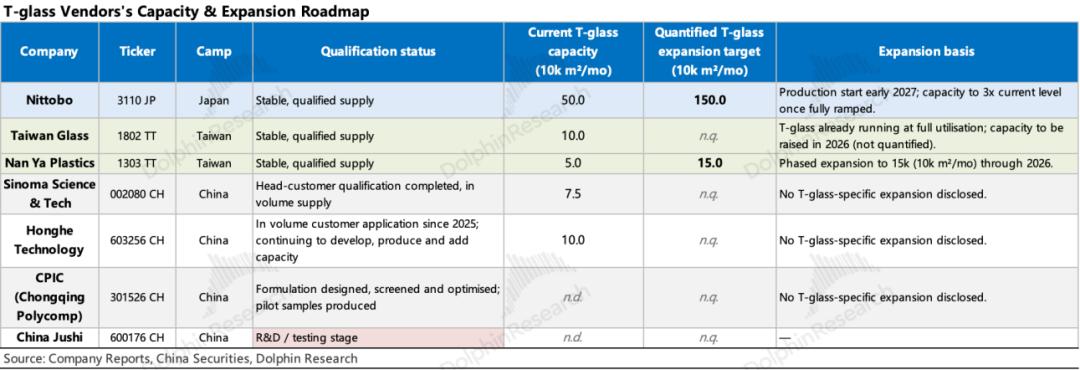
- 三代低介电玻纤布由日东纺与 AGC 垄断;二代布(性能次于三代布)国产替代进行中,但主要出货仍依赖日东纺、AGC、台玻;
- HVLP4/5 级别(级别越高,性能愈佳)铜箔中,三井金属份额超过 80%。
制造端,市场普遍预期Rubin Ultra 背板达 78 层或以上,其供应商胜宏科技已具备 70 层以上量产能力、100 层以上技术储备,深南电路量产 68 层、储备 120 层。
上游虽紧,但产业链各环节的毛利基本稳定在30–40%,说明涨价或许能够沿链传导,上游并未独占增量。
建议关注具备高层板量产能力的龙头:胜宏科技、深南电路。
b. ABF载板:日台垄断
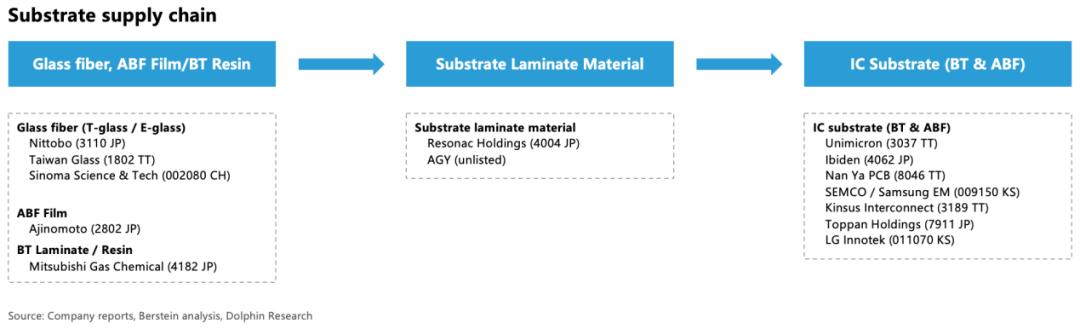
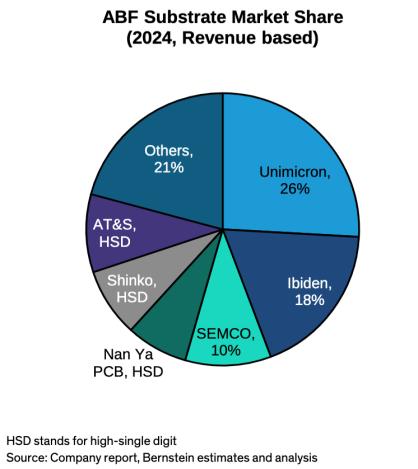
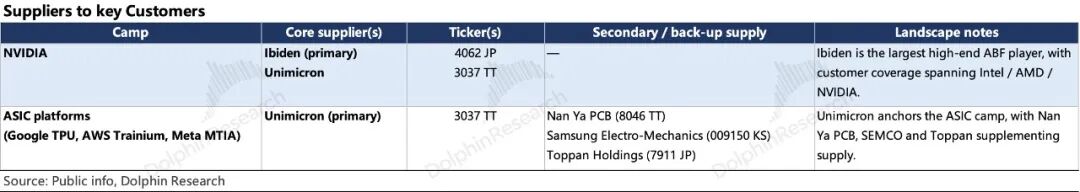
目前,该市场集中度较高,前三大玩家 (Ibiden揖斐电, Unimicron欣兴电子, SEMCO三星电机) 占据超50%的市场份额。
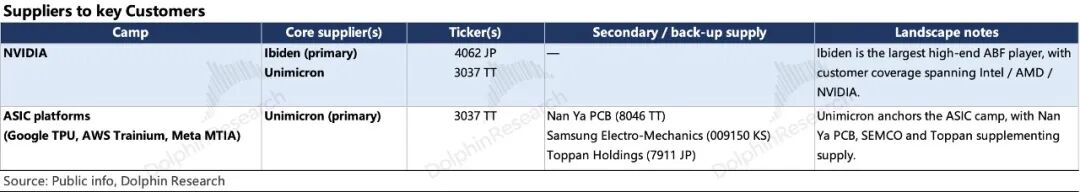
上游材料方面基本被日本厂商垄断。
- T-glass(低CTE玻璃纤维):日东纺以近90%的全球份额基本垄断。
- ABF增层膜:味之素市占率95–98%,月产能超200万平方米,2026年二季度已满产,新产能要到2030–2032年才逐步落地,短期供给刚性。
后续对比谷歌、AWS与华为等大厂的组网方案差异后,海豚君会挑出产业链上的核心资产,逐一跟踪,敬请关注!
本文来自微信公众号“海豚投研”(ID:haituntouyan),作者:海豚君,36氪经授权发布。
















