AI 的下一次突破在哪里?|AI CLOUD 100 CHINA 2026 · 主论坛对话精选
10月16日,第五届 AI Cloud 100 China 榜单发布暨 CEO 大会在上海静安圆满举行,900余位观众到场。来自 AI 产业、科研与投资领域的嘉宾齐聚一堂,从前沿技术到产业应用,从创业实践到全球市场,展开深入交流。
主论坛围绕下一次 AI 突破展开讨论;硅谷、香港、赛道及互动分会场,则从湾区创业与跨境协同、香港发展资源、不同技术方向与产品实践等角度延伸议题。展区体验与现场交流热烈,讨论持续至深夜。
其中,主论坛对话“Where Will the Next AI Breakthrough Come From?”聚焦持续学习、世界模型、行业模型与自动化研究。靖亚资本创始合伙人何沛与四位一线探索者共同讨论:AI 的下一步,究竟会突破什么?
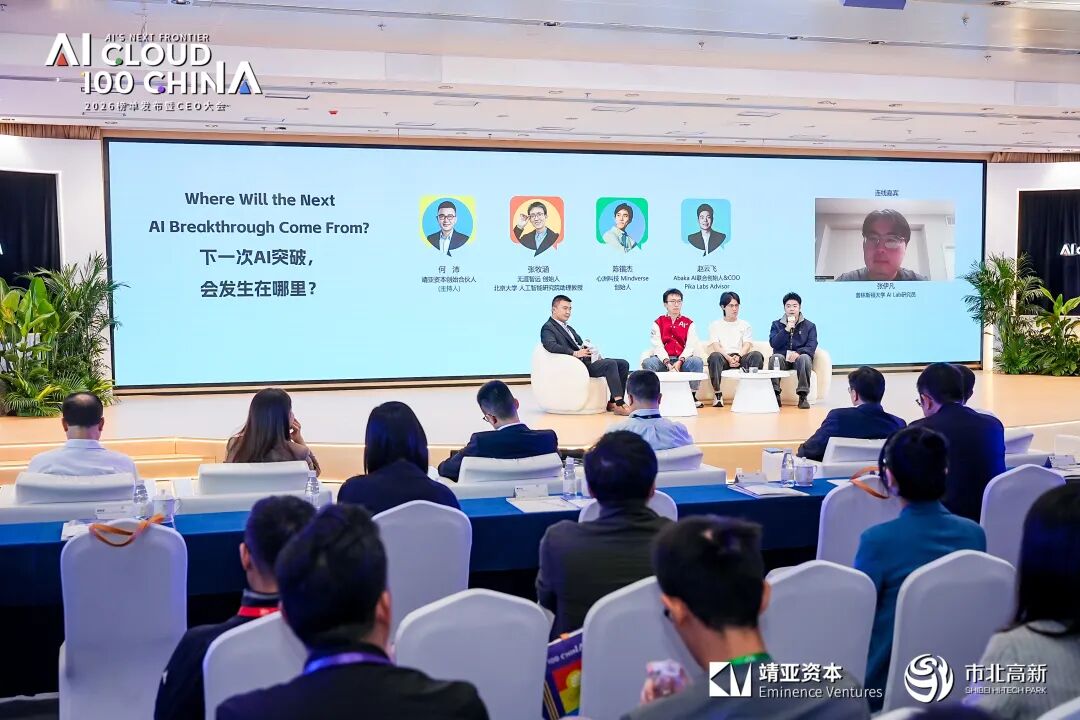
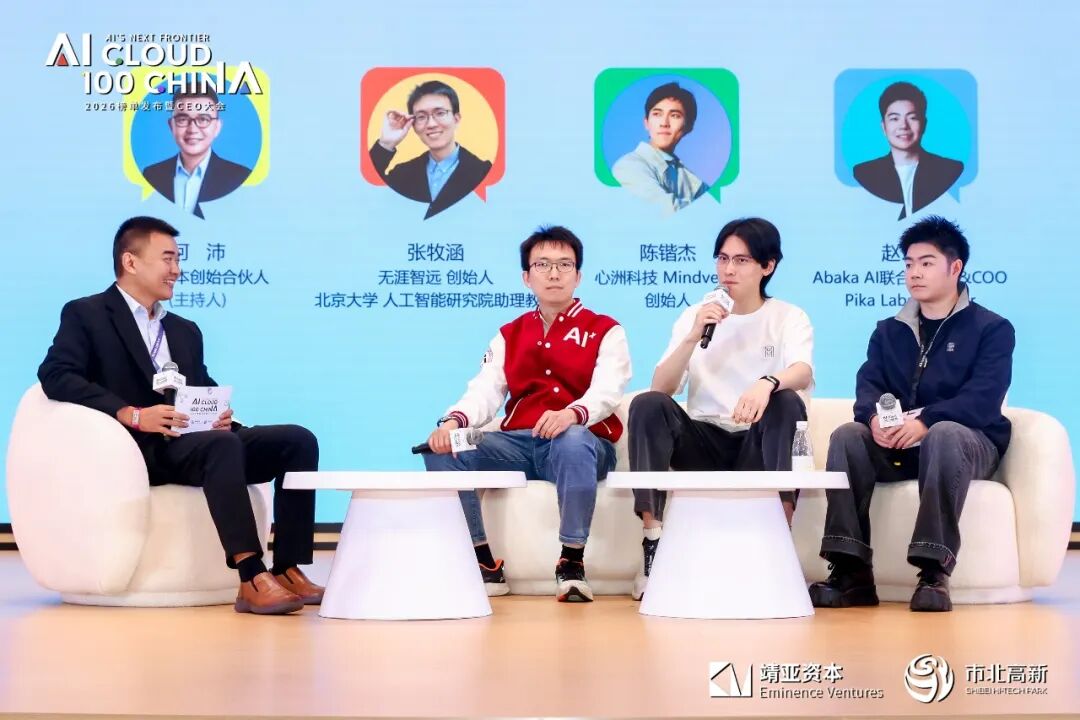
对话嘉宾包括无涯智远创始人、北京大学人工智能研究院助理教授张牧涵,心洲科技 Mindverse 创始人陈锴杰,Abaka AI 联合创始人兼 COO 赵云飞,以及远程参与的普林斯顿大学 AI Lab 研究员张伊凡。以下为对话精选,依据现场实录精简整理。
01 / 从“记住资料”到真正学会
何沛:张老师,你提出 AI 需要持续学习。大家现在讲长上下文、各种各样的记忆系统,这些不能解决问题吗?你看到的问题是什么?
张牧涵:现在一个 AI 系统里,有模型架构与参数本身,也有上下文。前者定义模型是什么,后者决定这次推理依赖什么。我们认为,光靠上下文推理,没有办法解决模型持续学习的问题。
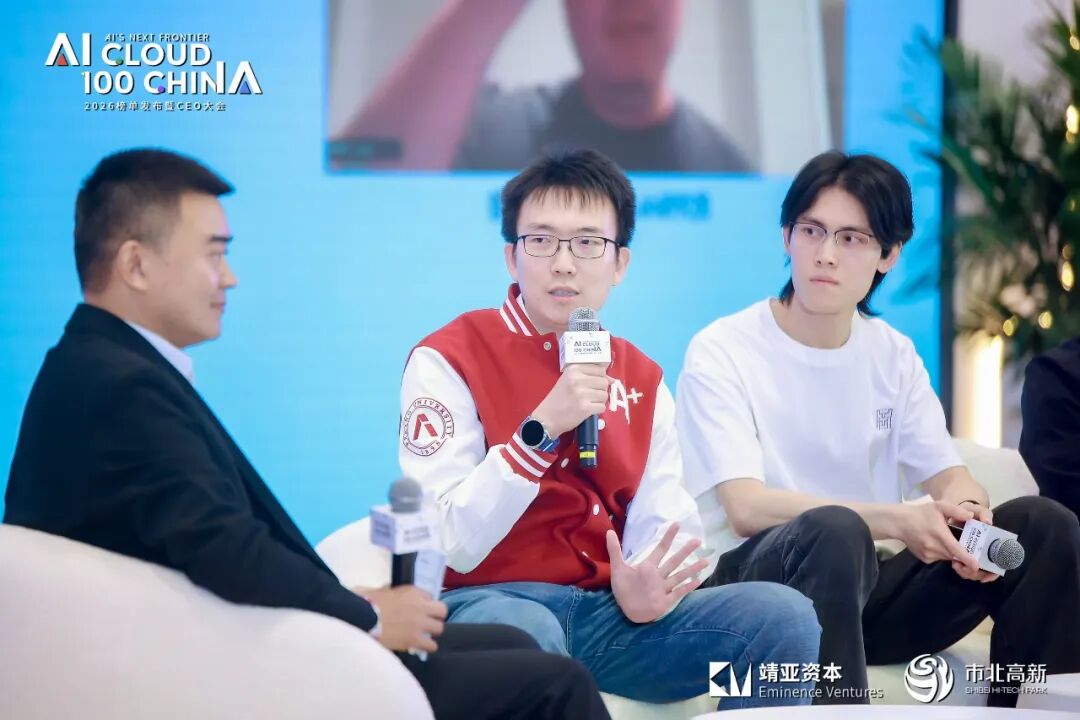
上下文窗口一直在变大,但它有计算和存储成本,也需要足够的长文本数据来训练,不可能无限扩充。这让我想到一个类比:上下文推理很像人的短期工作记忆。换一个新的对话,如果之前的信息没有被带进来,它就不再参与这次推理。
但人并不是只有短期记忆。我们会不断把短期工作记忆变成长期记忆,巩固经验、增加能力。对模型来说,我们想探索的就是参数这一层:让模型能够修改自己的参数,持续进化。
我们公司的名字“无涯智远”,取自“吾生也有涯,而知也无涯”。我们希望未来的模型不是出厂之后就保持不变,而是在实际工作中继续学习。
何沛:有点像人参加培训之后的内化,不能学过就忘了。但这里有一个问题:你基于某个版本的基模持续学习,半年、一年后,基模出了新版本,之前学到的东西还能迁移过去吗?
张牧涵:如果采取传统的反向传播训练,成本会很高,相当于重新训练一遍,参数不能直接迁移到下一版。我们希望在持续学习上取得突破,让参数改变的成本足够低、速度足够快,再把过去形成的知识快速转化为新基模的参数增量。
何沛:从记住资料到学习内化,你觉得最难的槛是什么?
张牧涵:就是模型如何快速内化新知识、新技能、新经验。我觉得这是下一代模型的突破点。我们已经有一些初步的技术突破,看到了一些很有希望的进展。
02 / 数据公司的护城河,是提前知道模型需要什么
何沛:前沿模型公司为什么要向第三方采购数据?现在需要什么样的数据,解决什么问题?
赵云飞:如果把 AI 生态比作一个厨房,我们有点像切墩的那一位:把菜从地里拔出来,洗干净、切好,再交给训练模型的“厨师”。
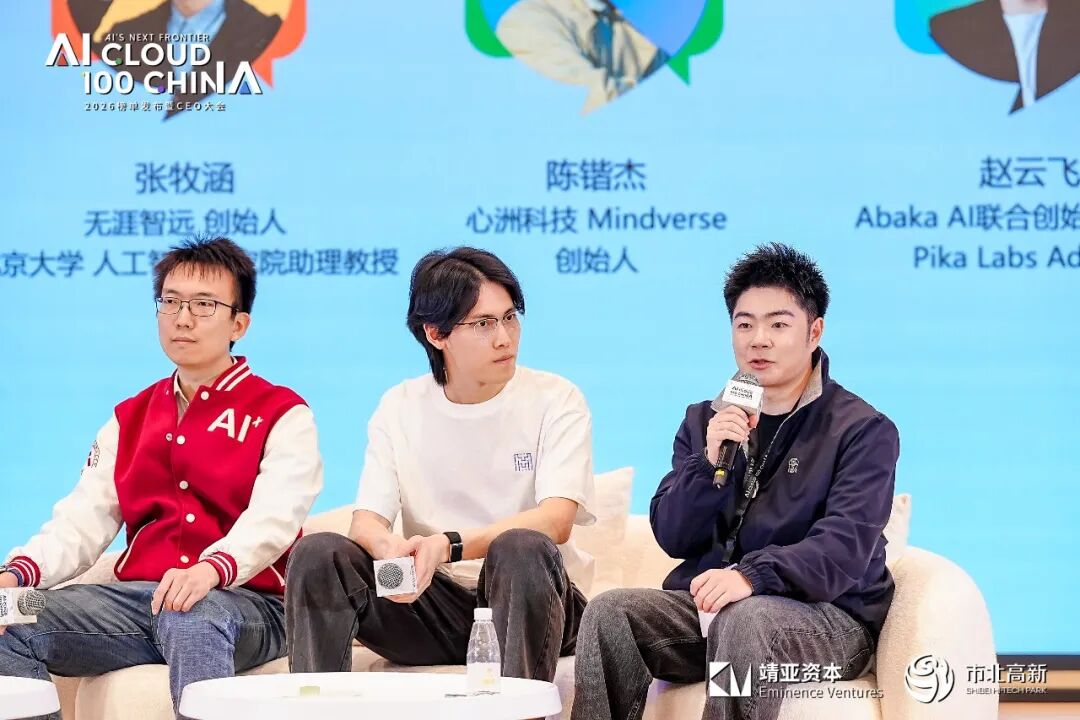
经常有人问,过几年模型都训练好了,是不是就不需要数据公司了?但我们看到,变化的是需求量和需求方向,整个生态对数据的依赖并没有下降。从文本、期刊文献,到图片、视频,再到世界模型、代码和机器人任务,都在产生新的需求。有些素材在网上能找到,有些则需要实际采集和标注。
比如机器人叠衣服,为什么总是叠不好?人很小的时候就在积累对物理世界的理解,但机器人未必有这些基础。它涉及的不只是一个动作,而是跨任务的理解。成功的经验和失败的案例,都是有价值的数据。
何沛:你们除了做数据,也建立了 AI 研究团队。为什么一家数据公司,要养一个这么贵的研究团队?
赵云飞:确实很贵。有人问我们的护城河是什么,是标注员特别聪明吗?我觉得一个词可以概括:Know-how。你要知道三个月、六个月以后,大模型公司会需要什么数据。
客户对时间非常敏感。有一次,我们上午开始谈订单,下午再问什么时候要数据,对方的意思就是当天下午要交付。所以,如果能够提前判断下一步训练的方向,把数据准备好,对我们就是很大的优势。我们做研究团队,也是希望通过与模型公司、顶尖院校的交流合作,提前做这些准备。
何沛:不是被动等客户提要求,而是提前预判。那从你们的观察来看,下一个突破可能在哪里?
赵云飞:我个人比较看好世界模型。现在可以生成一个能交互的三维空间,但有没有真正理解这个世界?下一步行动会怎样影响它?这是正在突破的地方,也会是迈向 Physical AI 很重要的一步。
03 / 做应用之后,为什么开始自己训练模型?
何沛:锴杰,你们很早就做过个人 Agent,现在重点又转向企业服务。能不能分享一下,这背后是怎么想的?
陈锴杰:我们做过个人 Agent,帮你写小应用、管理生活、订票。当时做着做着就发现,要让应用有独特的体验,后面的模型能力就得越来越强。
比如订票要越来越准,双十一能不能找到最好的优惠,能不能管理好购物清单?这些能力在通用模型里面没有被很好地训练过。要把这些领域做好,仅仅基于通用模型做工程优化是不够的,必须要自己训练。
我们从23年底就开始自己训练模型,最初是希望这些模型能够加强自己的应用。到今年我们发现,内部研究员积累的能力变得很强,同时市面上越来越多应用公司、垂直领域公司和传统企业,也希望有自己的模型能力。那我们就把已有的后训练能力和基础设施,开放出来变成一个可以商业化的平台。这就是今天我们做企业服务的基础。
何沛:我们做投资也看到,早期很多应用被叫作“套壳”,但现在越来越多应用公司想训练自己的模型。为什么大家不约而同地往这边走?
陈锴杰:如果调用前沿的闭源模型API是非常昂贵的,同时直接应用于具体的领域,表现也未必最优。那么具体领域的应用公司基于通用模型来做服务、或者搭建产品,再来做商业化就不是一个好的选择。比如很火的法律AI公司Harvey,在他调用 Open AI 或者 Anthropic 的模型来商业化的时候,毛利都长期为负数,直到他选择基于中国的开源模型,和Fireworks来合作后训练自己的模型之后,毛利才逐渐转正。
中国市场在过去几个月里也发生了这样的变化,对于性能、成本的综合考虑,以及可以将数据持续沉淀在自己训练模型之中,使得大家开始想拥有自己的后训练模型。
04 / 自动化研究:什么可以交给 AI,什么还很难?
何沛:伊凡,你现在感兴趣的方向是 Auto Research。怎么让 AI 自动做研究?未来人类研究员会不会慢慢让位于 AI 研究员?
张伊凡:Auto Research 本质上就是 Automating AI Research。研究过程中,我们要写代码、跑实验、观察结果,这些工作有不少已经能被 Coding Agent 的范式覆盖。
但研究 AI 本身又有一些区别。它需要启动 GPU 任务,要做环境适配,还要考虑如何控制变量。GPU 训练存在随机性,实验结果不一定能完全重复。如何刻画这些性质,让实验可复现、可验证,是很重要的问题。
从组织上看,自动化研究也可能减少沟通和管理成本。大模型研究有时也是组织问题:人很多,不一定做得更好,职责重叠、沟通成本都会产生影响。如果能让一个精简团队借助自动化研究提高效率,我觉得是很有前景的方向。
何沛:如果人类研究员是 100 分,现在的 AI 研究员大概能到多少分?
张伊凡:至少在某些垂直任务上,我觉得已经能够达到甚至超过人类,比如编写 GPU kernel,也就是 GPU 计算内核。但做得还不够好的,是开放性问题:什么是一个好的算法?什么是一个好的任务、好的环境?这些比较主观,难以提供可验证的奖励。
如果是哪个内核运行得更快、哪种训练算法更稳定、训练出的模型指标更高,就有相对明确的评价标准。这类问题也正是很多研究员在做的,所以更容易推进自动化。
何沛:研究的是新东西,成果怎么评价?有没有比较成熟的做法?
张伊凡:比如 NanoGPT Speed Run,大家从头训练模型,比较谁用的时间更短。它有客观的评分标准,不完全依靠主观判断。
何沛:从你在北美研究一线的观察,下一步突破可能发生在哪里?
张伊凡:模型的架构和学习算法,还有很多空间没有被充分利用。如果能通过研究降低预训练成本,现在加速两倍、三倍,未来能不能加速更多?这就可能找到算力和数据之外的第三个方向:Scaling Research。通过研究本身的进步,提高模型训练的效率。
05 / 真正的个人 Agent,应该和你一起成长
何沛:作为创业者,大家对未来都有自己的判断。未来两三年,出现什么现象,会打破你现在的预判?就像我们做投资,每个下注都有一个假设,最怕的是这个假设错了。你们想过这个问题吗?
陈锴杰:我觉得未必会让之前的东西都变错,但会增加很多变量。我和张老师是一派的,我认为持续学习会带来巨大的变量。
今天的API完全没有粘性,每次调用都是通过提示词改变结果。如果未来每次调用之后,相关的经验都能被模型学会,就会很不一样,甚至会带来颠覆性的变化。比如靖亚做投资分析,一定有自己的思考和经验。如果这些能够通过使用过程沉淀下来,就像专门为靖亚训练了一个模型一样。
今天哪个模型更好、更便宜,大家就可能切过去。但如果模型积累的是你自己的经验,切到别处就没有了,切换成本会越来越高。
现在的大模型像一个“超级博士生”,但还不能随着企业一起成长。一个从创业开始就陪企业成长、了解所有背景的人,即使智力水平一样,对企业的意义也很不一样。如果持续学习能做到这一点,模型公司的竞争格局就可能发生变化。这是让我很兴奋的地方。
何沛:相当于每个人都有一个专门为自己训练的模型。张老师赞同吗?
张牧涵:非常赞同。我们是一派的,但可能技术路线不一样。
何沛:除了个性化,还有主动性。个人 Agent 不只是等用户提问,而是主动发现需要处理的事情。你怎么看?
张牧涵:我觉得主动性和个性化是深深绑定的。它要非常了解你,理解你过去的情境,跟着你每天一起成长,从你见过、听过和交流过的事情里学习偏好。拥有了这些理解,它才有可能更主动地行动。
















