OpenAI新模型降价,中国大模型的“便宜”要失灵了?
Anthropic前脚递交招股书,OpenAI后脚就发布了新模型,巨头们动作不断,都在为自己谋关注度。
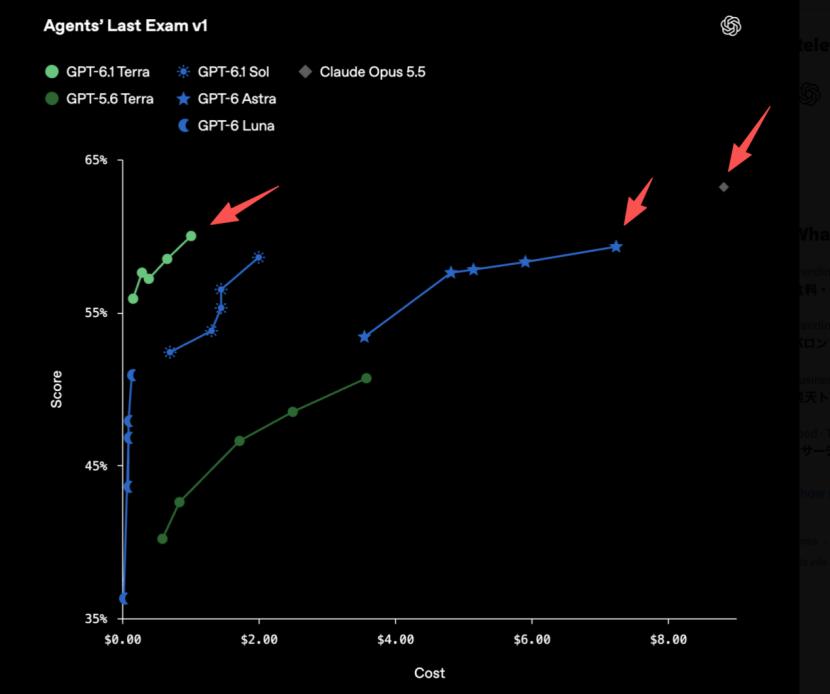
北京时间10月27日,OpenAI发布GPT-6.1 Terra。OpenAI称,Terra的Agent能力足以与旗舰Astra掰手腕,价格却只有后者的十分之一。
这个数字本身不稀奇,毕竟过去一年,大模型降价新闻早就看腻了。但这次与以往不一样的地方在于,相比上一代GPT-5.6 Terra,新模型的标准API价格直接降低50%,但在复杂任务执行、事实准确率和编程能力上均有明显提升。
OpenAI的新动作国内尤其关注,毕竟它要抢的正是中国大模型最舒服的那块地盘。
01 OpenAI也算“经济账”了
如果只看榜单最高分,Terra算不上一枚重磅炸弹。但把定价页和跑分图并排看,信号比分数更值得读:OpenAI这次卖的不是能力上限,是单位成本。
据OpenAI官方,GPT-6.1 Terra的API定价为每百万输入token 1美元、每百万输出token 5美元,比上一代Terra和同代Sol低50%。中等推理强度下,它在Agents’Last Exam上的得分比GPT-5.6 Terra高出15个百分点,单任务成本约为后者的三分之一。
评论区不少用户的第一反应是:“就这?”“感觉没比上一代惊艳多少”。官方给它的定位很直白:以更低成本完成复杂的电脑操作任务。在这个定位下,“是否最强”退居其次,“够用且便宜”才是卖点。
只看OpenAI自己的产品线,会感觉这只是一次正常的代际升级。但把视线拉回当下的大模型市场,另一条参照线绕不开:
单看绝对数字,Terra输出单价5美元/百万token,确实低于K3.1 Pro的10美元。但两者不在同一层:Terra是OpenAI矩阵里的“高级打工仔”,上面还有Sol和Astra顶着最复杂的任务;K3.1 Pro则是开源阵营里正面硬刚前沿闭源旗舰的产品。前者对标“干日常杂活,够用且便宜”,后者对标“接近前沿,且便宜”。
更关键的是,中国模型把性价比压下来,靠的不是烧钱补贴。瑞银证券分析师认为,中国大模型的训练成本仅为海外头部厂商的十分之一,API定价为海外对标模型的10%至20%;这种低价并非来自亏损,厂商在API业务上仍能保持20%至40%的毛利。
成本优势的来源,就是混合专家架构让每次推理激活的参数比极低,领先厂商的GPU利用率达到70%以上。月之暗面在K3系列上使用的MoonClip优化器,官方称实现了“20T训练数据用出40T的效果”;线性注意力机制则压住了长上下文带来的成本膨胀。他们是靠架构和工程效率,把成本结构本身压了下来。
OpenAI的逻辑很清楚:旗舰模型负责秀肌肉,Terra负责走量。走量的价格,直接对标全球所有“便宜够用”的模型。
02 算力硬边界与“额度”何解?
最关键的一点,Terra也并非单纯的防御性降价,硬实力是同步提升的。
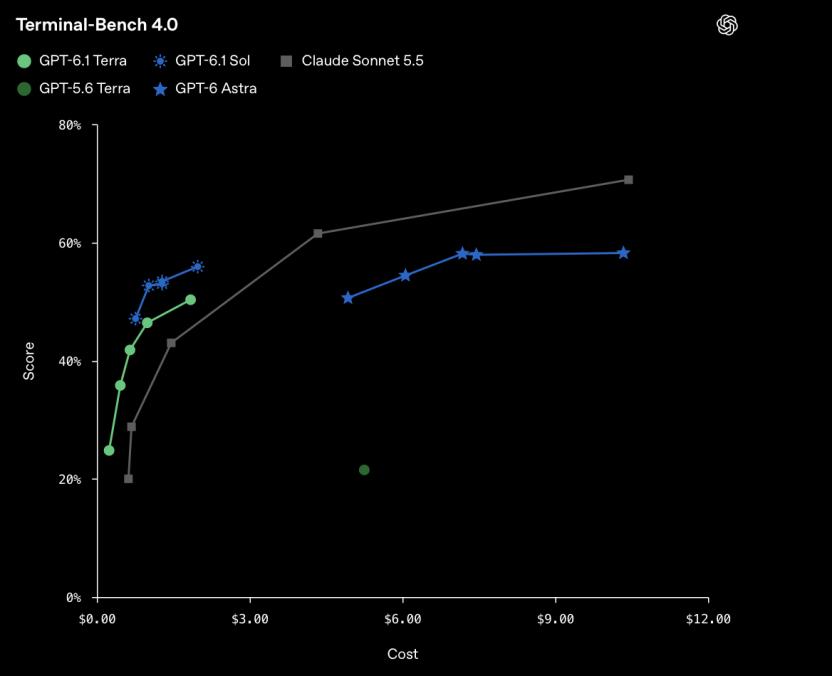
据OpenAI公布的数据,在Terminal-Bench 4.0命令行编程测试中,Terra在最高推理强度下的成功率达50.3%,上一代仅为21.5%;在内部事实性测试中,低推理强度的错误率从53.6%降至16.7%,最高推理强度降至4.3%。活干得更好,价格还更便宜。
但中国大模型绕不开一个痛点:额度。
这不是孤例。
当然,Terra不是最强模型,它只是把“够用加便宜”这个档位做得更狠。而这一档,恰恰是国产模型的主战场。所以,国产模型需要面对的挑战不是技术,而是在“便宜”不再是独家武器的情况下,当对手也开始卷性价比,手里还剩什么?
B端场景、数据合规、本地化部署、政企渠道,这些是OpenAI短期给不了的。
未来,开发者和企业要问的恐怕不再是“哪个模型最聪明”,而是“完成这个任务,哪个模型最划算”。厂商的分工也在变清晰:旗舰攻坚能力上限,中坚层负责把AI塞进打工人的日常流程。
真正的比拼不再是“模型比模型”,而在模型之外的一笔账:谁能让便宜变成可持续的成本结构,谁把模型嵌进了别人进不来的场景,谁才能是笑到最后的那个。
本文来自微信公众号“第四波”,作者:卢杨,36氪经授权发布。
















