硅谷AI杀疯了,DeepSeek们的性价比还剩多少?
薅羊毛潮,吹到了大模型界。但这次,被薅的是硅谷。
近期,海外大模型市场掀起了一场别样的“补贴战”。OpenAI疯狂向用户投喂额度“重置卡”,Anthropic也在送,先面向创业公司提供免费使用一年Claude Team的机会并附赠1000美元额度,后又发了新福利:按月免费发放API额度,Max 5x为100美元,Max 20x为200美元,Team团队版最高500美元。
另一边,免费模型的奖池越来越大。马斯克在“X平台”上表示,Grok Bot将免费开放使用Opus 5.5模型,并赋予其访问X平台全部功能的权限。OpenAI全量上线GPT-6后,免费用户也能用上Luna版了。
当硅谷厂商疯狂打出优惠牌,国产大模型的性价比优势还能守住吗?
DeepSeek带火的价格战,烧到了硅谷
曾被视为国产模型重要竞争优势的低价,正在成为全球厂商共同争夺的市场。除了直接发放各种Token补贴外,如今海外大模型厂商正在从基础定价、模型分层和计费机制等多个维度降低使用门槛。
从GPT-5.6开始,OpenAI不再是一个最强模型“打天下”,而是把按照能力层级分成了不同的价格档位。例如,最新的GPT-6 系列提供三个不同档位,Astra 负责最难最复杂的任务,Sol 提供更均衡的性能与成本,Luna 则定位于更低成本的调用场景。
并且,OpenAI也开始通过阶段性降价来吸引用户。官方公告显示,GPT-5.6系列的API价格在7月下调,Terra降价20%, Luna降完后直接两折。8月,GPT-5.6 Sol 的 API 与额度价格又下调超过20%,并计划至少维持优惠至11月21日。
更值得注意的是,现在用订阅额度跑GPT-6.1 Sol,都不收长上下文附加费了。在10月12日的更新中,OpenAI 把Codex和ChatGPT Work里的默认窗口从272k扩到500k,一口气涨了约80%。
而Anthropic进一步将价格竞争,拆解到模型能力和具体工作负载之中。目前,其官方 API 价格页面列出多款主力模型。其中,Claude Fable 5.1 面向高难度推理和长周期 Agent 任务,Opus 5.5 侧重长时间编码与知识工作,Sonnet 5.5 兼顾速度与能力,Haiku 5.5 则面向高频、低延迟任务。
Haiku 5.5的定价尤为扎眼,相比上一代最高直接降了90%。在10万 Token 以内,Haiku 的价格为输入每百万Token 0.10美元、输出0.50美元,比
此外,Anthropic 还在批量任务上为用户挖下降本空间:Batch API 的输入和输出 Token 均可享受50%的折扣。以 Sonnet 5.5 为例,标准价格为输入2美元、输出10美元;通过 Batch API 处理符合条件的非实时任务,价格可分别降至1美元和5美元。
Google 则同时提供免费层、标准付费层,以及 Batch、Flex、Priority 等不同服务模式,还推出阶段性优惠。以 Gemini 3.8 Flash 为例,按照官方公布的价格,2026年12月31日前,该模型的标准 API 输入价格为每百万 Token 0.75 美元,输出价格为3.75美元;从2027年1月1日起,价格将分别调整至1.50美元和7.50美元。
现在,海外模型大厂正在做的,是把低价变成一套完整的产品与计费体系,而不仅仅给旗舰模型的价格打折。对国产模型来说,新的竞争压力不容忽视。
国产大模型,没有想象中便宜?
今天讨论大模型的价格,可能不能只看某家公司贵不贵,而要先问提供的是哪一档能力以及用户实际需要什么能力。同一家厂商内部,模型之间的价格差距就可能达到数十倍乃至上百倍。
但对比API价格,国产大模型的确仍然有着相当明显的低价优势,这也是过去几年国产大模型参与竞争时最有力的武器之一。
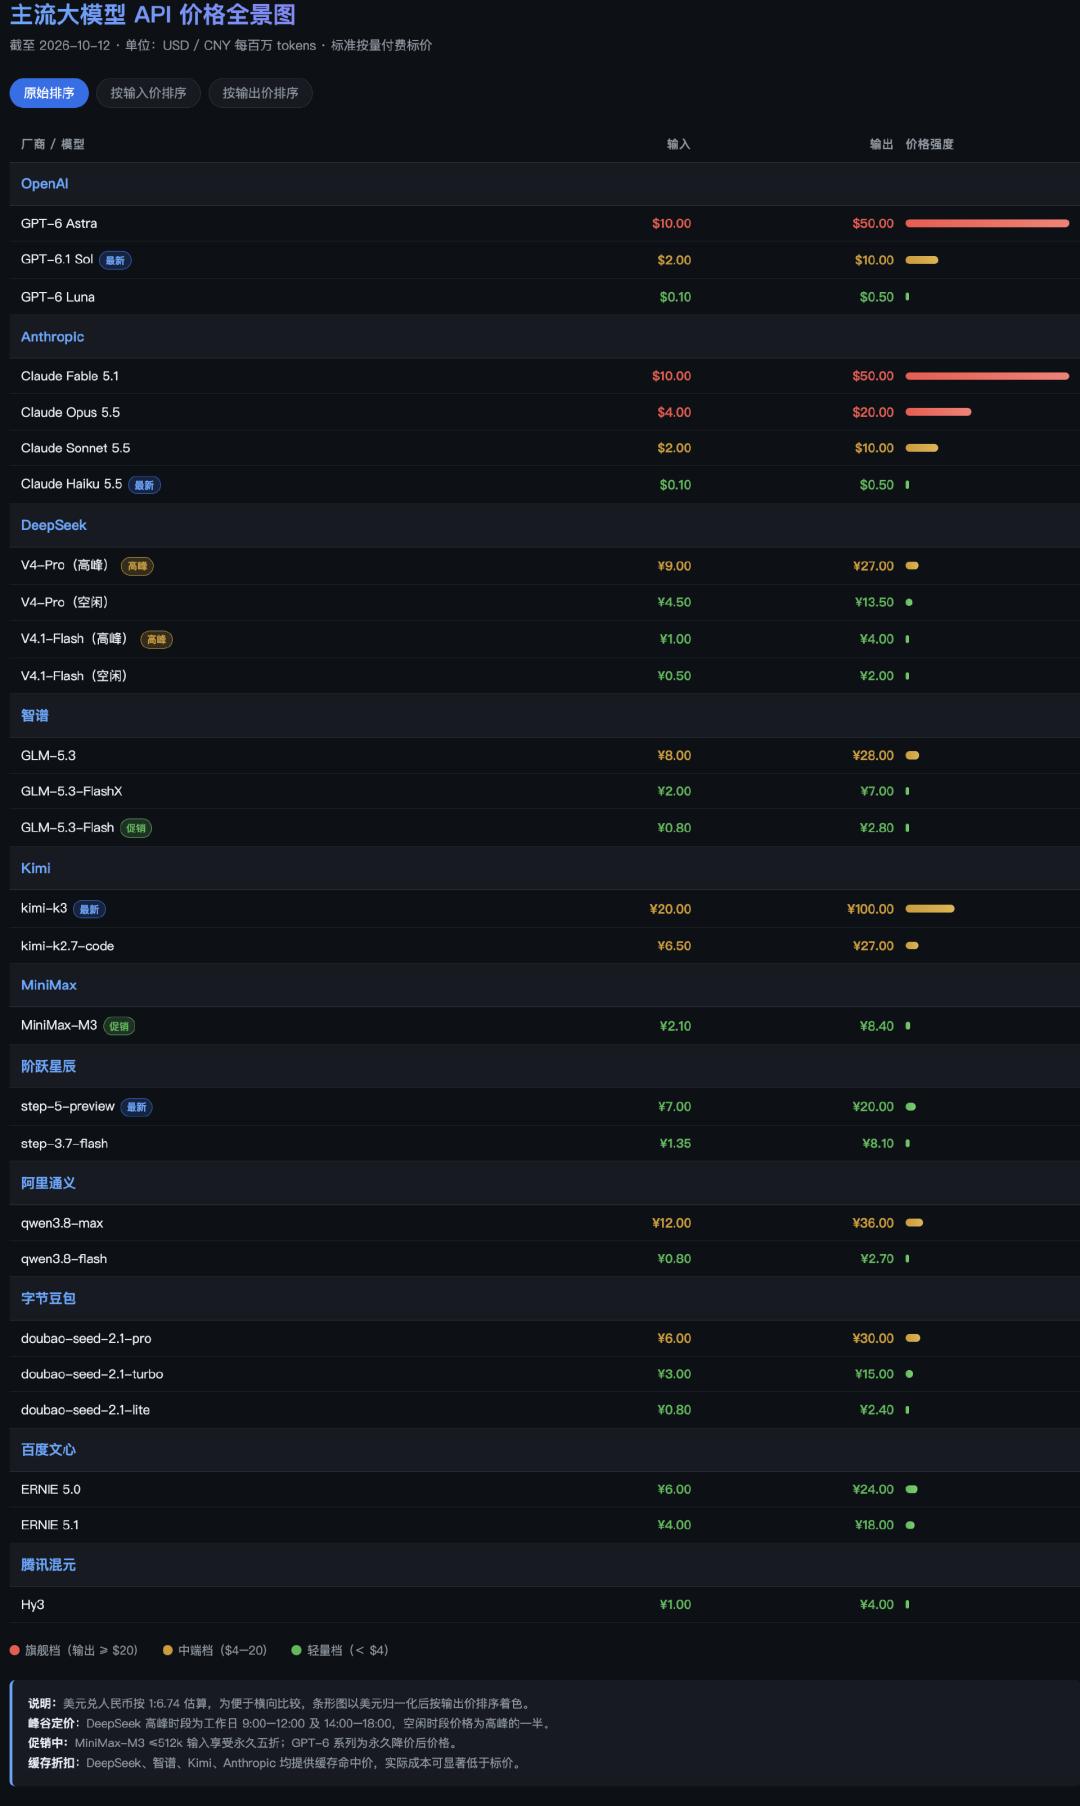
各厂商最新模型API价格(Tech星球根据公开信息制图)。
然而,回归到实际使用场景,国产模型的低价优势可能并不像表面上那么牢固。问题就在于不同厂商的计费方式,以及同样一笔钱能换来的实际生产力。
随着AI应用需求爆发,OpenAI、Anthropic以及智谱、月之暗面等国内外厂商,都在通过订阅套餐争夺高频使用的用户群体。在国内,甚至有大模型公司把Token订阅套餐摆上电商货架,智谱在天猫、京东都开设了官方旗舰店,
用户支付固定月费,就可以在一定额度内使用编程工具和模型;额度触顶后,可以等待重置、购买额外额度或者转向API付费。由此,模型竞争的战场也从“每百万Token多少钱”,转到了套餐能提供多少使用额度、实际调用是否稳定,以及能否高效完成任务。
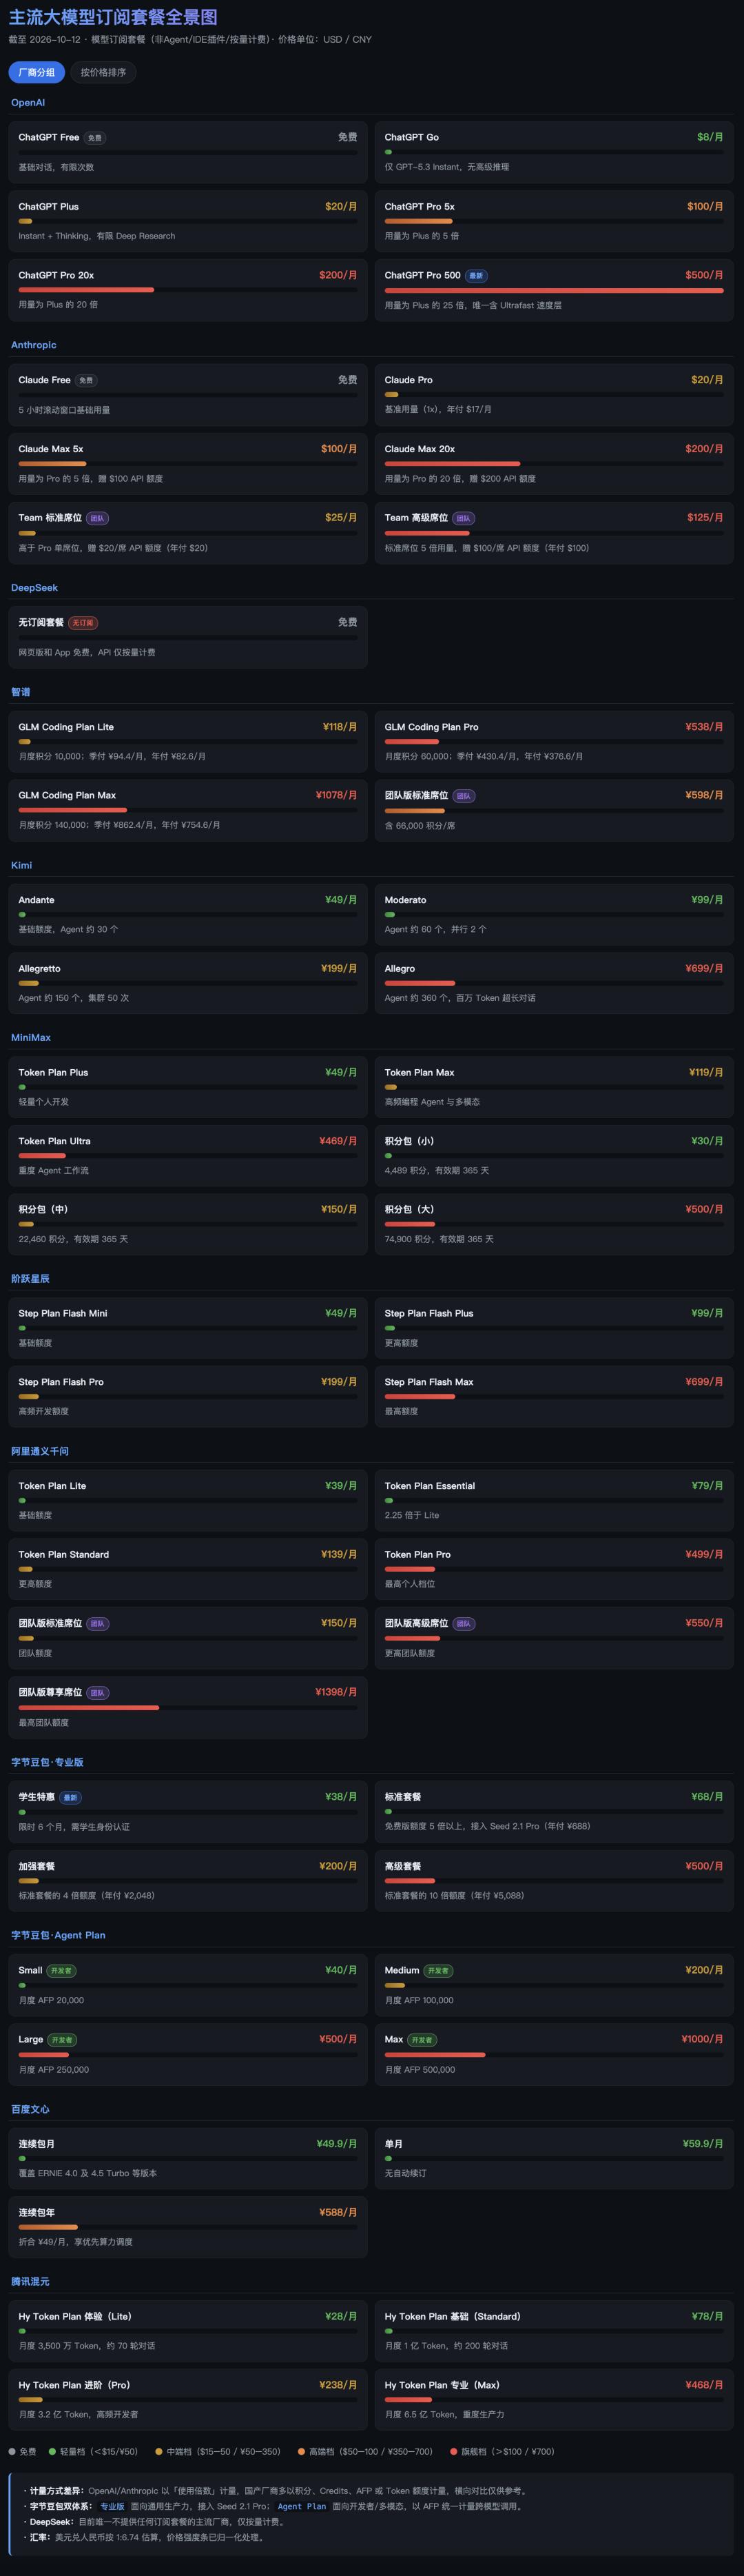
各厂商付费订阅套餐价格(Tech星球根据公开信息制图)。
近日,SemiAnalysis 把 OpenAI、Anthropic、Meta、SpaceXAI、
结果显示,Claude的订阅补贴力度远超国产模型。每月200美元的Max 20x套餐,使用Sonnet 5.5最多可跑出约12529美元的API用量,相当于月费的62.6倍;Opus 5.5 约为 11726 美元,相当于 58.6 倍。
而国产Coding Plan虽然月费更低,但算下来补贴力度并不高。132 美元的
消费端的反馈更为直观。“国产模型真干活太贵了”,不少深度使用AI大模型的用户算过账后吐槽。
一位希望支持国产模型的开发者向Tech星球分享了自己的使用体验。他此前主要使用 Opus 5 处理日常编码任务,后来订阅了月费199元的
另一位充值了
这些情况折射出模型性价比竞争中的一个新问题:低Token单价,并不一定等于低任务成本。 国产模型过去依靠低Token单价建立起的优势,正在接受新的考验。当然,这并不意味着国产模型在所有场景下都失去了成本优势。对于低频调用、批量推理、需要自主部署,或必须通过API接入自有业务系统的用户,国产模型仍可能凭借更低的调用价格和部署灵活性占据优势。
真正需要重新计算的,是不同使用场景下的综合成本。
价格战的下半场,靠什么赢?
当API单价、订阅套餐和实际任务成本被集中摆上桌面,大模型厂商之间的价格竞争,也正在从单纯比拼谁更便宜,转向如何覆盖不同场景下的用户预算。
如今,大模型厂商正在同时争夺三类市场:个人用户的订阅市场、开发者的 API 市场,以及企业客户的专属服务市场。
三者的付费逻辑并不相同。个人用户更关心每月花多少钱、能使用哪些模型、是否有调用额度限制;开发者更关心每次调用的成本、并发、延迟和稳定性;企业则还需要考虑数据安全、服务等级、部署方式与采购折扣。
不同的市场,也给了厂商们不同的价格竞争手段。面向个人用户,可以通过免费层、订阅套餐和功能权益降低使用门槛;面向开发者,可以通过低价模型、缓存折扣和批量处理降低调用成本;面向企业,则需要借助用量折扣、专属吞吐量、定制化部署和合同价格,满足规模化、稳定性的业务需求。
更重要的是,模型的性价比其实并不是一个脱离使用场景的固定数字。 同样一款模型,在不同任务中的表现、消耗和用户评价可能截然不同。
例如,
另外,对于模型厂商而言,优化推理效率、改进工具调用和减少无效输出,与直接降价同样重要。如果一款模型能够用更少的推理步骤、更少的上下文和更少的重试完成同样的任务,那么即使单价没有最低,整体成本也可能更有竞争力。
大模型市场未必会出现一个能够在所有任务中胜出的“性价比之王”。复杂编码、长文写作、日常问答、批量推理和企业工作流,对模型能力与成本的要求各不相同。未来的竞争,很可能不是某一家厂商凭借一个最低价格覆盖所有场景,而是不同模型在各自擅长的任务中,找到价格与效果的最佳平衡点。
对国产模型而言,低价优势未必守不住,但它或许已经不能单独决定胜负。更现实的竞争方式,是在特定任务中形成更有竞争力的价格与效果组合,并通过推理效率、产品生态和商业交付,把这种优势稳定地交付给用户。
当低价转化为更高的任务完成效率、更好的使用体验和可持续的商业价值,它才可能从短期吸引力变成长期竞争力。
本文来自微信公众号“Tech星球”(ID:tech618),作者:华卫,36氪经授权发布。
















