从头设计到局部精修:ProteoCraft探索可控蛋白质设计
庞大的序列搜索空间,是蛋白质设计面临的核心难题之一。
一条由 100 个氨基酸组成的蛋白质序列,如果每个位置都可以从 20 种氨基酸中选择,理论上就有超过 种组合,数量远超可观测宇宙中的原子总数。如何从这些可能性中找到能够形成预期结构、实现特定结合功能的蛋白质,是计算设计需要解决的问题。
近日,斯坦福大学 X-lab 和 SNAP 实验室联合发布蛋白设计框架 ProteoCraft,围绕蛋白质序列搜索与结构验证,提出「提案 — 验证」搜索方案:通过近似梯度提出修改方向,利用完整结构预测验证候选,再由树搜索组织后续探索和单点精修。该框架既支持结合蛋白的从头设计,也支持限定区域内的局部改造。
计算基准中,ProteoCraft 在独立 AF2-IG 评估下的严格通过率达到 86.2%;在相同候选预算、ESMFold2 严格标准下,树搜索的高置信度通过率为 54.3%,是 Best-of-N 对照的 2.85 倍。
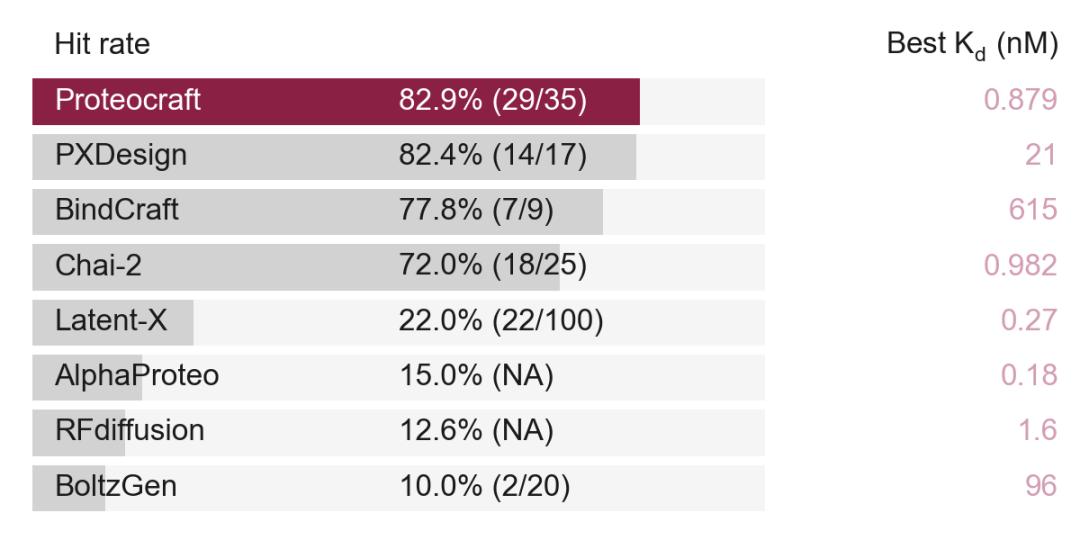
PD-L1 微型蛋白湿实验中,35 个成功表达的候选有 29 个结合命中,命中率为 82.9%;其中 6 个候选的报告所选拟合 Kd 低于 10 nM,最佳单次 SPR 拟合 Kd 为 0.879 nM。Big 配置相较自身未优化版本实现平均 3.57 倍的端到端搜索加速。
从计算评估到湿实验,ProteoCraft 已取得颇具竞争力的阶段性成果。在这些成果背后,它究竟如何通过梯度提案、完整结构验证和两阶段树搜索,在庞大的蛋白质序列空间中更有效地探索和精修候选?
从生成到搜索,ProteoCraft 如何寻找更优的蛋白质序列?
当前,围绕蛋白质结构生成与序列优化,已经有了多条具有代表性的技术路线。
RFdiffusion、BindCraft、BoltzGen 等方法已经具备从头生成蛋白结合分子的能力,BindCraft 等方法也已利用结构预测梯度优化序列。但庞大的序列空间仍给搜索效率、计算开销和预测模型偏差带来挑战。
ProteoCraft 的核心思路是将「提出修改」与「评价候选」分开处理,再让两者在搜索过程中持续配合。
在 Proposal 阶段,近似梯度负责提供值得探索的修改方向;在 Verification 阶段,模型对实际生成的离散氨基酸序列运行完整结构预测,判断候选是否值得继续探索。
验证结果会进一步反馈给树搜索,影响下一步的设计决策,使完整结构预测参与整个设计过程,而不局限于最终筛选。
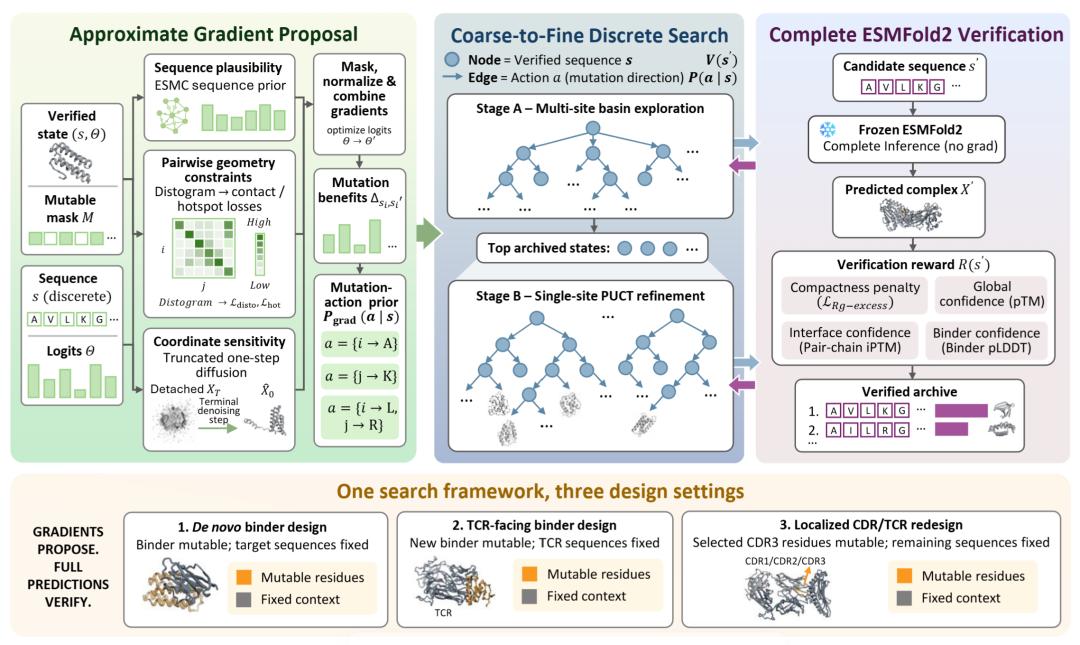
ProteoCraft 提案 — 验证搜索流程,包括梯度提案、两阶段树搜索和完整结构预测。
这种分工对应两类不同的计算任务。
首先是如何以较低成本确定序列修改方向。
对于蛋白质设计而言,每一个氨基酸位置的变化,都可能影响蛋白质的折叠结构及其与靶点的相互作用。如果每次尝试都依赖完整结构计算,搜索成本就会迅速累积。
ProteoCraft 因此结合多种信号指导序列修改。
一方面,模型利用蛋白序列先验,判断新的氨基酸组合是否符合蛋白质序列的统计规律;另一方面,通过残基间的几何约束,鼓励设计形成合理的内部结构和结合界面。
此外,模型还引入截断扩散梯度,获取与三维结构变化有关的修改信号。
为控制梯度计算成本,ProteoCraft 仅对末端的一步去噪保留扩散路径梯度,避免对完整扩散生成轨迹进行反向传播。
但梯度给出的修改方向,并不直接代表候选的最终质量。
因此,ProteoCraft 还保留了完整结构验证环节。
对于提出的离散候选序列,模型运行完整的 ESMFold2 结构预测,并结合界面置信度、蛋白质折叠置信度及整体结构质量等指标进行评价。
近似梯度负责寻找可能有价值的方向,完整预测负责检验实际候选,避免仅凭近似梯度评分决定某条序列的价值。
提案与验证之外,搜索过程还需要决定计算资源应该投入哪些候选。
ProteoCraft 在此引入了蒙特卡洛树搜索,并采用由粗到细的两阶段策略。
第一阶段(Stage A)允许同时修改多个氨基酸位置。
这一阶段主要承担广泛探索的任务,在较大的序列空间中尝试不同方案,寻找具有潜力的设计区域。搜索过程中,模型会根据已经验证的候选质量,决定哪些分支值得继续探索,同时为尚未充分尝试的方向保留搜索机会。
第二阶段(Stage B)则转向单点精修。
在获得质量较好的候选后,模型转而进行更细致的局部优化,每次仅改变一个氨基酸位置,对已有方案进行进一步调整。
由此,ProteoCraft 将梯度提案、完整验证与树搜索决策组织成一个迭代过程,在广泛探索和局部优化之间分配计算资源。
这套框架还支持对特定区域进行可控设计。
研究团队通过指定可变序列区域与目标结合热点,将其用于以 T 细胞受体(TCR)为靶点的结合蛋白设计,以及局部 CDR/TCR 改造。
在局部改造任务中,模型只更新允许修改的残基,其他序列保持不变,但仍然参与整个复合物的结构预测。
因此,ProteoCraft 可以在从头设计中探索新的结合蛋白序列,也可以保留已有分子框架,对特定区域进行精细调整。
86.2% 严格通过率、2.85 倍高置信度候选,ProteoCraft 展示搜索优势
ProteoCraft 论文从独立计算评估、搜索策略消融以及推理效率等方面,对这一方法进行了系统测试。
首先是从头结合蛋白设计任务上的性能比较。
这组计算基准覆盖 8 种靶蛋白、14 种不同的靶点及结合热点设置,包括针对同一蛋白不同表位的设计。每种方法提供 210 个候选,并采用统一的评估流程进行比较。
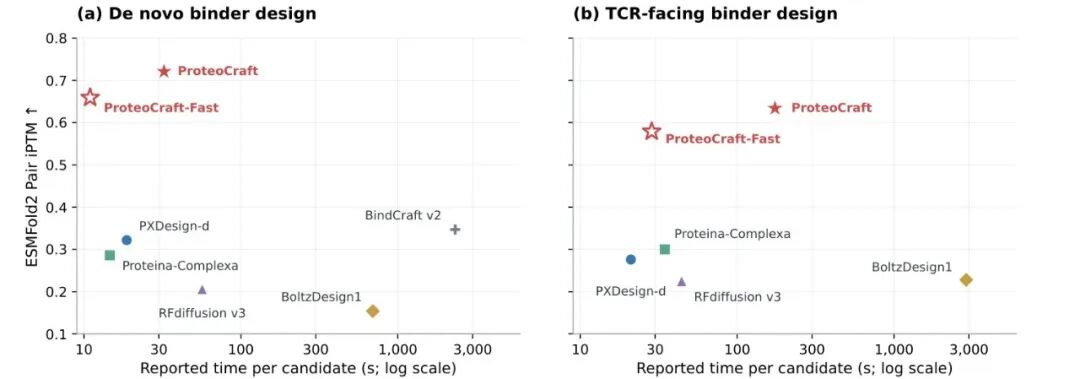
候选置信度与报告计算耗时的关系。
为了避免只使用参与搜索的模型评价自己的结果,团队引入了独立的结构预测评估工具 AF2-IG。
在这组测试中,ProteoCraft 的严格计算通过率达到 86.2%(181/210)。
作为对照,BindCraft 的通过率为 49.5%,BindCraft v2 为 58.1%,PXDesign-d 为 9.5%。
在本次统一评估标准下,ProteoCraft 有更高比例的候选达到指定的结构与结合界面置信度要求。
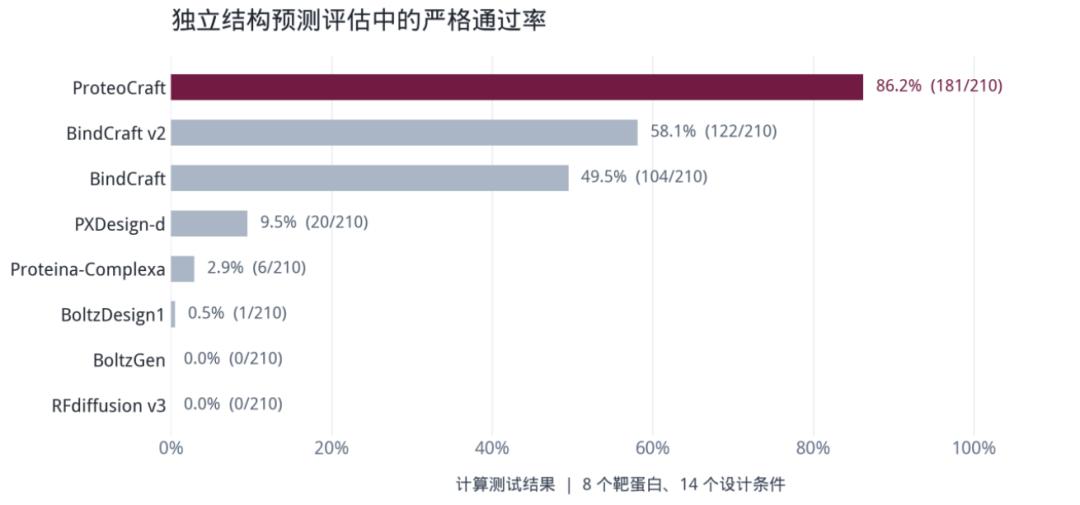
独立 AF2-IG 评估严格通过率,ProteoCraft 为 86.2%。
AF2-IG 并未参与 ProteoCraft 的候选搜索和选择,而是由另一套结构预测模型重新检查输出的序列,从而降低了仅依赖搜索模型自身评分所带来的评估偏差。
团队还使用 Rosetta,对结合界面的能量、形状互补性、氢键及其他结构指标进行评估。
在相同的评估流程下,ProteoCraft 的平均界面能量评分为 -81.195,BindCraft 为 -57.879;平均界面氢键数量分别为 12.510 和 8.500。
这些独立评估结果进一步支持了 ProteoCraft 在计算设计质量上的表现。
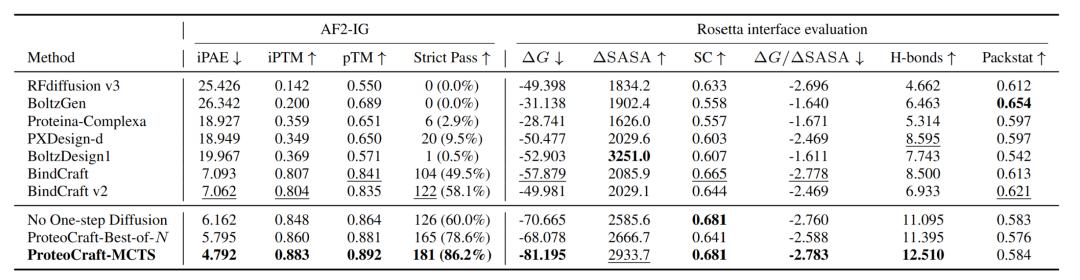
独立 AF2-IG 和 Rosetta 计算评估。
除了与其他方法比较,论文还专门研究了树搜索策略自身带来的贡献。
在 ESMFold2 的严格联合标准下,候选需要同时满足 Pair iPTM 不低于 0.75、Binder pLDDT 不低于 0.9,才能被计为通过。
完整树搜索得到的 210 个候选中,共有 114 个通过这一标准,通过率为 54.3%。
相比之下,采用相同提案机制、相同候选预算,但不使用树搜索控制的 Best-of-N 对照,仅有 40 个候选通过,比例为 19.0%。
两者通过严格标准的候选数量相差 2.85 倍。
这一对照说明,在给定候选预算下,树搜索能够让更多设计同时达到界面与折叠置信度要求。
团队进一步通过消融实验验证了不同技术设计的贡献。
移除截断一步扩散梯度后,模型的平均 Pair iPTM 下降,达到较高界面置信度标准的候选数量也随之减少,说明这一信号能够为序列修改提供额外的结构信息。
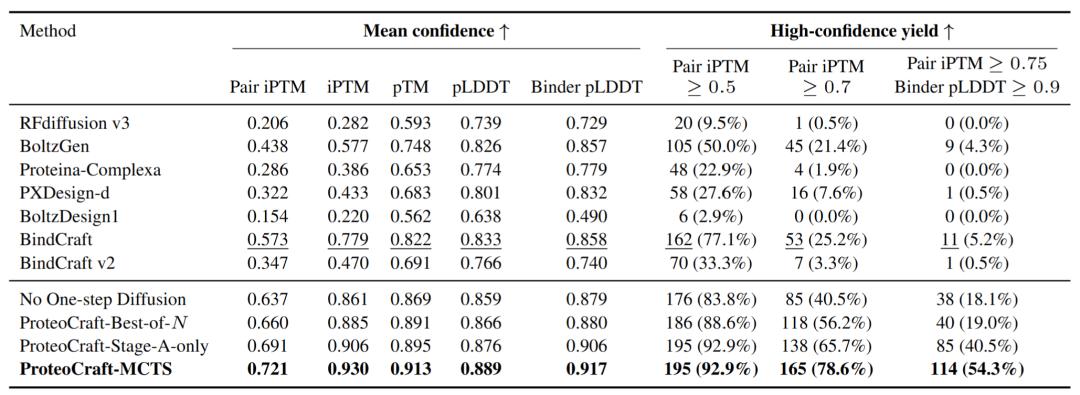
ESMFold2 评估和搜索策略消融,完整树搜索严格通过率 54.3%,Best-of-N 为 19.0%。
对于两阶段搜索中的单点精修,论文也进行了专门对照。
研究人员让不同搜索策略从相同的 Stage A 检查点出发,并分配相同的 40 个追加搜索步数:一组继续进行多位点探索,另一组转入 Stage B 单点精修。
结果显示,继续多位点探索的严格通过率为 40.5%,转入单点精修后则达到 54.3%。
在相同的追加搜索预算下,单点精修获得了更高比例的严格达标候选,证明了局部优化阶段在当前测试条件下的独立贡献。
这种能力也体现在局部 CDR 改造任务中。
以 1QRN β 任务为例,ProteoCraft 的 Peptide Pair iPTM 达到 0.789,而 RFdiffusion v3 为 0.421。这一指标衡量的是设计区域与目标肽之间的预测界面置信度。
结合 AF2-IG 和 Rosetta 的独立交叉评估,结果进一步展示了该框架在限定序列区域内进行精细设计的潜力。
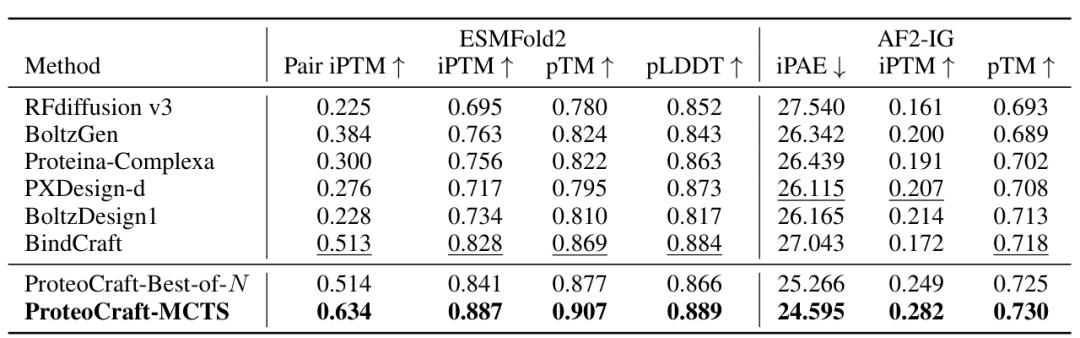
TCR-facing binder 设计的 ESMFold2 与 AF2-IG 计算评估。
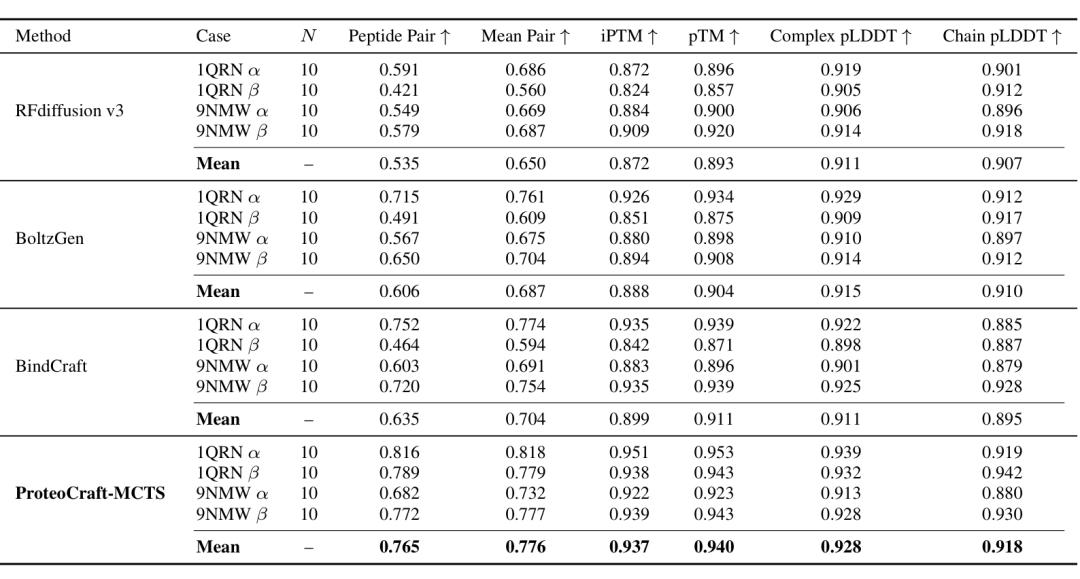
局部 CDR 改造计算评估,包括 1QRN β 任务。
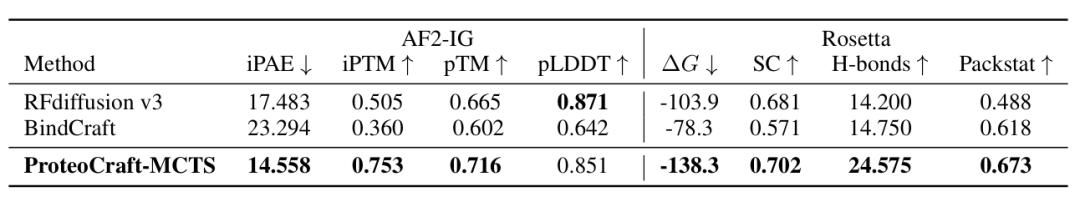
局部 CDR 改造的 AF2-IG 与 Rosetta 独立交叉评估。
在候选质量之外,ProteoCraft 也针对计算效率进行了优化。
论文使用 Anthropic 开源的 ESMFold2 推理优化工具,测试了不同的加速配置。
在覆盖 13 个测试靶点的实验中,Big 配置相较未优化的 ProteoCraft,实现平均 3.57 倍的端到端搜索加速。
与此同时,Big 配置的平均 Pair iPTM 为 0.673,未优化基线为 0.657,整体设计质量保持相近。
另一种 Fast 配置平均加速达到 3.68 倍,在 9C3E 任务上最高达到 6.78 倍,但其平均 Pair iPTM 为 0.628,低于 Big 配置及未优化基线。
不同配置的结果反映出搜索速度与设计质量之间的取舍。Fast 配置可以进一步提高部分任务的运行速度,但平均设计质量也有所下降。
因此,论文更加突出 Big 配置在搜索速度与平均设计质量之间的平衡。
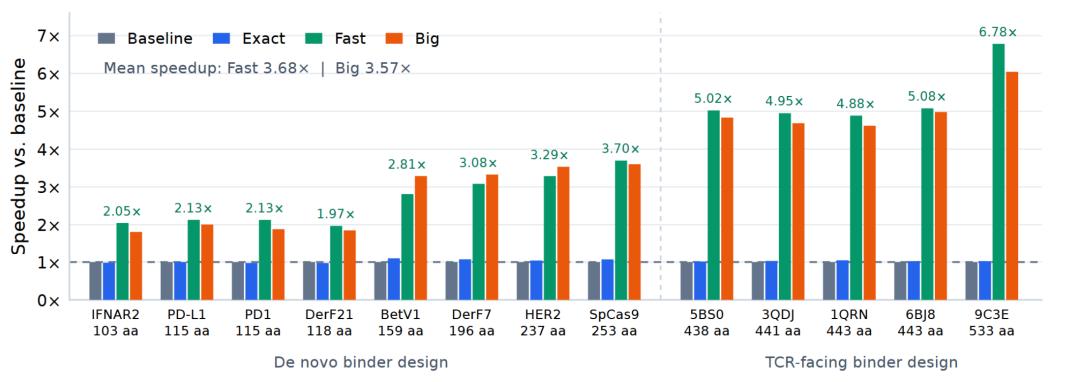
ESMFold2 不同推理配置的端到端加速表现,基线为未优化 ProteoCraft。
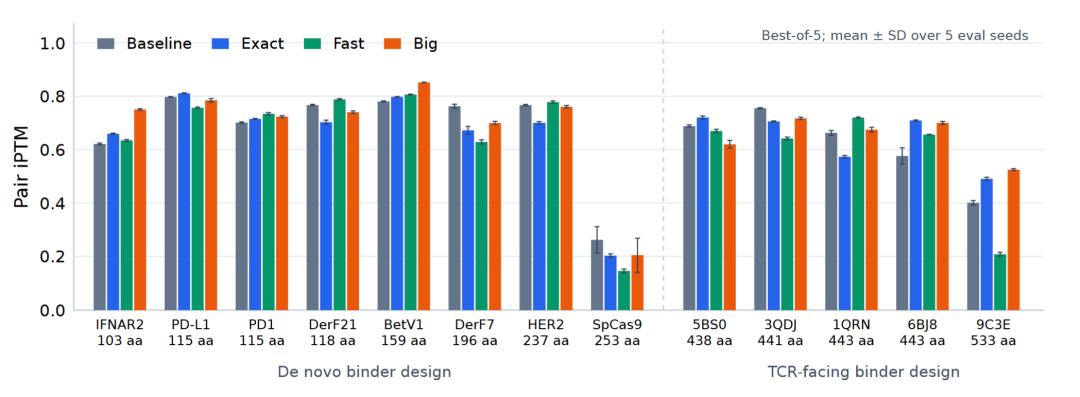
不同推理配置的设计质量与搜索速度取舍。
按照论文的统计,在从头设计任务中,ProteoCraft 平均每产出一个满足 overall iPTM 大于 0.70 的独特候选,摊销计算耗时为 32.34 秒。
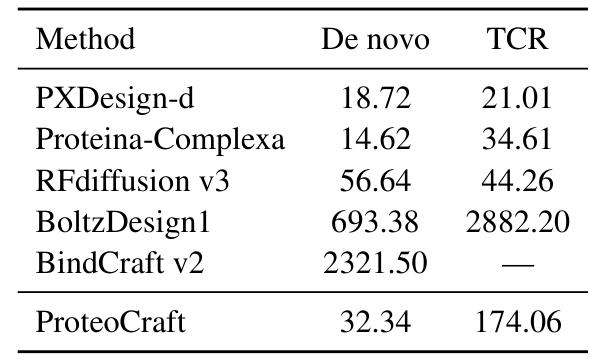
35 个候选命中 29 个,AI 设计的蛋白质走进真实实验
计算评估之后,还需要通过真实实验检验候选能否与靶蛋白结合。
一条序列即使在结构预测中表现出很高的界面置信度,也不意味着它一定能够被成功制备,更不意味着它一定能在实验中与目标结合。
因此,在计算评估之外,团队还进一步开展了湿实验验证。
根据团队提供的最新实验结果,本轮测试覆盖了 PD-L1 微型蛋白、IFNAR2 微型蛋白和 IFNAR2 纳米抗体三组设计。
其中,PD-L1 组获得了最高的结合命中率。
PD-L1 是参与免疫调节的重要蛋白,也是肿瘤免疫治疗领域广泛研究的靶点。针对这一靶点,团队首先验证计算设计得到的候选能否在实验中形成实际结合。
在 ProteoCraft 设计的 35 个 PD-L1 微型蛋白候选中,全部达到实验报告的表达/上样成功标准,其中 29 个获得结合命中,命中率达到 82.9%。
作为对照,在其他公开研究中,PXDesign 的命中率为 82.4%(14/17),BindCraft 为 77.8%(7/9),Chai-2 为 72.0%(18/25)。
按照本轮实验采用的判定标准,超过八成成功表达并进入检测的候选获得了结合命中。
根据最新实验报告所选用的拟合值,35 个成功表达的 PD-L1 候选中,有 6 个候选的 Kd 低于 10 nM,占比 17.1%。
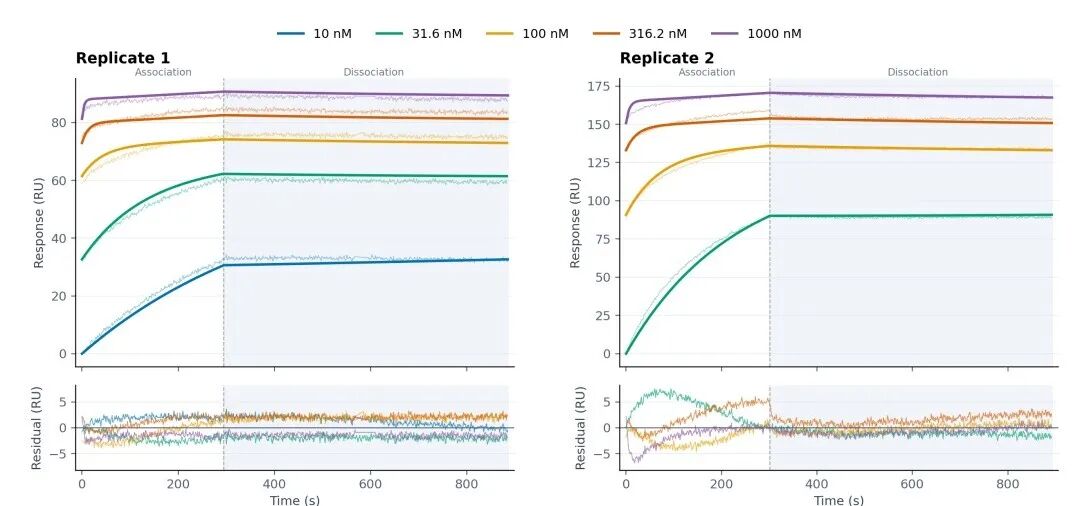
PD-L1 代表性 SPR 测量曲线。
其中,5 个候选的 Kd 处于 1 nM 至小于 10 nM 的范围,占比 14.3%;另有 1 个候选达到亚纳摩尔水平。最佳单次 SPR 拟合 Kd 为 0.879 nM。
ProteoCraft 还尝试了另一种在生物医药研发中具有重要应用价值的蛋白形式 ——VHH 纳米抗体。
与通常具有较短序列的微型蛋白相比,VHH 拥有免疫球蛋白样的结构框架,并通过三个互补决定区(CDR)参与抗原识别。
VHH 的设计需要同时考虑 CDR 环区的构象、与目标表位的结合姿态,以及 CDR 与原有框架之间的结构兼容性。
修改 CDR 序列,可能改变分子对靶点的识别能力,也可能影响整体折叠、表达和聚集倾向。
因此,除了局部结合界面的形成,纳米抗体设计还需要检查整个分子的折叠状态、表达能力和稳定性。
在 IFNAR2 靶点上,ProteoCraft 分别进行了微型蛋白和 VHH 纳米抗体设计。
其中,VHH 纳米抗体在 9 个成功表达的候选中获得 4 个结合命中,命中率为 44.4%;微型蛋白则在 27 个成功表达的候选中获得 5 个命中,命中率为 18.5%。
与微型蛋白相比,VHH 纳米抗体具有免疫球蛋白样的结构框架,主要通过三个互补决定区(CDR)参与抗原识别。针对这类分子,ProteoCraft 的限定区域设计能力具有潜在应用价值:模型可以在保留已有蛋白框架的同时,对参与识别的局部序列进行探索和优化。
从整体样品制备情况看,本轮共测试 75 个设计,其中 71 个达到实验报告所采用的表达/上样成功标准,比例为 94.7%。
除了单个候选的结合能力,候选之间的序列多样性也影响后续研发的选择空间。
即便某个候选具备较好的结合亲和力,在后续研发中仍可能遇到稳定性、表达或其他开发问题。不同的候选方案,可以为进一步优化和选择保留空间。
ProteoCraft 的 PD-L1 实验结果也呈现出一定的序列多样性。
按照实验报告使用的 80% 全序列相似度阈值及聚类规则,29 个结合命中形成了 29 个序列簇,两两序列相似度的中位数为 28.7%。IFNAR2 VHH 命中候选的序列多样性指标为 8.7%。
这些结果说明,本轮实验获得的结合命中并非集中在少数高度相似的序列变体中,为后续比较、优化和选择保留了不同的候选方案。
对于潜在的治疗性分子,研究人员还需要考虑其生物学功能、生产与开发性质,以及是否可能引发不希望出现的免疫反应。
获得结合命中后,团队进一步考察候选分子的免疫原性相关预测表现与潜在脱靶风险,希望为后续开发找到更合适的起点。
免疫原性初筛覆盖了 28 条 PD-L1 和 2 条 IFNAR2 结合阳性候选。团队针对 27 种 HLA-II 分型,使用 NetMHCIIpan 与 MixMHC2pred 交叉评估,并结合 ImmuScope-IM 预测和实验亲和力数据进行比较。
在 28 条 PD-L1 结合阳性候选中,Kd 最低的分子(0.879 nM)同时具有最低的双模型共识呈递密度,在结合亲和力与这一免疫原性相关预测指标上均表现突出。
脱靶风险评估纳入了 37 条候选,分别与 9 个相关蛋白及 15 个扩展筛查蛋白进行配对预测,每个配对运行三次并取平均。
在相关蛋白面板中,全部候选的非靶标平均界面评分均低于 0.65。合并两个面板后,32 条候选(86.5%)在全部非靶标配对中的平均评分低于 0.70;其余 5 条的最高评分约为 0.71—0.76,将作为后续交叉结合实验的重点复核对象。
这些计算结果为候选比较和下一阶段实验安排提供了更多依据,也将评价范围从结合亲和力拓展到免疫原性相关特征与潜在脱靶风险。
从实验验证到按需设计,AI 蛋白研发的下一步
目前的计算与湿实验结果,已为 ProteoCraft 在结合蛋白设计中的应用提供了初步验证。参与这项合作研究的来兮成序(Lexicodon Therapeutics),则希望进一步围绕免疫调控需求,探索以功能为起点的蛋白质设计。
来兮成序提出了 「function-first and reasoning-native protein design」 的理念:先明确需要实现的生物学功能,再通过生物学推理指导分子设计。在免疫领域,这些目标可以是阻断异常炎症信号、调节免疫细胞活化,或引导免疫细胞识别特定的靶细胞。
不同的功能目标,对分子结合的位置、方式、强度以及作用对象提出了不同要求。围绕这些需求,公司希望结合对靶点机制和蛋白相互作用的分析,将功能目标逐步转化为具体的表位选择、结合模式与序列修改约束。
目前,来兮成序主要开展针对指定靶点的结合蛋白从头设计与亲和力优化,并希望进一步利用受约束搜索和局部精修,在保留已有分子框架的同时调整关键区域,逐步兼顾功能、特异性与可开发性要求。
下一步,团队将通过细胞层面的功能实验,检验候选能否按预期影响免疫信号和细胞反应,并将实验结果反馈到后续设计中。将生物学推理、可控分子设计与功能验证连接起来,是来兮成序推动免疫功能蛋白按需研发的长期方向。
代码:https://github.com/smiles724/ProteoCraft_v1
论文:https://github.com/smiles724/ProteoCraft_v1/blob/main/docs/ProteoCraft.pdf
本文来自微信公众号 “机器之心”(ID:almosthuman2014),作者:关注AI的,36氪经授权发布。
















