算力开始分层:天数智芯把“云的能力”,折叠进方寸之间
一个机器人学会走路之前,要先在仿真里摔倒成千上万次。
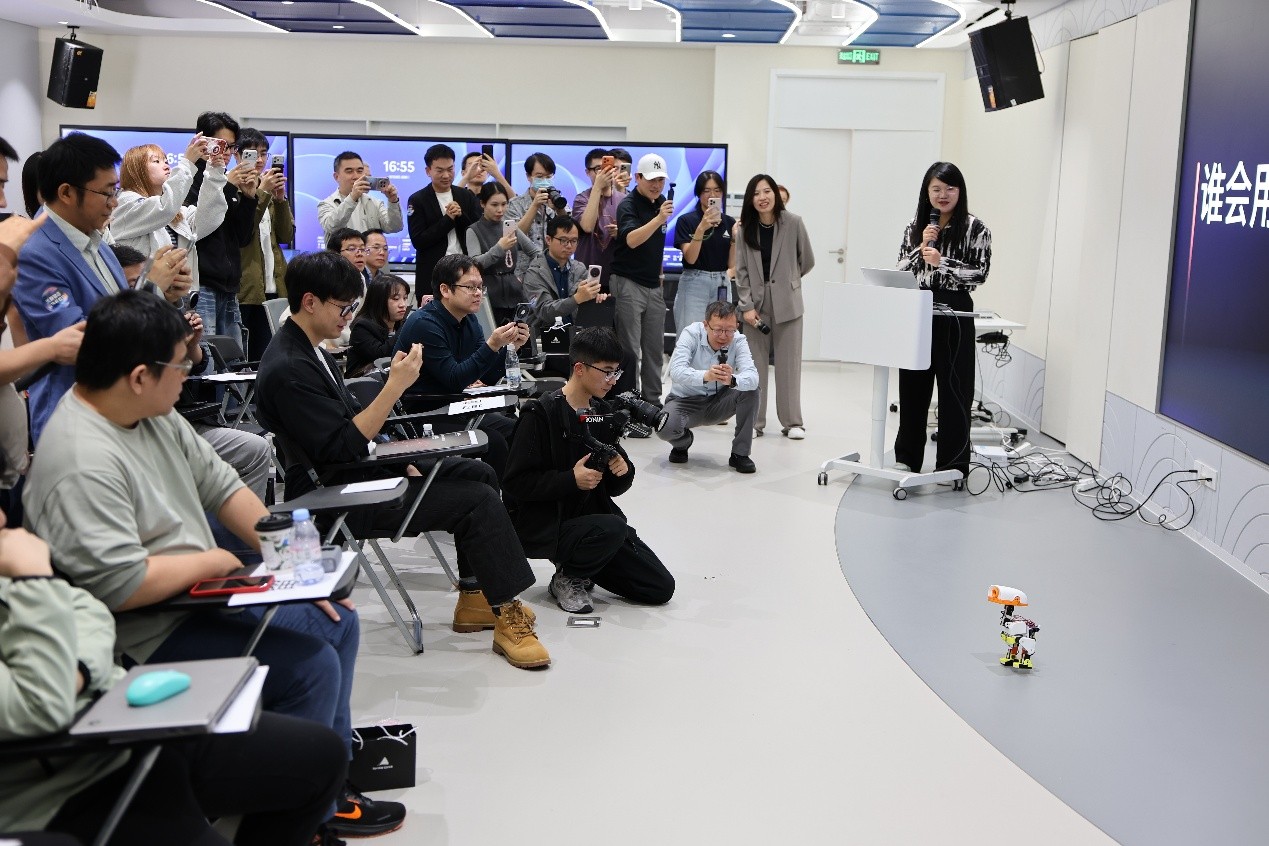
近日,在天数智芯“从模型到世界”媒体开放日上,一只3D打印、手工组装的机器鸭“MicroDuck”成了关注焦点:它在一台名为彤央TY1200的边端算力终端上,离线完成了物理仿真、策略训练和动作验证,最终稳稳站立。同样的演示,英伟达在GTC舞台上做过一次——区别在于,那一次训练被送往云端超算,而这一次,全部发生在一个不联网的“盒子”里。这也是国产端侧产品较早实现基于MuJoCo-Warp的GPU加速物理仿真。
这个细节,是理解天数智芯边端战略的一把钥匙。
市场不再问“要不要用AI”,而是问“AI能不能贴着数据跑”
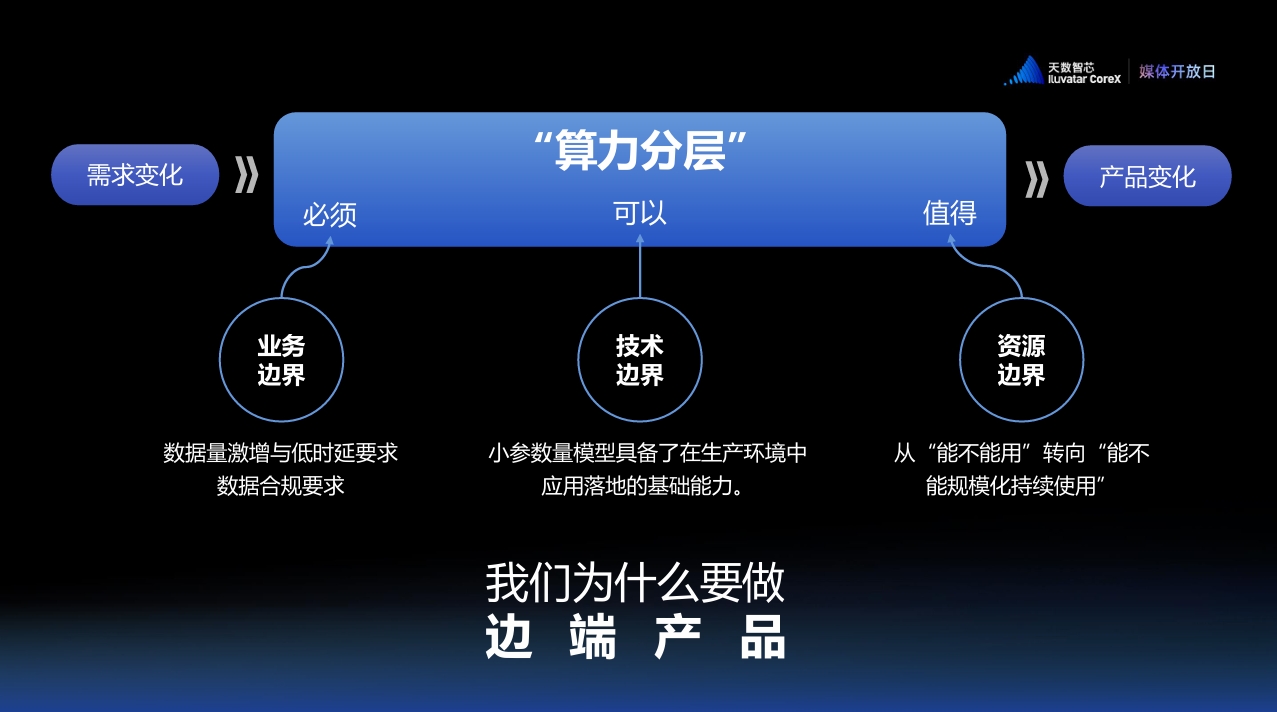
天数智芯的判断可以概括为四个字:算力分层。其背后是三股正在合流的力量。
业务侧,物理AI时代数据量爆发,客户对时延的要求已进入毫秒级——算力离数据越近,价值兑现越快;同时,财务、合同、核心源代码等高保密场景,正在把智能部署到本地。技术侧,小参数模型的能力正在追平上一代大模型:上一代32B模型能做的事,如今9B就可以做到;过去需要72B的任务,这一代27B就能完成,边端设备第一次“装得下、跑得动”真正的智能。资源侧,围绕API价格、token账单和用量上限的讨论,表面是定价之争,本质是对算力性价比的追问——简单任务上云是浪费,复杂任务下沉也是浪费,每种任务都应待在性价比最高的那一层。
必须分层、可以分层、值得分层。这就是天数智芯给出的逻辑闭环。
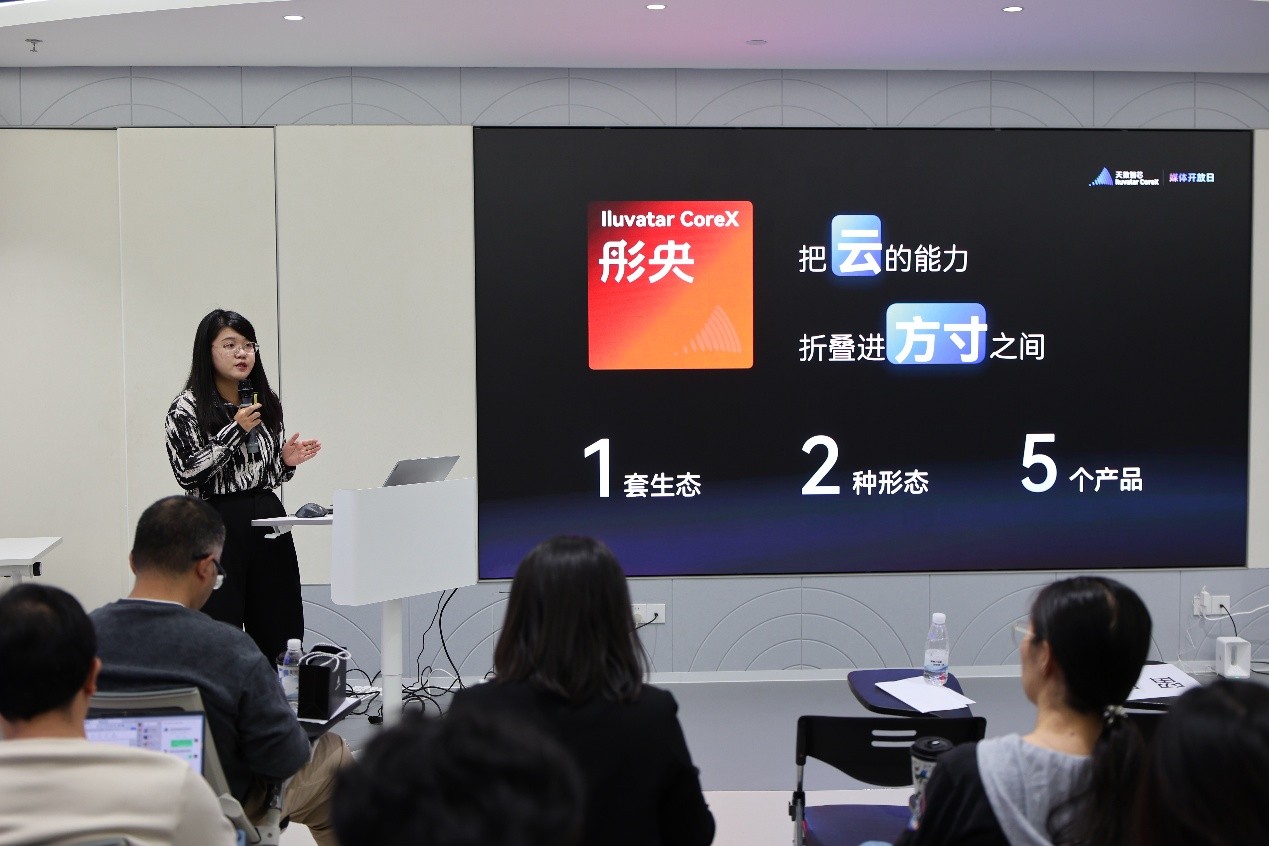
“云端GPU厂商做端侧,不是把芯片做小,而是把能力下沉。”天数智芯彤央产品市场负责人宋远盈表示。模型压缩、量化、蒸馏、软硬协同——这些让大模型在有限算力上“跑得又快又好”的能力,全部诞生于云端训练侧;连同通用GPU架构、编译器、算子库和性能工具,被一起带到边端。模型因此可以“生在云、长在边”:云端训练、边端部署,需要时再由云端复判,精度对齐、不割裂、不重训。
落到产品上,彤央以“1+2+5”展开:一套生态、两种形态、五款产品。其中旗舰终端TY1200标称300 TOPS稠密算力——而非行业惯用的稀疏峰值;在Qwen3.8-27B、Qwen3.6-35B-A3B等大模型实测中,性能达到英伟达Thor T5000的1.2倍。以实测稠密算力超越标称更高的对手,端侧的有效产出,不被纸面算力定义。
从视频生成到合同审核:端侧算力的真实战场
开放日上的演示全部离线运行。基于
物理AI的负载同样在本地跑通:在英伟达开源的Cosmos-R2-2B、Cosmos-R2-8B世界模型测试中,TY1200实测性能分别达到Thor T5000的158%和180%。一只搭载TY1000算力模组的机器狗,则在人群中认出并跟上主人,“感知—决策—行动”的闭环全部跑在本地。
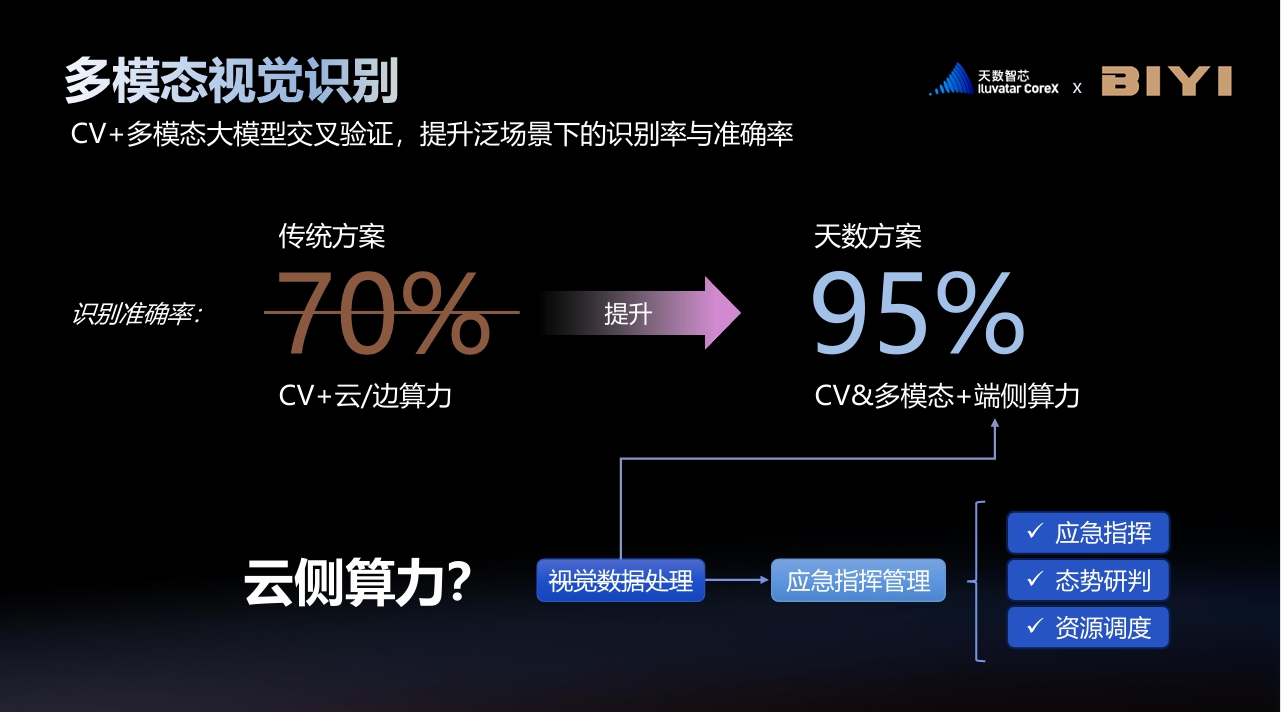
产业端的落地更进一步。天数智芯联合河海大学新能源学院与常州电池协会,首发面向储能电芯研究的垂直AI智能体,实验数据“产生即治理”,约2分钟即可生成分析报告;在应急管理中,“CV+多模态”交叉验证将烟火识别准确率从70%提升至95%,让云侧算力回归决策;在博物馆,同一台设备白天做智能导览、夜晚训练CV小模型。而在上海市阳光康复中心,一台搭载TY1200的陪诊机器人已经上岗,为视障人士导诊、分诊、带路——这或许回答了“算力为了什么”。
此前,TY1200已获2026工博会CIIF国芯展创新成果奖;活动尾声,天数智芯预告了标称算力达600T的下一代端侧产品TY2000。
对于备受关注的具身智能芯片,天数智芯副总裁郭为坦言,目前市面上所有芯片“其实都不太适合”具身场景——更大的算力、更高的能效比、更关键的实时性,是所有厂商定义下一代芯片的共同方向。副总裁邹翾则回应了与专用机器人芯片厂商的比较:“这个跟企业基因有关系,我们有自己的优势。战场在未来,不在今天。”
产业趋势也在为这一判断注脚:从黄仁勋在GTC上力推物理AI,到国家“人工智能+”行动对智能终端场景应用的部署,端侧算力正从边缘角色走向产业前台。
云端高效生产智能,软件加速进化,端侧拓宽应用、连接物理世界——算力分层,不是某家公司的技术路线,而是算力本来就该有的样子:每一份算力,都待在它最能创造价值的位置上。
















