获10亿美元A轮融资,Flapping Airplanes要破解AI的“数据饥渴”
目前AI行业的发展速度,受到算力和数据两大核心要素的限制。
AI模型的训练和推理,都面临算力不足的情况,也有一批新兴的芯片/infra公司试图解决这个问题。
数据的限制则更复杂些。在Scaling law的推动下,当前的AI模型几乎穷尽了所有可获取的人类公开数据来训练。在现有范式下继续让模型进步,数据就可能出现短缺。
而数据短缺的深层原因,在于现有模型范式的数据效率不足,或者说样本学习效率不足。例如,人脑通常只需要学习几个例子,就能学会新技能,而AI模型要学习相似的技能,则需要巨量的样本来训练,无论在预训练阶段还是后训练阶段。据测算,AI模型和人脑的样本学习效率,相差几个数量级。
要跨越这道效率鸿沟,必须依靠颠覆性的底层创新。
Flapping Airplanes就正在试图跨越这道鸿沟,它们的长期目标是重新设计损失函数,重构梯度下降算法,构建学习效率达到人脑级别的AI模型。
今年1月,Flapping Airplanes获得1.8亿美元的种子轮融资,GV、Sequoia Capital和Index Ventures是主要投资者,今年10月,它又获得由Index与Lux Capital领投的10亿美元A轮融资。
参与这两轮的机构投资者还包括Nova Global 、Valor、Atreides、Kleiner Perkins、Fundomo、Steve Cohen、BCV、Menlo Ventures、Hummingbird、Victor Lazarte、Absolute Ventures、A*、CRV、Seven Stars、Genesis、Jump Trading、XTX Ventures、Snowy Leopard和NVIDIA。
Jeff Dean、Stanley Druckenmiller、Katie Haun、Andrej Karpathy、Henry Kravis、Micky Malka、Chris Ré等行业顶尖领袖也以个人投资者身份参投。
先“榨干”GPU,再重构AI的样本学习效率
Flapping Airplanes由Ben Spector( 25 岁) 、Asher Spector(26 岁)兄弟和Aidan Smith联合创立。Ben Spector在斯坦福大学攻读计算机科学博士学位,此前在MIT就读期间创立了孵化器Prod;Asher Spector是斯坦福大学统计学博士;Smith曾有过创业经历,也是Thiel Fellow,在大学期间就曾在Neuralink工作过3年。
Ben Spector是创始团队的核心人物,他创立的孵化器Prod曾助力Cursor、Decagon、Etched和Decart等一众明星 AI公司的创始团队起步。他的投资人透露,哪怕Ben的同龄人们已经做出了估值数十亿美元的独角兽,依然会向他寻求观点,他具有直击问题本质、重新框定商业机遇的认知能力。
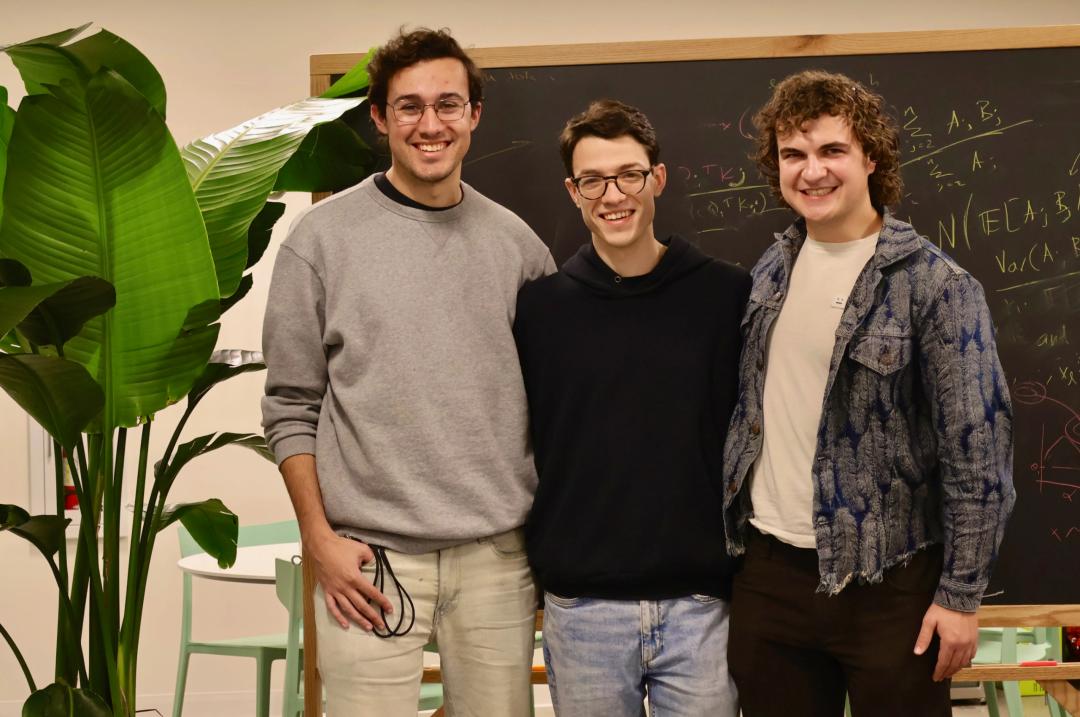
Flapping Airplanes创始团队,左一为Ben Spector,图片来源:Flapping Airplanes
另一方面,Ben Spector在斯坦福师从Chris Ré教授(独角兽SambaNova Systems和Together AI的Co-founder)做了一系列有影响力的研究(多次担任论文一作),研究主要专注于“榨干”GPU的算力,其中Megakernel是一个主要成果,也是Flapping Airplanes目前相对成熟的核心技术。
在2025年的一篇技术博客中,Ben Spector和团队详细拆解了怎样让H100推理Llama-1B的速度狂飙。
他们认为,AI系统性能的高低取决于能否不间断地从GPU全局显存中加载模型权重。目前主流大模型推理计算引擎(如 vLLM 和 SGLang)最多只能发挥出GPU可用显存带宽的50%。
为什么他们未能跑满GPU的带宽?核心问题在于,当前基于独立内核的模型运行方式会频繁引入停顿,打断了显存的连续加载。
具体来说,现有系统会将模型的一次前向传播切分为大约100个独立的算子内核(kernel),每个内核仅执行寥寥数个操作(例如注意力计算、MLP层加激活函数、旋转位置编码等)。
而且这种机制还伴随几个问题,例如, GPU内核按严格的先后顺序启动,前一个内核中的所有线程块彻底执行完毕之前,后一个内核中的任何线程块都无法启动。因此,每次启动新内核时,系统都必须等待前一个内核中运行最慢的线程块收尾。
即便成功启动了下一个内核,在真正开始计算之前,仍然必须等待权重和激活值加载完毕。这些延迟会让GPU空转数千个时钟周期。
在此期间,GPU无法执行任何有效工作——例如,至关重要的“模型权重加载”任务就会因此被迫中断。
要解决这些问题,Ben Spector团队的思路,是把整个模型的前向传播合并进一个单一的“megakernel”(超大内核),尽可能消除不同内核之间的切换和等待。
要做到这一点,他们首先解决了如何在一个内核中组织上百个算子的难点。团队在GPU内部设计了一套解释器,把Llama模型的主要计算归纳为7类指令,并提前为每个 SM(Streaming Multiprocessor,流式多处理器)安排好执行顺序。这样,GPU可以在一个持续运行的kernel内依次完成整套前向传播,而不必不断退出一个kernel,再启动下一个。
另一个难点是共享内存。为了让下一条指令在前一条指令尚未完全结束时就提前加载权重,他们把每个SM有限的共享内存切分成多个16KiB的页面。不同指令按需申请和释放这些页面,一旦有页面空出来,就立即交给后续指令使用。这样一来,下一步所需的权重可以提前加载,并与前面的计算和数据写回重叠,从而减少GPU等待显存数据的时间。
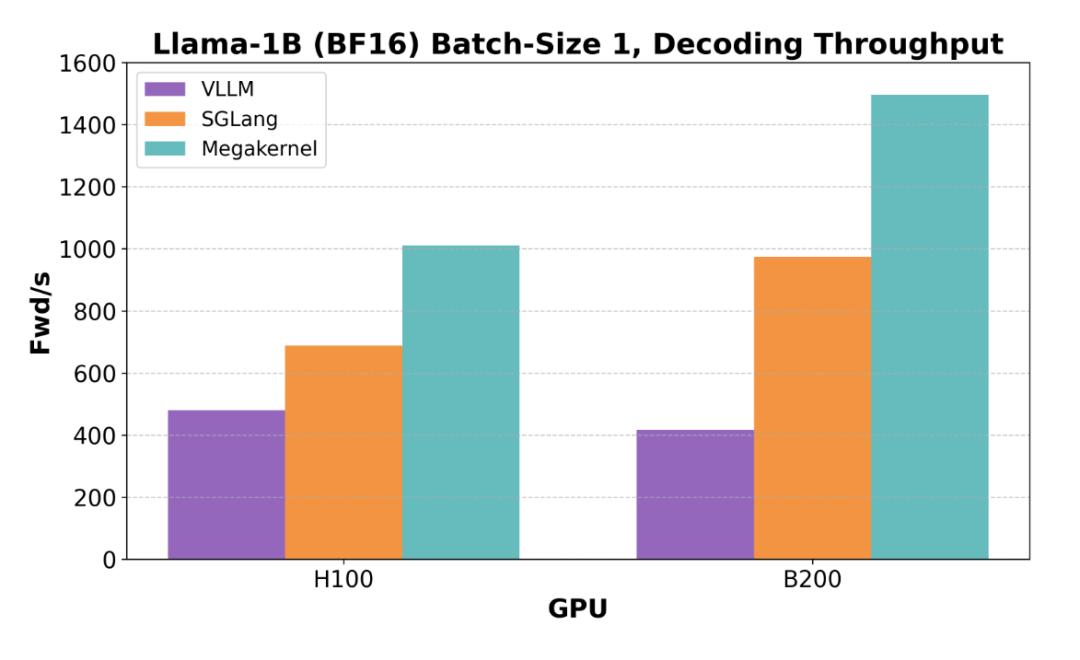
megakernel榨干了GPU性能,图片来源:hazyresearch
在H100上,这套Megakernel将显存带宽利用率提高到了78%。在同样的Llama-3.2-1B低延迟推理任务中,其速度接近vLLM的2.5倍,并首次将10亿参数以上、16位精度语言模型的单次前向传播压到1毫秒以内。
在Flapping Airplanes,Megakernel成为了一个更完整的框架,借助这套框架能够支持非常规的模型架构、目标函数与优化器,并在同一个内核中,将受限于显存带宽的推理计算与受限于算力的模型训练重叠并行。目前,该框架已能独立执行完整的模型训练、提供推理计算服务、运行视频游戏,甚至可以在单一内核中同时执行这三项任务。
但megakernel并不是他们的终点,他们的第二阶段要做一件更本质的事情,探索AI的全新技术路径,甚至重新设计损失函数,重构梯度下降(gradient descent)算法,以构建样本学习效率更高的AI模型。Flapping Airplanes表示这套系统已经在万亿参数级预训练规模上得到内部验证。
这个构想背后的思考,来自团队对人脑与现有AI模型样本学习效率的比较。人类的大脑只需要少量样本就能学习一项新技能,而现有模型能够调动极其广博的知识库,但它们很难快速掌握新技能,哪怕做一点适应性调整都需要灌入海量数据。
而且人脑本身其实面临着极其苛刻的生理限制,它的神经元触发一次动作电位(action potential)需要1毫秒,而在这1毫秒内,现代计算机已经能执行天文数字般的运算。
如果能够让模型具有类似人脑的样本数据学习效率,并叠加现代的AI算力规模,从长远看,可以创造出在效率和性能上全面超越人脑的机器智能。
为此,团队打通了整个技术栈,从运行在 GPU 上的底层内核,到预训练、后训练,再到推理,他们对各层级进行协同优化,这是他们坚信的一个规律:最重大的算法突破,往往都建立在底层硬件交互方式革新的基础之上。
一旦他们第二阶段的构想实现,将释放出巨大的商业价值。现有AI模型的样本学习效率不足,限制了它向细分领域渗透的广度和深度——因为许多高价值的细分领域本身缺乏数据,不足以支撑大规模训练。
可以设想,如果模型的数据学习效率能提升100倍,那么它落地实际商业场景的门槛,大概也会随之降低100倍。
无论是科学研究、物理AI,还是其他重要却缺乏数据的垂直领域,都将解锁新的可能。
举个最简单的例子,他们的研究能让后训练阶段的效率实现数量级跃升。届时,只需寥寥几个样本,模型就能迅速切入并胜任一个全新的垂直领域。
下一代AI,从改变学习机制开始
Transformer架构诞生已经接近十年,生成式AI的爆发也已经四年,OpenAI和Anthropic已经万亿美元估值。但一方面AI并没有像预期的那样真的在各个方面提升细分领域的商业表现,另一方面,AI公司始终算不明白账:在获得了巨额的收入后,却又要为训练下一代更强的模型付出天量的成本。
这是Scaling law的双刃剑:添加算力,添加数据,你就能获得越来越强的性能,但模型训练成本却又是一个无底洞。
归根结底,这个问题产生的原因,还是AI的数据效率低,或更本质的说,学习效率低。
在继续Scale和研究之间,不少neolab选择了研究,比如Ilya Sutskever和他的SSI,押注的是“人类式学习器”,能够用很少的经验快速学习、持续学习,并把学到的东西泛化到新场景。
前Google DeepMind研究员David Silver创立的Ineffable Intelligence走的是强化学习路线,而且它很激进,想要训练一种完全摆脱人类数据依赖、纯靠试错机制进行学习的新型AI。
很巧的是,SSI、Ineffable Intelligence、Flapping Airplanes,都在单轮获得了10亿美元以上的融资,由此可见硅谷的投资人们,对于新型模型的渴望(或者说焦虑)。
焦虑在哪儿?还是在于AI的商业化。现有的模型架构,很难解决单位经济学的问题,这就导致公司用户越多,AI用量越大,就越亏损,边际成本很难降低。
而一旦突破单位经济学的限制,就可能出现一个良性的循环:技术的成本越低,应用率就会越高,应用范围会越广。这将使整个生态都受益,无论是模型厂商,还是AI应用公司。
什么样的团队更容易突破这个限制?观察这些neolab可以发现,这类团队往往极具创造力,也不太受传统经验束缚,而且成员普遍比较年轻。正因为没有被既有路径限制住,他们才更有可能从零开始,重新思考并彻底重构问题。
本文来自微信公众号“阿尔法公社”(ID:alphastartups),作者:发现非凡创业者的,36氪经授权发布。
















