AI推理进入Token成本时代,熵旋芯智押注MRAM存内计算
2026年3月,我国日均Token调用量已超过140万亿,较2025年底增长逾40%。随着人工智能从对话问答走向智能体、编程辅助和企业级应用,大模型推理正逐渐成为一项需要持续运营的基础服务。
调用规模不断扩大,也让AI产业开始重新审视推理成本。
过去,衡量AI芯片性能往往首先关注峰值算力。但在实际推理过程中,系统既要执行大量矩阵运算,也要持续读取模型权重和KV Cache,还需要完成芯片间的数据传输与任务调度。计算资源能否充分利用、存储带宽是否充足、通信能否高效组织,共同决定了一套系统能够以多少成本生成Token。
尤其在逐Token生成的Decode阶段,较小批量的推理任务往往难以充分摊薄模型权重读取开销。随着模型规模和上下文长度增长,单纯提高芯片峰值算力,并不一定能够带来同比例的实际吞吐提升。
一家成立于2026年的芯片公司,正试图从计算与存储的结合方式入手,寻找新的成本优化路径。
熵旋芯智提出首代MRAM存内计算架构MITA(MRAM In-Memory Tensor Architecture),并将基于该架构的专用处理单元命名为MPU(MRAM-based Processing Unit)。
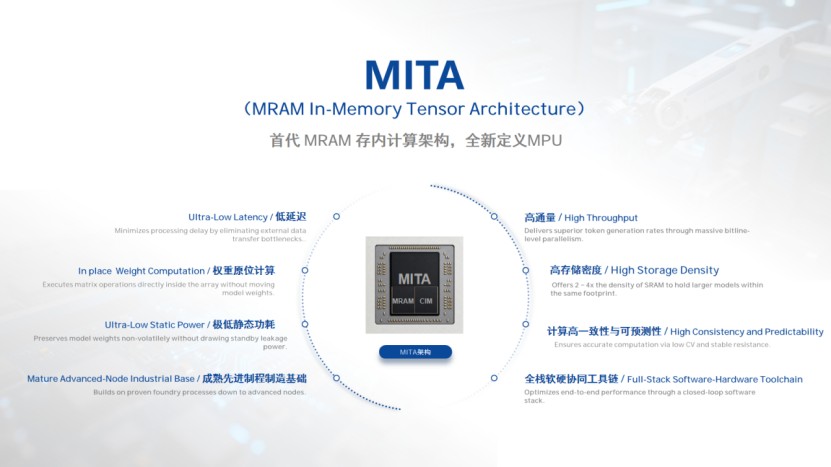
与传统计算单元和存储单元相对分离的设计不同,MITA计划将适合映射的模型权重存储于片上MRAM阵列,让输入激活数据进入阵列后,利用权重对应的器件状态直接参与矩阵运算。
其核心思路不只是减少数据搬运距离,而是将权重存储与部分计算过程融合,在减少重复权重访问的同时,探索提升计算密度与能效。
这一技术路线瞄准了大模型中具有代表性的权重密集型负载——前馈网络(FFN),尤其是MoE模型中的专家计算。
MoE模型通过路由器为每个Token动态选择少量专家执行计算,使模型能够扩展参数规模,同时控制单Token激活的计算量。但大量专家权重需要存储,专家调用又具有稀疏性和动态性,单个专家获得的Token批量可能较小,传统矩阵计算架构的利用效率因而面临挑战。
MITA尝试让专家权重常驻MRAM阵列,并直接在存储位置参与运算。对于反复调用、单专家批量较小的计算任务,这种方式有机会降低权重访问开销,形成不同于传统GPU计算的效率优势。
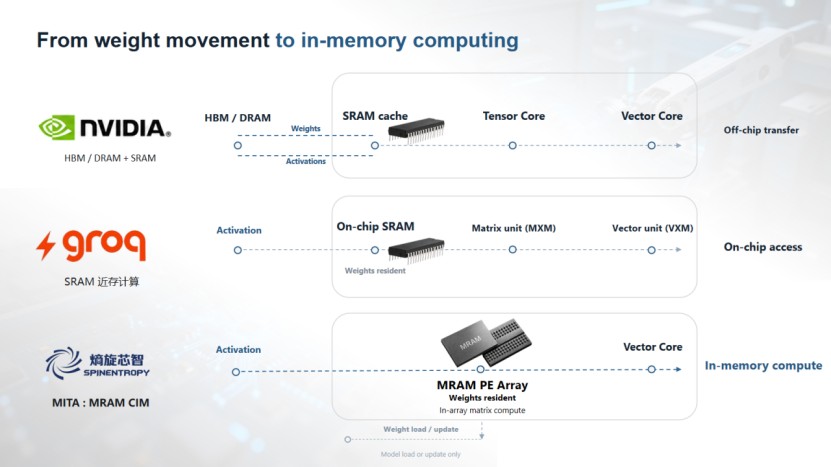
熵旋芯智计划将MPU作为专用加速模块接入现有推理系统,与GPU及其他计算单元协同执行不同任务,而非全面替代GPU。
不过,片上权重容量、外围读出电路、多芯片互联和异构通信仍然影响系统收益。尤其当GPU与MPU分别承担注意力和FFN计算时,设备之间的激活传输与同步延迟,也需要纳入端到端性能评估。
熵旋芯智将单位Token推理成本降低90%作为中长期技术与商业目标。该数字仍属于目标,而非已完成的产品实测结果。未来需要在明确GPU对照系统、固定模型、精度、并发、上下文长度与服务质量要求后,综合验证实际吞吐、设备投入、功耗、通信及运维成本。
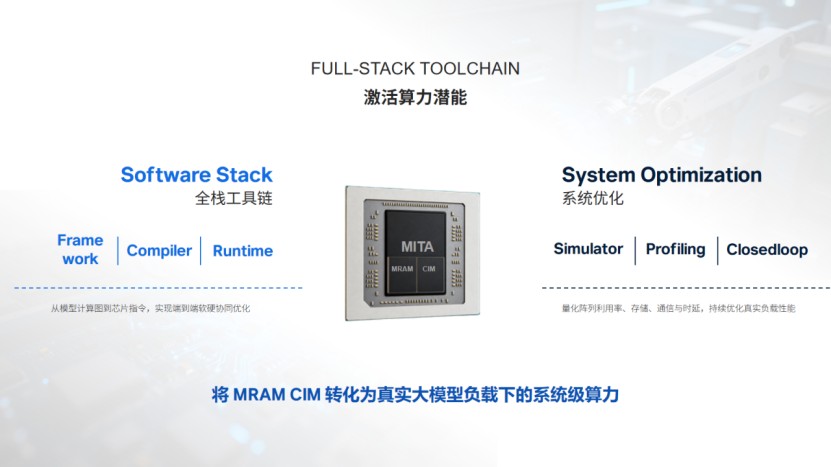
对于云端推理服务商而言,真正重要的不是单颗芯片的理论峰值算力,而是整个系统能否持续提供更具成本竞争力的有效算力。
熵旋芯智希望借助MRAM存内计算,将权重存储与计算融合所带来的架构潜力,转化为可以量化的单位Token成本优势。随着AI应用进入规模化运营阶段,这也为新型推理芯片提供了新的竞争机会。
















