这个中国具身模型,正成为海外研究物理世界的新起点
本文转载自公众号“具身智能之心”。
一个具身模型真正形成影响,不是发布当天有多热闹,而是在发布之后还能继续生长,甚至会出现第二增长曲线。
最近,我们在海外论文、开源框架和开发者社区里,反复看到了同一个中国模型系列。
它就是蚂蚁灵波的LingBot,尽管发布已有一段时间,但它陆续被写进其他团队的论文,成为后续工作的比较基线;研究者拆开它们,测试内部机制,在原有模型上增加新的能力;开发者则把它们移植到新的框架、芯片和设备上。
原团队完成了第一次发布,海外研究者和外部社区接过了后面的研发。技术也由此离开自己的演示和榜单,进入别人的基线与研发 Loop。
截至目前,LingBot 家族七个模型方向,累计在GitHub获得近 3.3 万颗 Star、超过 3,200 次 Fork。
比数字更值得关注的是,这个中国模型,正成为一部分海外团队研究物理世界的新起点。也让我们想继续追踪:外部团队为什么选择 LingBot 作为起点,又在它的基础上,尝试解决哪些原先没有解决的问题?
01. 研究“如何遗忘”,先找到真正能记住的模型
世界模型最容易被看见的,是生成出来的那几秒:画面够不够真实,相机移动是否自然。
但时间一旦拉长,难题就变了。这一帧看起来合理还不够,整个世界必须记得自己曾经发生过什么。
英伟达在SANA-WM和Cosmos 3中,分别选择LingBot-World比较生成质量和相机控制效果。两项工作关注的问题不同,却都把它放进了对比实验。后来者需要证明自己的世界模型做得怎么样,LingBot-World已经成为一个能够帮助其说明结果的参照坐标。
但被拿来比较,只是第一步。
南洋理工大学、清华大学和普林斯顿大学联合提出DeCoPrune时,遇到了一个更具体的问题:世界模型生成得越久,需要保存的历史信息就越多,推理负担也会随之增加。
最直接的办法是删除一部分历史缓存。可删掉哪些信息,模型才不会忘记之前出现过的人和物?
有意思的是,要研究一个世界模型可以忘掉多少,首先得找到一个真正记得住的模型。
研究团队最初考察了LongLive、Self-Forcing和Causal Forcing。但在测试中,即使完整保留历史信息,这些模型也经常无法还原此前出现过的目标。模型原本就没有稳定记住,再讨论应该删除哪些记忆,实验也就失去了基础。
LingBot-World 2.0在同样的测试中,更能找回此前出现的目标,因此被选为DeCoPrune的主要实验模型。
外部团队选择LingBot-World,并非只因为它能生成符合物理规律的画面,也因为它已有的长时记忆能力,让一个新的研究问题得以成立。
以此为基础,DeCoPrune后面继续分析哪些历史KV Token可以删除、哪些必须保留。
改造后的续生成速度达到完整保留历史方案的4.14倍,同时尽量维持对早期目标的召回能力。
省下记忆开销之后,还有另一个点需要关注:记住角色的样子,与记住它已经被击倒,是两回事。
镜头转开再回来,倒下的角色不能又若无其事地站起来。
这个事情很适合游戏这个领域,日本的Alaya Lab就在做这个事情。
他们引入明确的状态记录:引擎记住角色的位置与状态,再通过新增的控制模块,把这些信息传给 LingBot-World v1,让它生成对应画面。
两项工作接上了同一个问题:怎样让生成持续下去,又不丢掉已经发生的事实。DeCoPrune 降低保存历史的代价,Alaya 则增加明确的规则与状态约束。
这也让 LingBot 的一个技术特点变得更清晰:在世界模型方向,它不仅能被用来比较生成效果,也提供了一个可以继续研究记忆、效率与状态控制的基础。
02. 对未来的判断,开始接受真实动作的检验
外部团队给世界模型补记忆和规则,到了机器人这里,他们开始借助 LingBot 的行动模型,研究预测怎样帮助机器人做成任务,并将探索延伸到新任务学习和硬件运行。
LingBot-VA 提供了一个具体起点:将视频预测与逆动力学结合,让模型学习未
英伟达团队在设计 DreamZero 时,也将这条路径放进了架构选择的讨论:视频预测与动作生成如何配合,是延续分解的方式,还是交给单个模型联合完成?他们选择了后者,LingBot-VA则成为这一选择的技术参照。
有了预测与动作之间的联系,研究团队就能进一步拆开看:哪些预测真正影响了执行?
澳大利亚国立大学和北京师范大学联合提出的 RIFT,就在研究这个问题。
希望先弄清动作模块用了哪些未来信息,他们选取包括 LingBot-VA 在内的四个模型,遮住、替换或打乱内部的未来信息,再观察任务表现。干预后,动作发生变化、成功率下降,说明这些信息确实参与了决策。这也让计算优化有了方向:保留对行动有用的信息,能否省去逐步生成视频的开销?机器人需要预判,但未必需要等每个画面细节都算完。
这些工作在拆解行动机制,而另一些探索则关注使用成本:新任务要教多久,动作要等多久。
Generalist 的 GEN-1.5 尝试用一次几秒钟的示范作为提示,让机器人无需更新权重就能学习短时任务。在讨论怎样降低新任务学习成本时,也将 LingBot-VA 2.0 的少样本适配研究纳入参照。
General Instinct 的 InstinctFlash 则支持 LingBot-VLA-4B 和 LingBot-VLA-V2-6B,并公开 Jetson Thor 上的优化配置与测试,让开发者有据可查、有代码可以继续优化。
03. 感知模型走向更多开发者和场景
世界生成和动作之外,LingBot 在感知方向也被纳入到具体工具与二创项目中。
桌上有一只玻璃杯,人一眼就能看见。机器人想伸手去拿,还得分清杯沿、量准距离;如果要穿过房间送过去,又得记住沿途的空间。
我们之前写透明物体感知时,就说过这个难处,它藏在这些看似简单的步骤里。
LingBot-Vision 分清了画面中的轮廓、形状和区域关系,而且成功进入了timm。
在timm 中,开发者可以通过统一接口提取这些信息,用于区分物体、估计深度等任务。
但看得见,还不一定量得准。
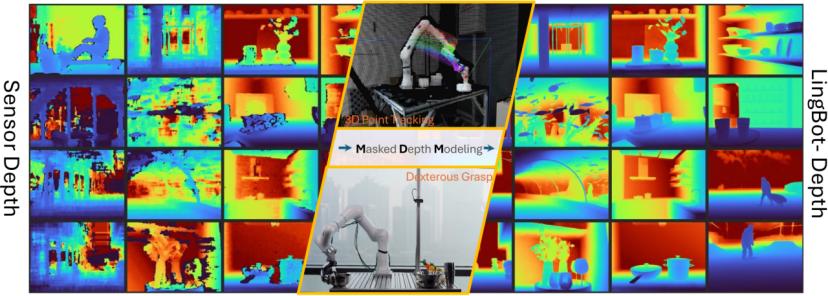
玻璃、镜面和反光金属经常让深度相机犯难:彩色画面里明明有东西,深度图上却缺了一块。
奥比中光与灵波联合推出了适配 Gemini 330 系列相机的 LingBot 深度增强引擎,并将这项能力集成进 Orbbec SDK,结合彩色与深度信息减少噪声、填补缺失、改善边缘。
开发者使用相机时,就可以调用这项能力,看看那些难测的物体能否被更准确地还原。
然而,机器人真的部署到场景下还有一个记忆问题。
换个角度,模型还能认出这是同一个桌角吗?刚才经过的门,总不能一出画面就“忘了”。
LingBot-Map 的办法是给记忆分个轻重:出发时的参照要留住,最近看到的细节要看清,更早的观察则压缩成轨迹记忆。这样,新画面来了有据可对,走过的空间也有迹可循,不必把每一帧都原封不动地存下来。
既能留住有效信息,还能减少存储开支。
而更有意思的是,这个map工作已经被社区用起来了,甚至都在二次开发。
外部开发者补上视频导入、三维查看等功能,从而拿到自己的重建空间,支持各类下游应用。
我们看到,从杯沿到距离,再到走过的空间,这些能力开始面对使用者自己的场景,也有了更具体的检验方式。
04. 进入常用框架,才更容易留在日常研发里
从感知、世界生成到行动,LingBot 已经进入外部团队的研究与改造过程。而要让更多人接着做,除了模型本身,还需要可复用的训练、评估和部署流程。
我们又翻了翻几个开源框架的文档,发现 LingBot 的训练、评估和部署,也开始有了现成的流程可以参考。
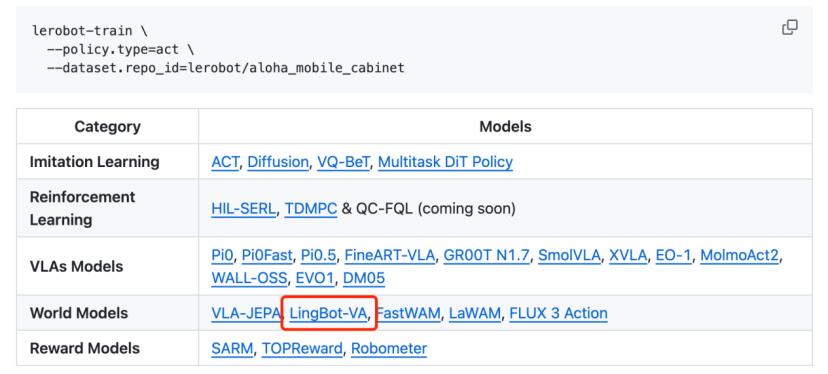
开发者可以在 LeRobot 中尝试它,用SGLang 部署它,还有AWS Labs 提供的现成云部署路径。
之前,一个模型即使公开了代码和权重,使用者仍然可能要自己配环境、改接口、整理数据。
接入熟悉的框架后,这些准备工作就有机会被复用,开发者也能更早开始验证自己的想法。
在工程上的应用,也能增加更多可能。
LingBot-VA 被纳入 v0.6.0 后,开发者可以保存模型预测的未来视频,与机器人实际执行的画面对照。一次动作失败,除了知道“没做成”,研究者还能检查模型预想的过程与现实在哪里出现了偏差。
这种能力,能让模型更深入地参与反复实验、检查和修改,而不只是完成一次运行。
部署环节也类似。
LingBot-World 2.0 在发布当天就获得了 SGLang 支持。SGLang 也为 LingBot-Video 提供了推理管线和部署文档,让开发者可以通过这一通用框架运行视频模型。
AWS Labs 的 world-models-inference 项目,则把 LingBot-World-Fast 设为默认
这些接入,省下了不少配环境、改接口的重复工作。
不过,真要在自己手边的设备上运行,开发者还得面对具体的内存、速度和操作体验问题。
05. 为了在自己的电脑上跑起来,开发者各有办法
让一台 Mac 生成几秒钟的“世界”,要等多久?
PandacatAI 的一次测试给出了答案:6.8 秒的视频,生成用了 14.4 分钟。 足够起身泡杯茶,回来再等等。
他把 LingBot-World 2.0 的 1.3B 版本适配到苹果芯片上,通过及时腾出内存、分块处理视频,让一台配备 48GB 统一内存的 M4 Pro 完成了生成。
代码、配置和内存记录都已公开,这样下一位开发者就可以在此基础上继续提速。
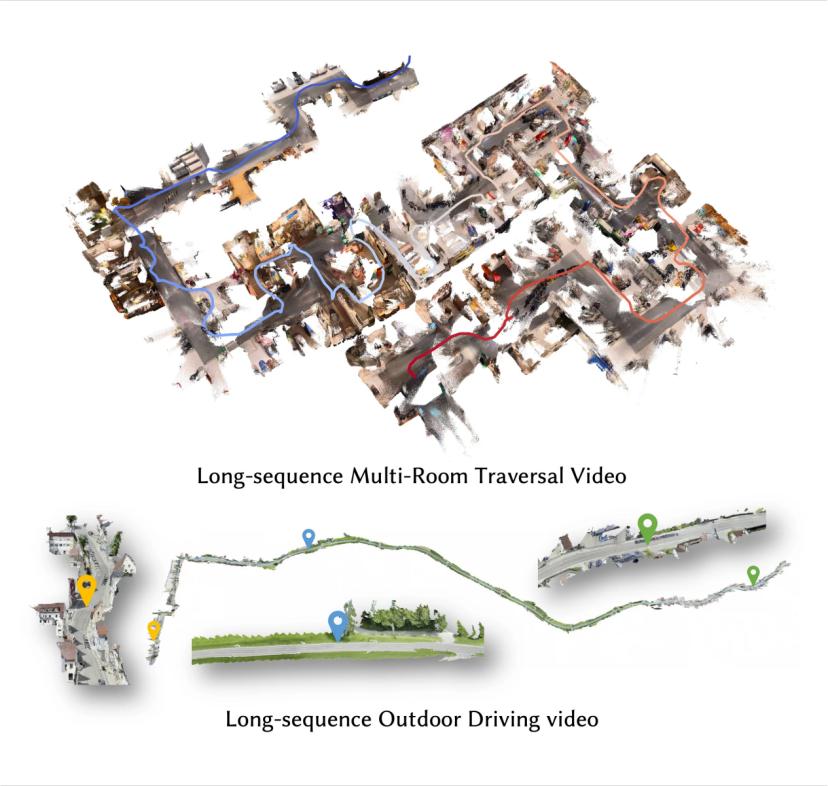
Don Allen III 则围绕三维重建能力做了一个 Mac 桌面工具。
用户把视频拖进窗口,查看处理进度,完成后就能旋转、俯瞰和保存重建结果。模型的能力,被整理成了创作者能够直接操作的流程。
类似的尝试也出现在 ComfyUI 社区。
RealRebelAI 将 LingBot-World v2 接进节点工作流,让用户输入图片、安排相机移动路线,再生成对应视频,并通过量化和按层加载尝试让它在 RTX 3070 8GB 上运行。
这些尝试虽然没有到产品级测试规模,但它们留下的却不只是几次成功运行,还有很多工程和应用上的线索和复用接口。
下一位开发者不必再从原始仓库起步,可以沿着这些已有路径继续优化,或者开发新的应用。
开源社区的价值,往往就在这里:让一次探索留下足够多的信息,使下一次探索不必重新开始。
06. 结语
一个具身模型的持续价值,会在别人愿意基于它继续做什么的过程中,变得越来越清楚。
LingBot 这组案例给我们的启发,是模型能力和开放生态之间存在很具体的联系。
生成质量足够有代表性,后来者才有理由拿它做参照;内部机制能够被研究,新的假设才有机会被验证;代码和权重可以继续使用,开发者才可能把成果带到不同设备上。
而每一次采用,又会带来原团队未必预先设计好的问题。研究者要求它更好地保存历史,应用团队要求世界遵守规则,个人开发者希望在自己的电脑上完成一次生成。
这些需求会暴露不足,也会推动新的改进。
这或许是 LingBot 系列目前最值得关注的地方:它开始成为一部分海外研究探索物理世界的新起点。
它提供的感知、生成与行动能力,让不同团队能够从各自关心的问题出发,继续向前走。
至于这条曲线能走多远,还要看这些使用能否持续,改进能否被复用,以及更多真实问题能否在它的基础上得到解决。
















