刚刚,全网霸屏的神秘太空兔揭晓,来自 MiniMax 新模型
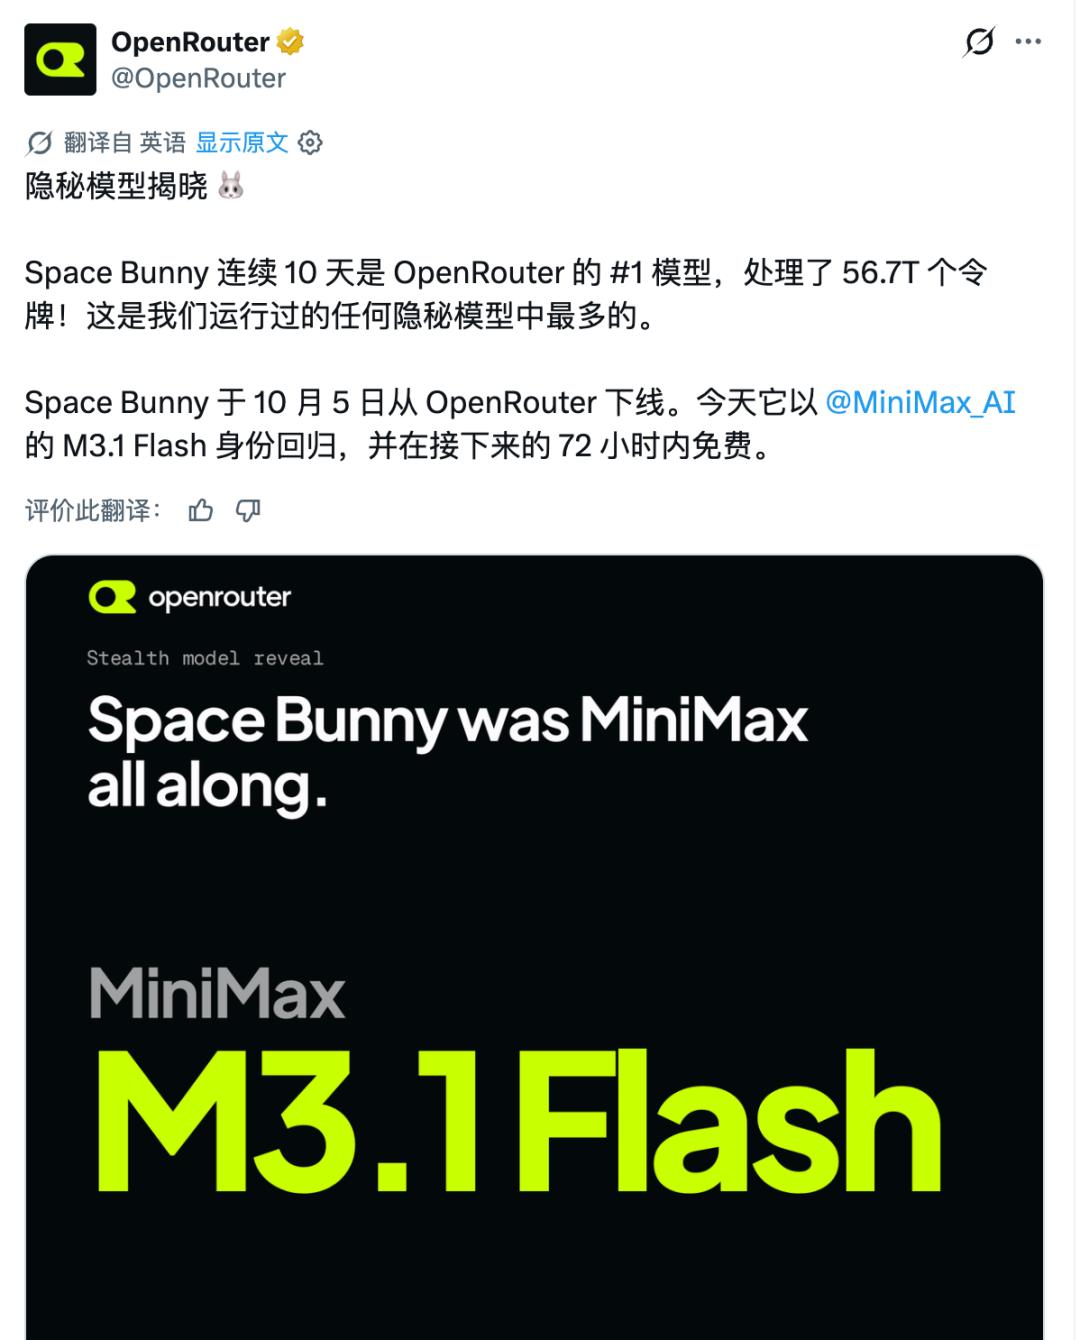
神秘太空兔,终于被认领了。
就在刚刚,
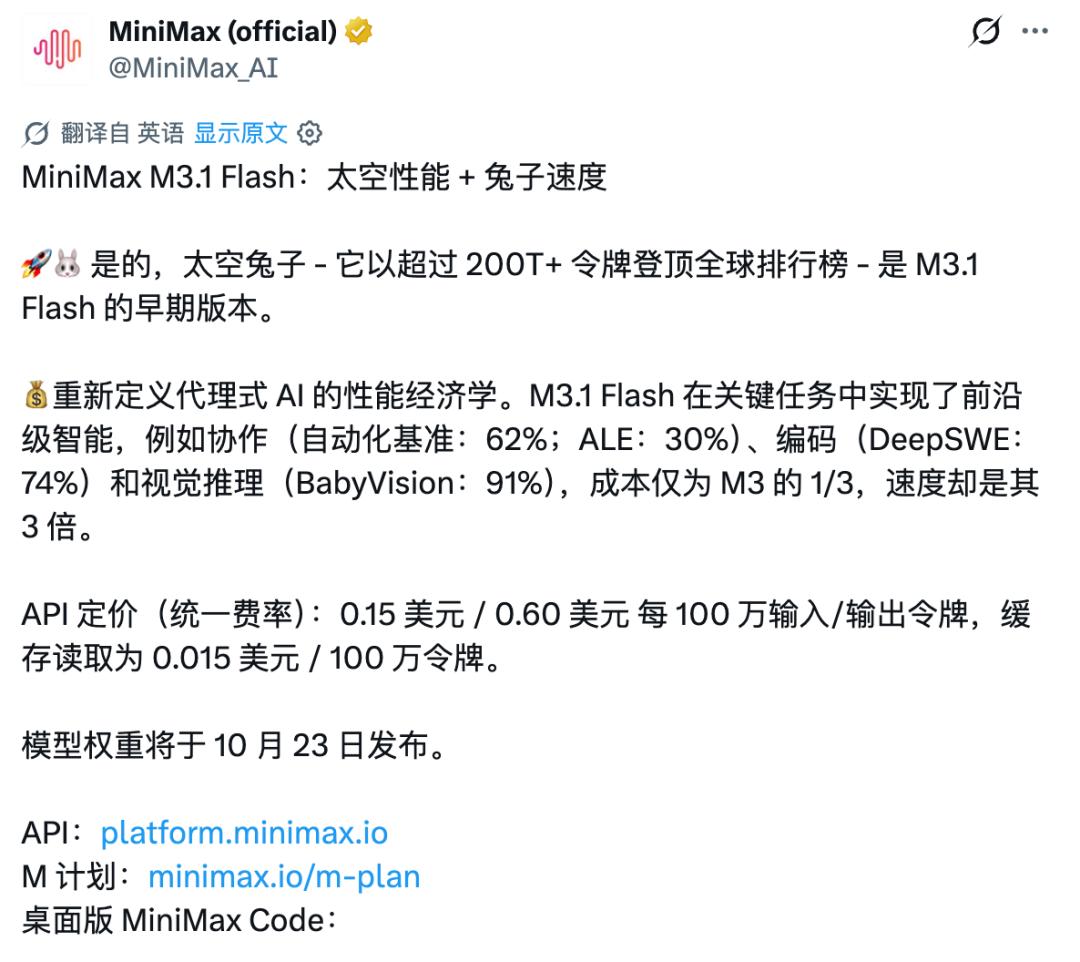
据官方介绍,M3.1 Flash 在复杂 Agent 任务、编程、电脑操作及网络安全等方面实现了代际提升,线上推理速度提升近 3 倍,Agent 类任务的综合使用成本较前代降低 70%。
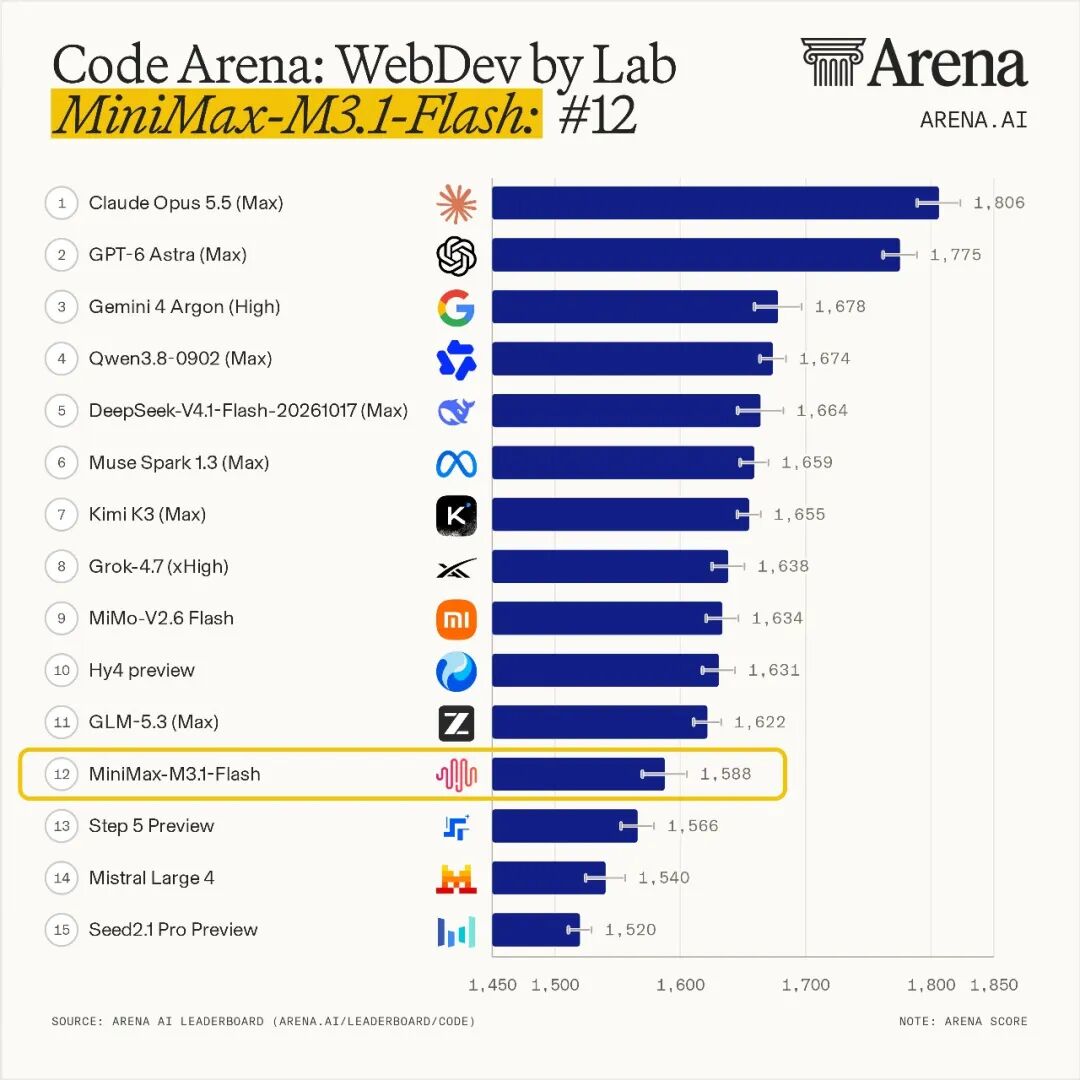
随着 AI 开始操作软件、编写代码和执行企业工作流,完成一次任务所需的多步推理与工具调用,也让速度和费用变得更加重要。
此次发布中,
根据官方公布的评测表,M3.1 Flash 在 Automation-Bench v1.0.6 中取得 62.2 分,高于
该测试采用 600 个任务,考察模型在跨 SaaS 系统的企业业务流程中,处理销售、营销、运营、客服、财务和人力资源等工作的能力。
在涉及多步骤规划、跨文档一致性、金融业务合规和连续工具调用的 BankerToolBench 中,M3.1 Flash 取得 76.2 分,与 Opus 5 并列。长上下文任务评测 LOCA-Bench 256K 中,其成绩为 60.3 分,略高于 GPT-5.6 Sol 的 60.0 分。
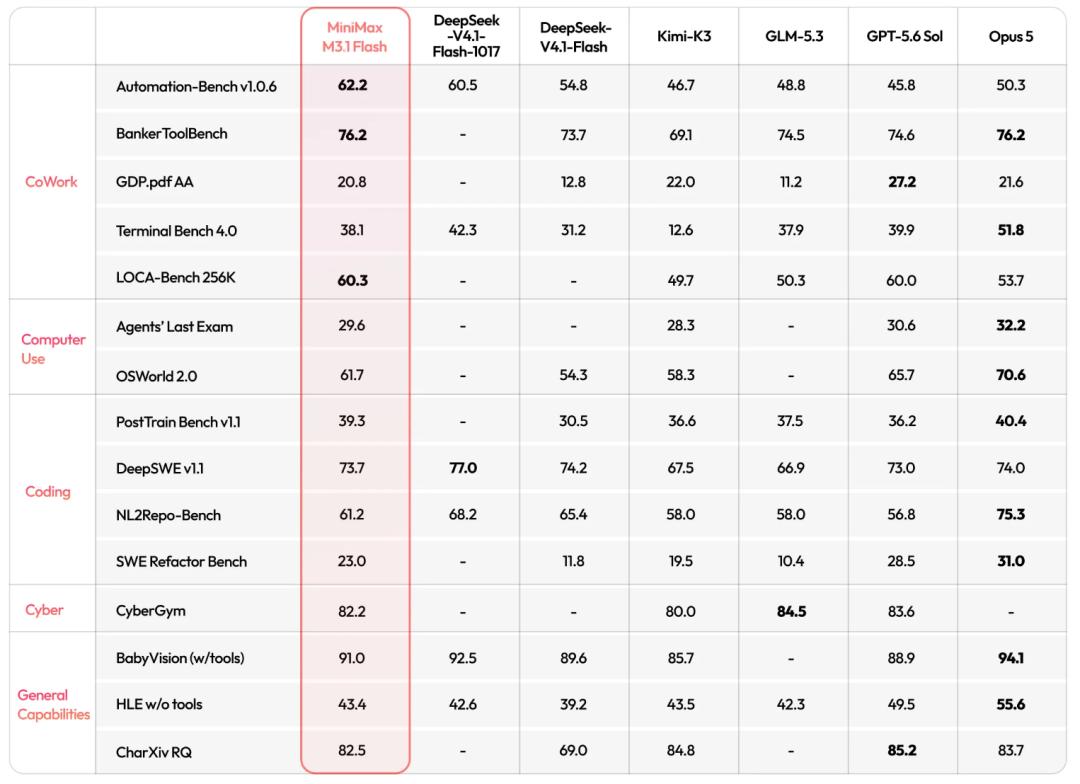
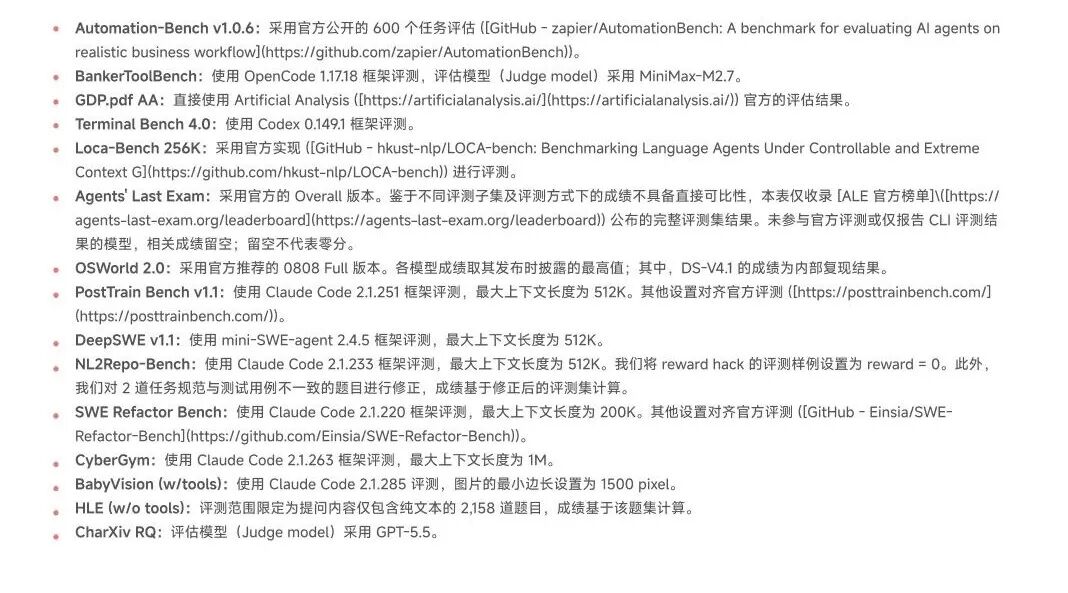
软件开发方面,M3.1 Flash 在 DeepSWE v1.1 中取得 73.7% 的成绩,接近 Opus 5 的 74.0%,高于 GPT-5.6 Sol 的 73.0%,低于
电脑操作同样是此次更新的重点。
M3.1 Flash 在 OSWorld 2.0 中取得 61.7 分,在 Agents' Last Exam(ALE)中取得 29.6 分。前者考察电脑操作与跨应用任务执行能力,后者聚焦具有实际经济价值的电脑操作场景。按照官方公布的对比结果,两项成绩均位列国产模型第一,其中 OSWorld 2.0 成绩高于
网络安全方面,评测表显示,M3.1 Flash 在 CyberGym 中取得 82.2 分,高于
为了提高推理效率,
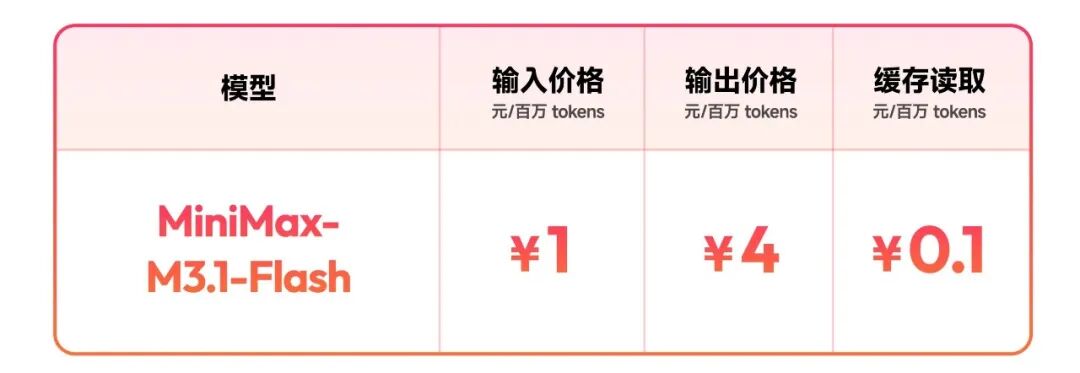
价格方面,M3.1 Flash 的输入价格为每百万 Token 1 元,输出价格为每百万 Token 4 元,缓存读取价格为每百万 Token 0.1 元。官方称,在 Agent 类任务中,模型的综合使用成本较前代降低了 70%。
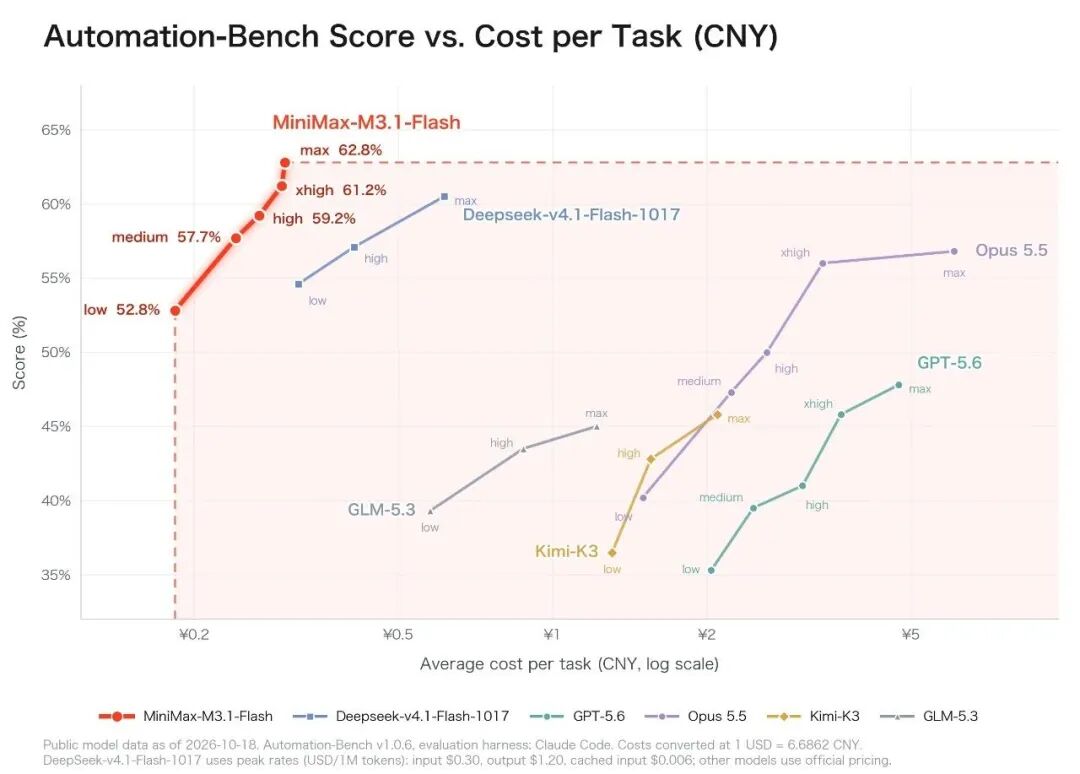
具体到实际任务,
在 Automation-Bench 中,随着推理档位从 low 提升至 max,M3.1 Flash 的成绩从 52.8% 提高至 62.8%。
按图中位置估算,平均每项任务成本约为 0.18 元至 0.30 元,在图示各档位下均低于
在 DeepSWE 中,M3.1 Flash 的 high、xhigh 和 max 档位成绩分别为 68.1%、72.1% 和 73.7%,对应的平均任务成本均在 2 元以内。
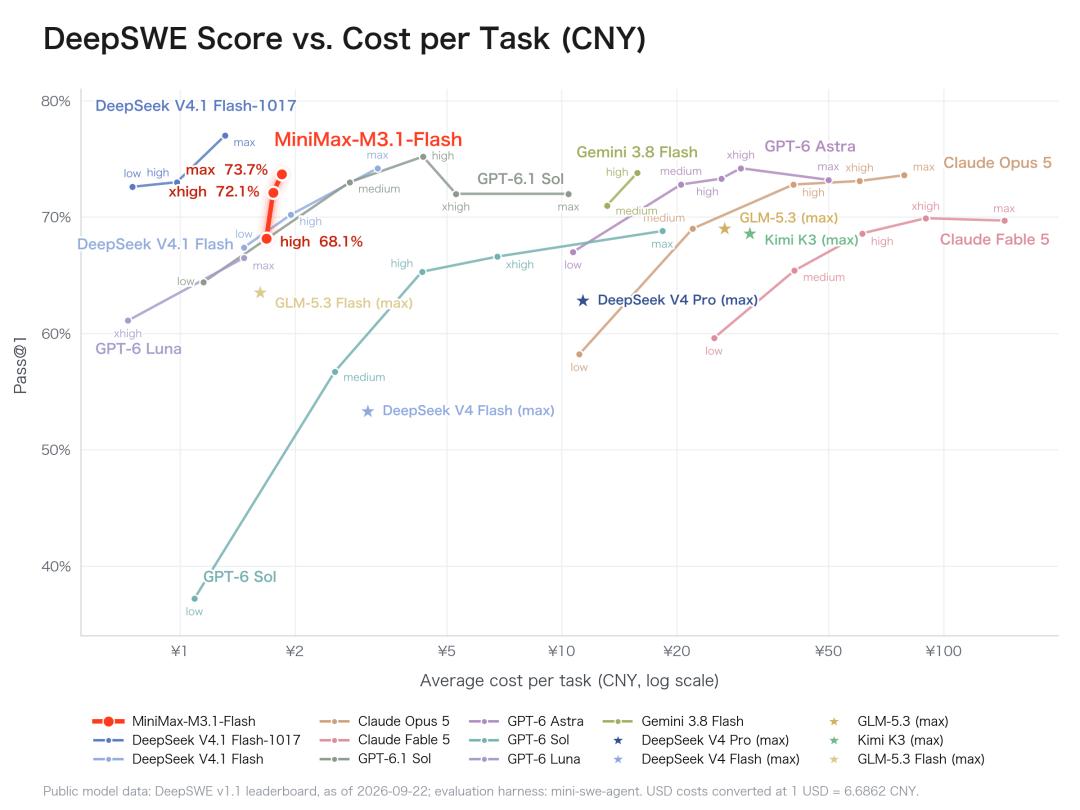
相比之下,图中 Claude Opus 5 达到约 74% 成绩时,平均每项任务成本已达数十元。不过,
ALE 对比图则展示了完成整套评测的预计总费用。在包含 152 个任务的 Overall 评测中,M3.1 Flash 以约 739 元的预计总成本取得 29.6% 的通过率,是图中费用最低的模型。
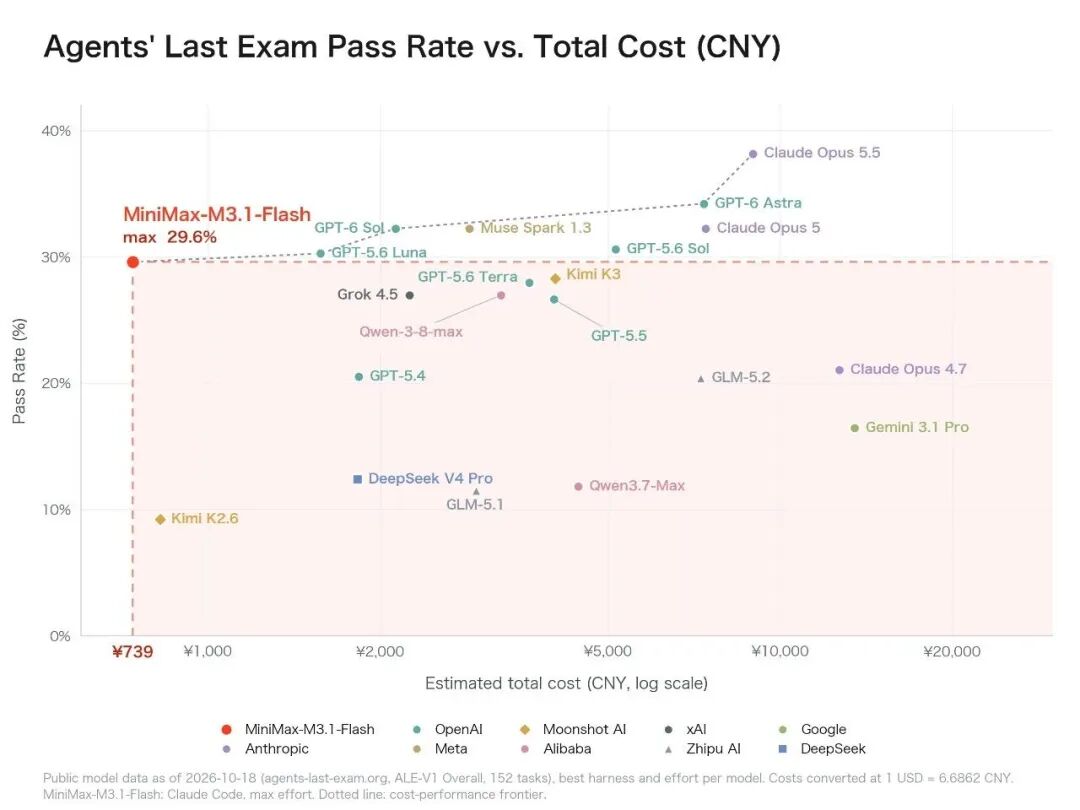
作为对照,GPT-5.6 Sol 的通过率约为 30.6%,预计总成本约为 5000 元;Claude Opus 5.5 的通过率约为 38%,预计总成本接近 9000 元。各模型采用各自表现最佳的运行框架与推理配置。
综合这些结果,M3.1 Flash 的卡位非常清晰:用极致的成本控制,撑起高频、高强度的 Agent 规模化调用。毕竟在海量调用的真实业务里,单次省下的几块钱,乘以规模就是真金白银的护城河。
目前,M3.1 Flash 已上线
值得一提的是,APPSO 登录 Minimax Code 官网时发现,配合此次更新,
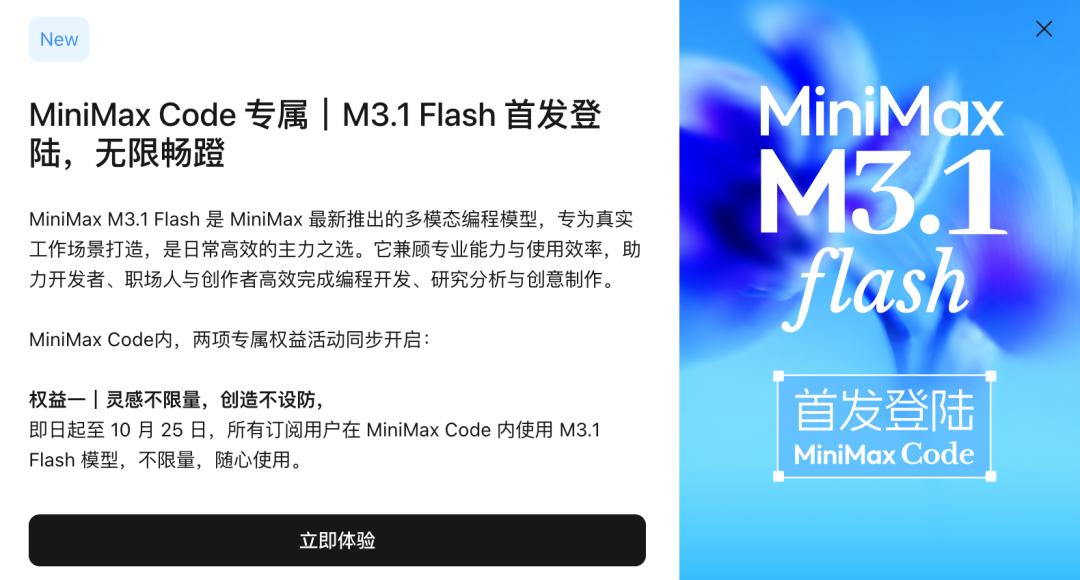
即日起至 10 月 25 日,所有订阅用户均可在
即日起至 10 月 31 日,新订阅或升级 M Plan 的用户可享首月五折优惠,次月起按原价续订。
此外
本文来自微信公众号“APPSO”,作者:发现明日产品的APPSO,36氪经授权发布。
















