不到72小时,DeepSeek和MiniMax双双交卷,Flash集体挑战旗舰
曾几何时,大模型最重要的竞争是争夺能力上限,但进入下半年,一些风向变了,行业更关注谁能以更低的成本,把模型能力变成开发者和企业真正用得起的生产力。
10月17日,
两款模型的接连出现,让国产大模型的Flash赛道有了新的看点。
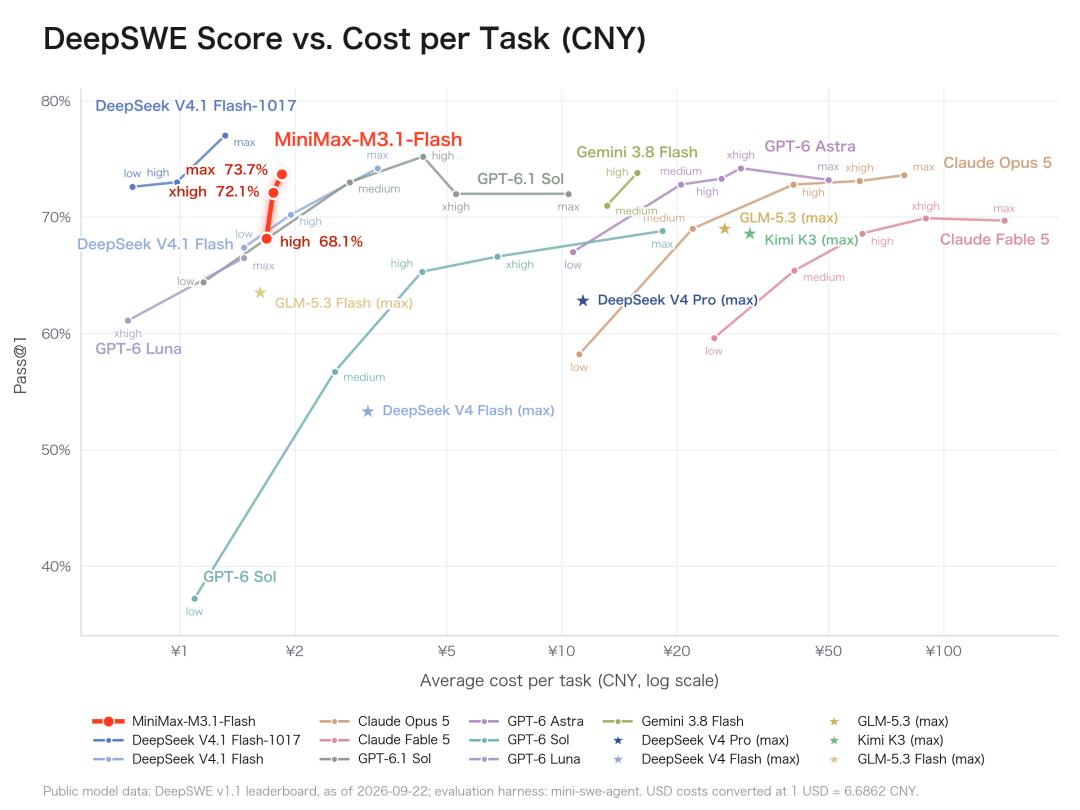
在最新评测数据中,M3.1 Flash在DeepSWE测试中获得74分,仅次于
价格和能力同时向前推进,是这次更新值得关注的地方。
过去,Flash通常意味着一种取舍,牺牲部分能力,换取更快的响应和更低的成本。但
01
Flash段位又来了一位新强手
今晚,
据
此外,M3.1 Flash 在衡量 AI 电脑操作与跨应用任务执行能力的 OSWorld V2 中取得 61.7 分,在评估真实专业工作场景与复杂任务完成能力的 Agents' Last Exam(ALE) 中取得 29.6 分,均位列国产模型第一。
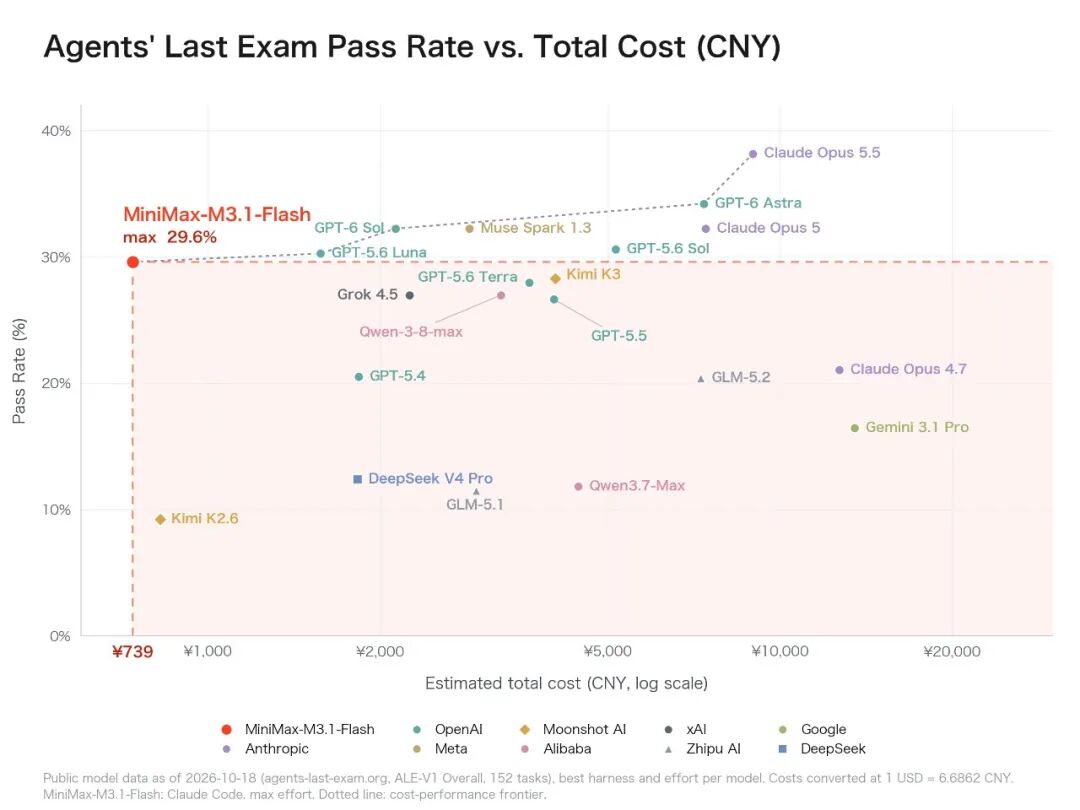
更值得注意的是完成这些任务的成本。M3.1 Flash的通过率高于其他旗舰国产模型,而整套评测运行成本更低。这意味着,Flash模型不仅开始挑战旗舰模型的能力,也在尝试以更低成本完成复杂的专业任务。
在 DeepSWE v1.1 评测中,M3.1 Flash 取得 73.7%的成绩,也明显高于多款旗舰模型。这进一步说明,在特定编程任务评测中,Flash与旗舰模型之间的能力差距,已经不再是不可逾越的鸿沟。
网络安全和复杂Agent任务,则是M3.1 Flash试图进一步打开的空间。
在CyberGym基准测试中,该模型获得82%的高分,与GPT-5.6 Sol的83.6分处于相近区间。CyberGym覆盖188个真实软件项目中的1507个历史漏洞,主要考察模型分析软件漏洞的能力。
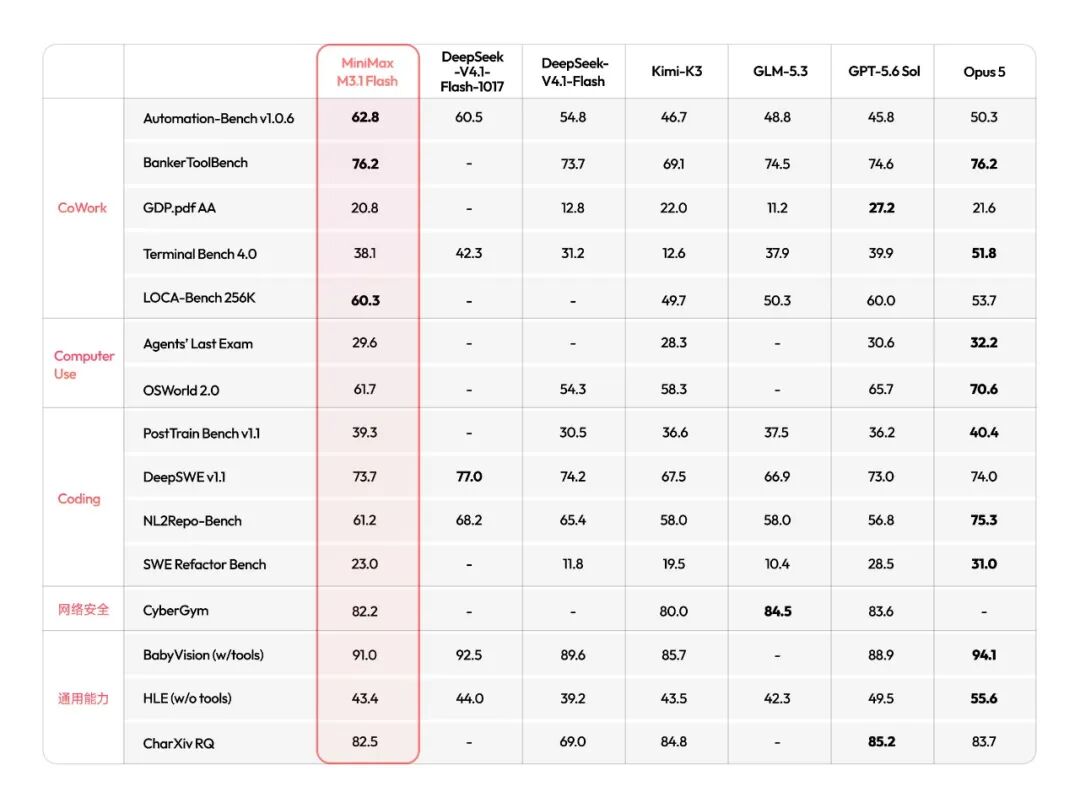
在Automation-Bench v1.0.6中,M3.1 Flash取得62.2分;在BankerToolBench中,它获得76.2分,与Claude Opus 5并列第一。后者聚焦金融场景中的多步骤规划、跨文档一致性、业务合规和复杂工具调用。
这意味着,在编程、金融工具调用和部分企业自动化任务中,轻量化模型也开始具备参与高复杂度工作的能力。
此前,Space Bunny以匿名模型的身份在开发者社区引发关注。它的身份一度引来外界猜测,除了性能,速度也曾是当时众多开发者反馈中最集中的特征之一。随着
因为使用了更激进的稀疏结构,M3.1 Flash在日常使用场景下的输出速度可达 200+ TPS ,中位数(P50)稳定达到 170+ TPS,即每秒生成170个Token。
对普通用户来说,模型响应快一些,意味着等待时间更短。但对开发者而言,速度的意义远不止于交互体验。
当模型开始承担代码编写、自动化办公、数据处理等连续任务时,响应速度会直接影响工作流的整体效率。尤其在Agent场景中,模型需要反复理解任务、调用工具、读取结果,再决定下一步行动。一次调用节省下来的时间,可能在多轮执行中不断累积。
02
Flash双子星,性价比双双拉满
10月17日,
比如,两家厂商均处在相近价格带,直接把性价比拉满。
M3.1 Flash每百万 tokens 的输入费用为 1 元、输出费用为 4 元,缓存读取费用为 0.1 元。与 M3(输入 ≤ 512K tokens)对应价格相比,输入和输出单价均降低 50%以上,缓存读取单价降低超 70%。其定价相当于
不过,另外需要注意的是,
但二者共同掀起的趋势已经相当清晰。
当模型能力接近,价格差异就会改变开发者的选择;当价格进一步下降,过去因为成本太高而无法大规模部署的应用,也可能重新获得商业化机会。
对企业来说,真正重要的不是某个模型在排行榜上高出几分,而是完成同一项任务需要花多少钱、耗费多少时间,以及失败后是否需要反复调用模型。
因此,
而在
他们核心指向也一致,让AI做好一件事,可以有更便宜、更好用的方式。
03
MiniMax,杀回来了
对
在过去一段时间里,
此前的M3并未完全打消外界对
从评测数据看,新模型相较M3有明显提升,同时延续了较快的输出速度。它在编程、网络安全和复杂Agent任务中的表现,也让
对
至于
这场竞争的背景,是大模型行业正在从能力展示走向效率竞争。
当模型的能力足以承担越来越多真实任务,企业关心的就不再只是参数规模和榜单排名,而是完成任务的综合成本。更便宜的Token、更快的响应,以及更少的无效调用,最终都要转化为可衡量的业务收益。
国产大模型的下一轮较量,或许不再是谁能把价格压到最低,而是谁能在价格已经足够低的情况下,仍然把复杂的事情做好。
这才是
本文来自微信公众号“凤凰网科技”,作者:Dale,编辑:董雨晴,36氪经授权发布。
















