字节Seed实习生曝DeepSeek-V4技术缺陷:长文本检索陷入“周期性盲区”
最近,字节跳动 Seed 团队在测试
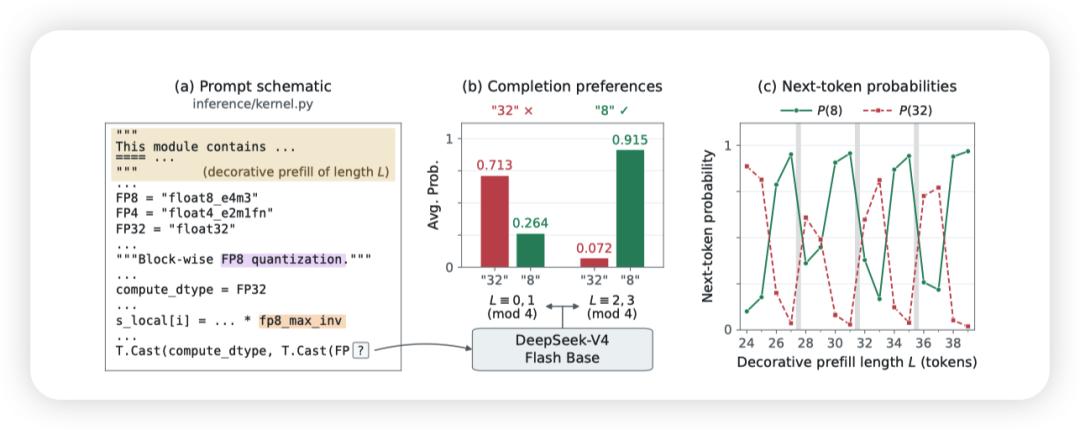
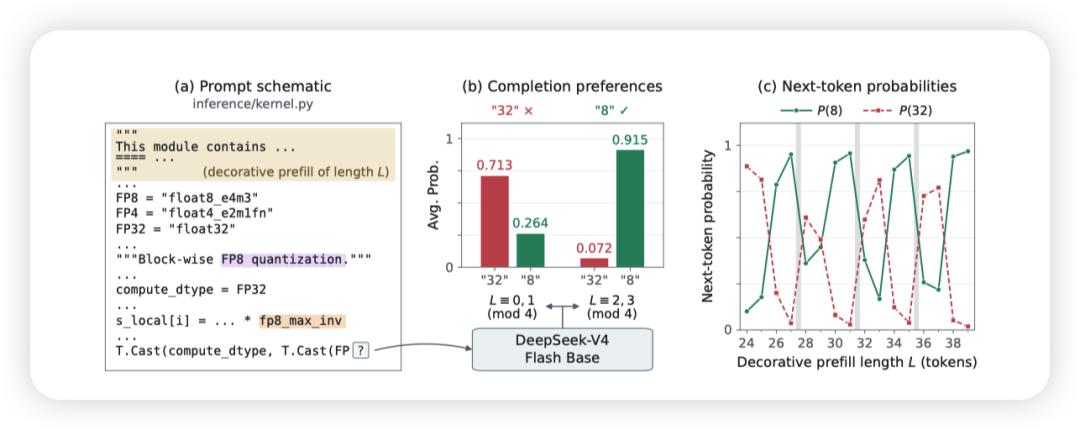
更奇怪的是,研究人员并没有修改任何关键代码,研究人员没有改动任何一行核心代码,仅仅在前面一段无关紧要的注释里,逐个增加装饰性的 = 符号,模型的答案竟然就在 8 和 32 之间来回翻转,而且每隔4个 Token 就重复一轮。
多敲一个符号就能让模型颠覆判断,这显然不是随机误差。
顺着这条异常线索,字节跳动 Seed 团队联合普林斯顿大学、斯坦福大学及加州大学伯克利分校的研究人员,对
在128K长上下文检索实验中,仅仅因为目标信息所处的 Token 位置不同,
所幸的是,
Seed 团队将这一现象称为“相位敏感性”(Phase Sensitivity),可被视为长文本压缩机制下难以回避的周期性软肋。
更让业界瞩目的,是掀开这一“隐蔽缺陷”的一作背景。
排在论文核心贡献者首位的,是字节 Seed 实习生、普林斯顿大学计算机系博士生朱星宇(Xingyu Zhu)。这位本科毕业于杜克大学、师从机器学习理论大家 Sanjeev Arora 的年轻研究员,此前已有成果入选 ICML 2025 Spotlight,今年还刚刚斩获了 ICLR 2026 RSI Workshop 的最佳论文。
从研究“上下文错误如何干扰推理”,到这次揪出“位置滑动如何瘫痪检索”,他切入大模型隐蔽缺陷的视角一脉相承,展现出了极其刁钻的敏锐度。
此外,该论文的结构也颇为特别:整整 65 页的篇幅,正文内容压缩在 10 页,参考文献占3页,剩下的 52 页全是附录。从数十种模型变体的因果干预、注意力头消融,到严格的数学动力学证明,研究团队几乎是把一整套“白盒解剖”的证据都摊在了台面上。
与其说这是一篇模型评测论文,不如说字节 Seed 团队围绕
而问题的源头,恰恰直指
问题的源头:神鬼二象性
要理解这个 Bug 怎么来的,首先得看
在传统的标准 Transformer 里,随着输入文本拉长到 128K 乃至百万级别,KV Cache(键值缓存)对显存的吞吐和占用会呈线性暴增。为了把显存和算力成本压到极致,
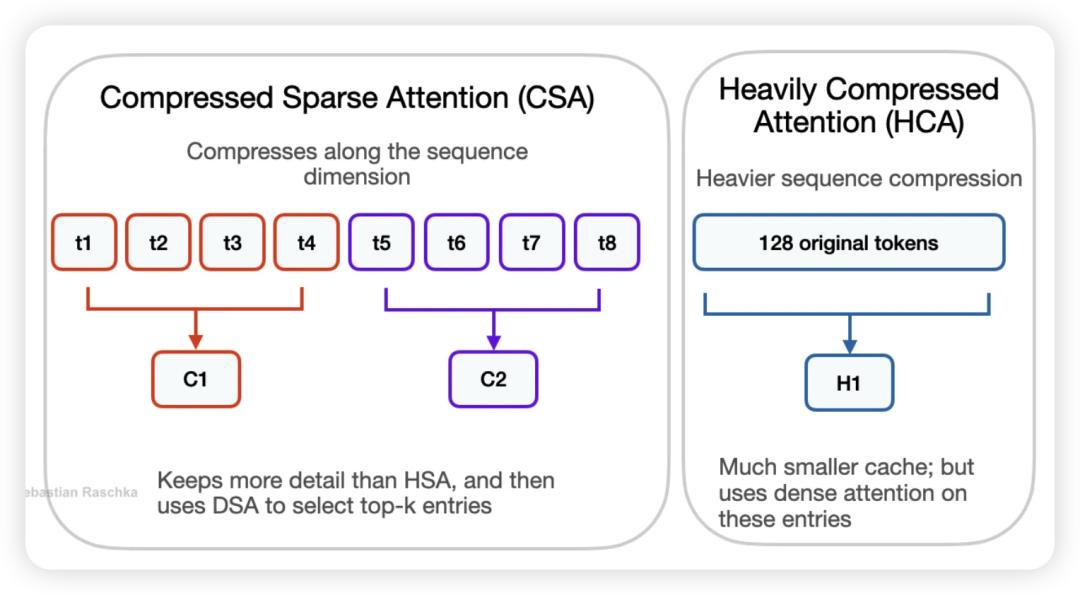
- CSA(压缩稀疏注意力):采用长度为 8、步长为 4 的重叠滑动窗口,直接把 KV 数据量砍掉四分之三,后续再通过 Indexer 挑选关键块做稀疏计算;
- HCA(历史压缩注意力):压缩幅度更大,每 128 个 Token 强行合并成一条(无重叠),全局读取不挑。
这套设计在工程落地上的收益极大,是
在原生 Transformer 中,RoPE(旋转位置编码)的点积只计算相对距离。你在句子开头说句“你好”、换个harness框架、或者多打一个空格,Token 之间的相对坐标完全不变,模型注意力分布稳如泰山。
但由于
所谓相位,就是这个 Token 的绝对位置除以步长 4 取模的余数。在全注意力模型里,一个词排在第几位对编码方式毫无影响。但在分块压缩机制下,模型对不同位置的信息并非一视同仁:
有些位置的信息能被较完整地保留下来,有些则却可能在压缩过程中被大幅削弱。因此,同一条信息只是前后移动一两个 Token,模型后续能否准确找回它,结果就可能截然不同。
最核心的技术本质在于:信息在物理层面压根就没有写入 KV Cache。
等模型生成到后面回头检索时,显存的缓存池里根本不存在这段记忆。此时上层模型就算涌现出的逻辑推理能力再强,面对已经被物理抹平的底层表征也是巧妇难为无米之炊,只能基于自回归局部的统计概率胡乱拼凑——在用户端看来,就是模型突然“抽风”和胡言乱语。
对齐了就超神,踩进盲区就超鬼,网友常拿“神鬼二象性”调侃
字节 Seed 的解剖实验
V4 的步长为 4,因此相位也有 4 种。信息在某种相位容易被找回,换个相位却可能沦为模型的检索死角。
开篇提到的 FP8 代码补全实验,正是第一条线索。研究人员只改变前置文档字符串的长度,模型就会在正确的 8 和错误的 32 之间周期性切换。更换四组填充文本后,64次比较中有60次符合这一周期规律。
而没有采用分块 KV 压缩的 V3.1-Base,则没有出现类似的周期性翻转。
为了排除偶然性,Seed 又设计了一项128K长上下文的“大海捞针”实验。
他们在文本中埋入1.6万组 Key-Value 记录,让模型根据指定 Key 找出对应的 Value。随后通过调整填充长度,将目标 Key 按 Token 位置对8取余划分为8组,同时固定总长度、提问位置,并匹配目标绝对位置的均值和方差,尽量排除检索距离带来的干扰。
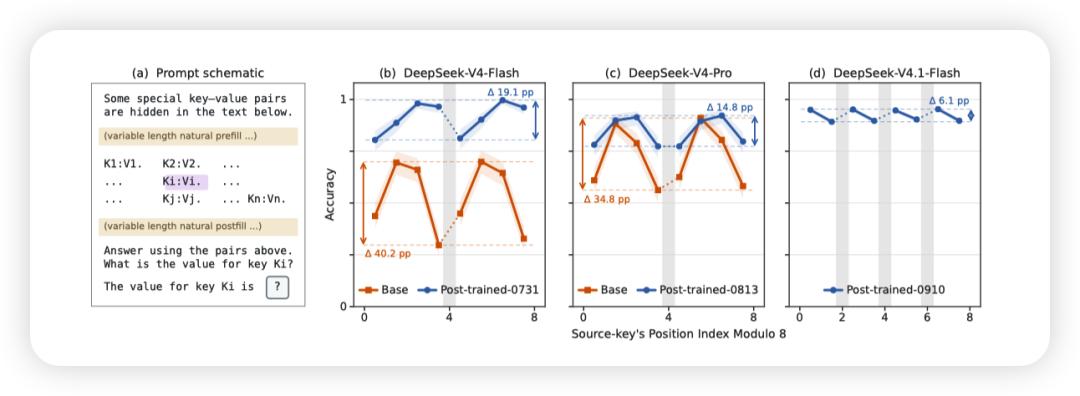
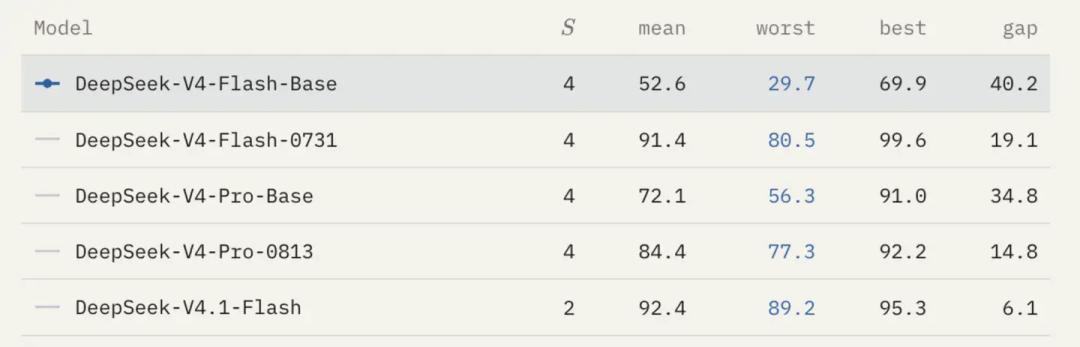
结果,
更关键的是,V4 各版本相隔4个 Token 的位置组,准确率又会呈现相似表现,几乎与 CSA 的压缩步长完全吻合。这意味着,模型并非单纯“忘记”某条信息,而是某些位置的信息从压缩存储到后续读取,更容易受到损失。
可是,为什么此前的长文本榜单(如 NIAH 或 RULER)从来没测出这个问题?
根源在于,主流评测一直被“综合平均分”蒙在鼓里。传统测试习惯把目标信息随机散落在文本各处,在均匀采样下,强势槽位的满分和弱势槽位的零蛋恰好互相抵消,最终伪造出一个光鲜平稳的高分假象。
而 Seed 基于Qwen3-0.6B 架构从零训练的模型对照实验恰好证明了这一点:
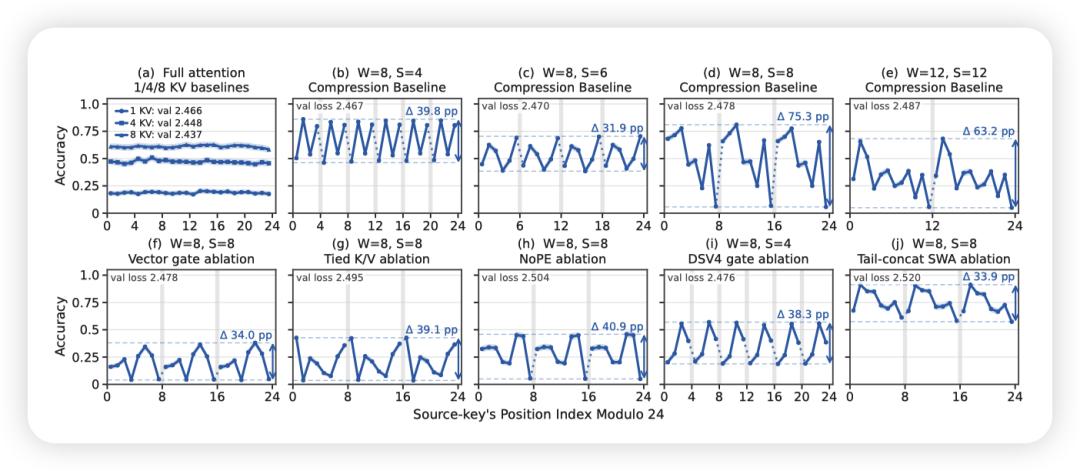
- 看平均准确率:全注意力是 61.1%,8 倍压缩注意力是 59.4%,两者仅差 1.7 个百分点,几乎平起平坐;
- 看最差表现:全注意力最差位置仍有 58.4%(极值仅差 4.3 个百分点);而压缩模型的最差位置直接断崖式跌到 9.9%,最好与最差的落差暴增至 71.1 个百分点。
平均分几乎没有区别,最差表现却相差了近 50 个百分点。这也撕开了传统评测最大的盲区:平均分只能证明模型“总体上行不行”,却完全隐瞒了它会在什么固定位置“突然瘫痪”。
DeepSeek对V4.1进行了哪些修复
值得注意的是,
从架构变化与实验结果来看,
- 压缩步长减半(CSA2):将压缩步长直接从 4 降到 2,窗口缩短;
- 结合 Engram 模块:引入条件记忆结构分担注意力计算的负担,提升长程调度能力。
从评测结果来看,V4.1-Flash 的改进立竿见影:最好与最差相位的落差从 40% 大幅收窄到了 6.1 个百分点,性能起伏被抚平了大半。
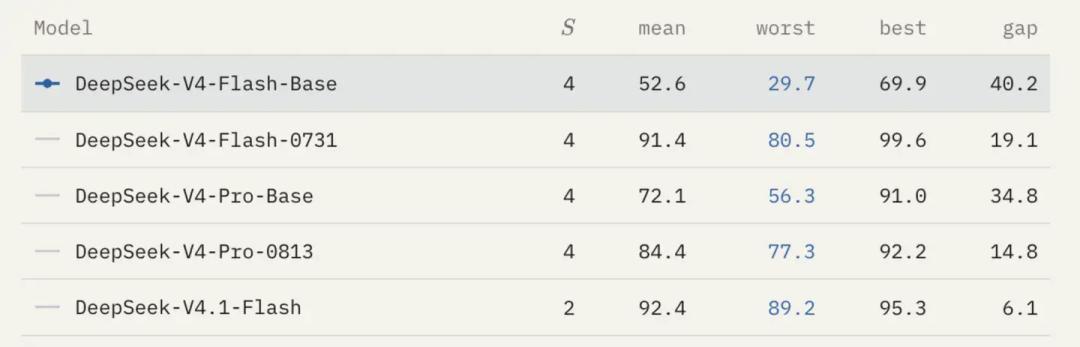
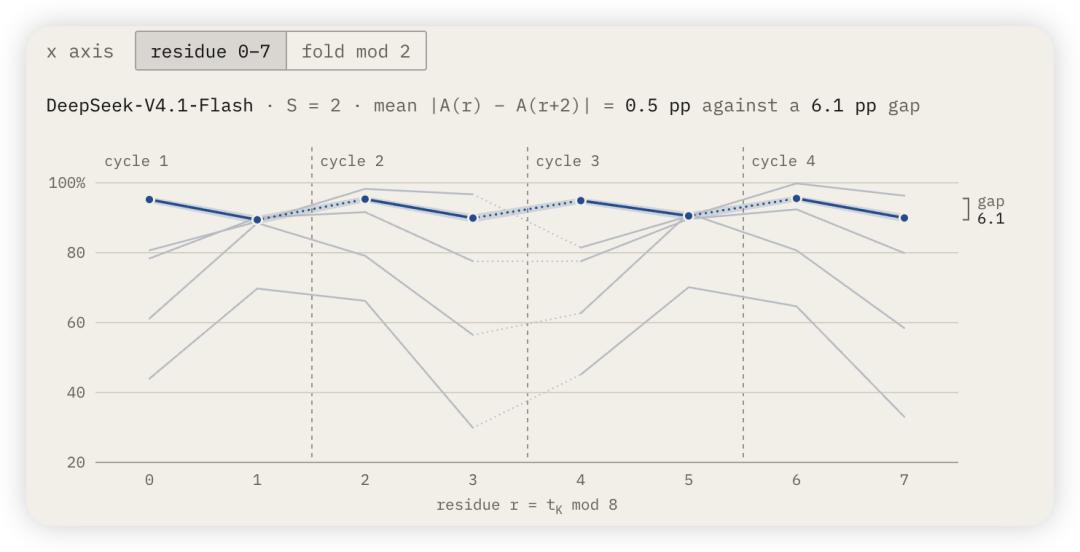
但机制层面的周期性并没有消失,而是机械地退化成了以 2 为周期:
目标处于偶数位置时准确率稳定在 95% 左右,处于奇数位置时则在 89%~90%。步长是多少,周期就是多少。
这直接印证了:步长减半可以缓解阵痛,但只要依然是固定步长的分块压缩,相位敏感性的本质就没有被彻底消除。
同行揭短,也是开源的价值
这次,
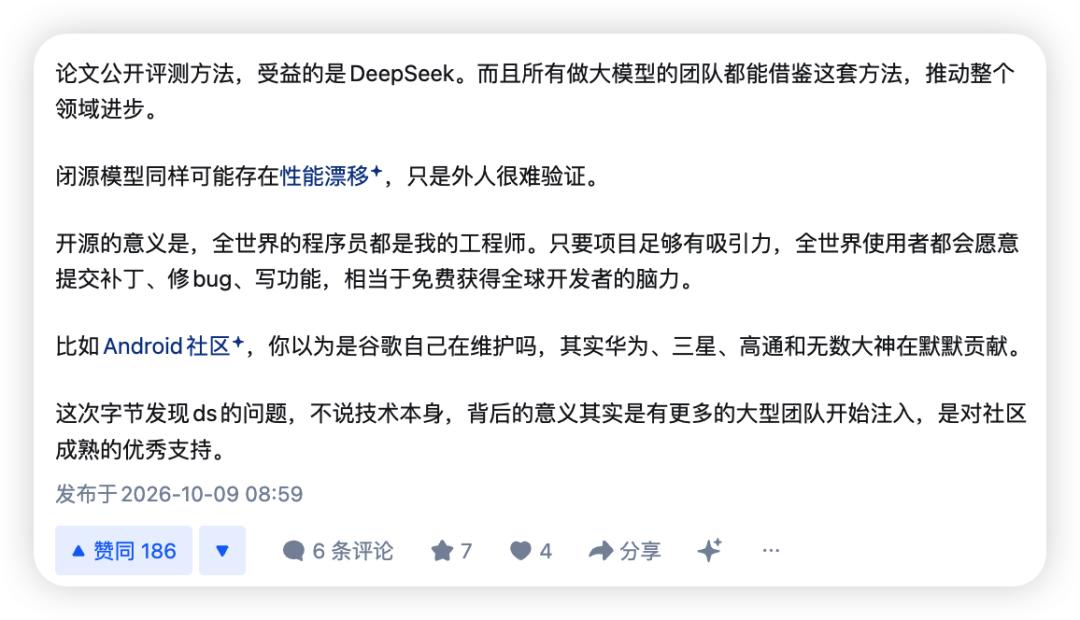
就像评论区有人感叹的:“全世界的程序员都是我的工程师。”敢把底牌完全亮出来的项目,自然引来全行业的顶尖大脑帮它排查盲区。这时,即便是竞争对手,也能成为极具价值的“审查员”。
而评论区引发最多工程师共鸣的,还是系统工程与算法团队之间的无限拉扯。
“CSA 这种策略本身就有很高的 Infra 话语权,压缩比越大 Infra 越爽,至于到底让模型忘掉了啥,只能训完才知道。”在当下大模型研发体系里,底层系统早已深度介入了模型结构的设计,“以后 Infra 哥确实没法甩锅说不对训练结果负责了”。
省下算力,也可能损失信息保真度。 系统团队不能只汇报吞吐,算法团队也不能只看平均跑分。到最后,我们可能发现,硬件吞吐的每一次妥协,都有算法的表达在默默买单。
本文来自微信公众号 “AI前线”(ID:ai-front),作者:四月,36氪经授权发布。
















