AI学对接空间站,斯坦福让世界模型学习飞船对接,陌生对接口仿真成功率超基线两倍
自斯坦福大学的研究团队提出了一种将世界模型应用于航天器交会与近距离操作的方法,开源了一个基于 JAX 构建的国际空间站(ISS)对接仿真环境,并提出了 一种基于 Transformer 的世界模型 Out-of-this-World-Model。研究人员将该方法应用于胶囊飞船自主对接国际空间站的任务,结果表明,与强化学习基线方法相比,该方法在不同对接口上的总体对接成功率达到 53%,而基线方法为 29%;在训练过程中未使用的对接口上,其分布外泛化能力也显著更强,世界模型的成功率达到 40%,超过基线方法的 17%,即成功率超过后者两倍。
时至今日,交会与对接仍是载人航天探索不可或缺的能力,所有前往国际空间站(ISS)的载人飞船和货运飞船都需要执行这一操作。尽管相关任务的执行频率不断提高,航天器交会仍然是一项复杂且高风险的操作。两艘相距数公里的航天器必须逐渐接近,最终以厘米级精度实现物理接触,而任何碰撞都可能对两艘航天器造成永久性损伤。接近过程中发生碰撞不仅意味着任务失败,还可能产生大量空间碎片,使轨道空间中的其他卫星面临风险。因此,要实现安全的自主交会,就需要一种能够在控制动作执行之前推理其潜在后果,并且能够尽早识别非正常情况的方法。
近年来,世界模型(World Models)成为表征学习领域一种正在兴起的范式。在这一范式中,智能体利用离线轨迹数据,同时学习状态—动作动力学与观测模型,从而能够进行多步规划和轨迹预测,并给出相应的不确定性估计。此前,世界模型已经在机器人和游戏环境中取得了较好的效果,但尚未应用于航天领域。在此背景下,来自斯坦福大学的研究团队提出了一种将世界模型应用于航天器交会与近距离操作的方法。
具体而言,该研究团队开源了一个基于 JAX 构建的国际空间站(ISS)对接仿真环境,并提出了 一种基于 Transformer 的世界模型 Out-of-this-World-Model。研究人员将该方法应用于胶囊飞船自主对接国际空间站的任务,结果表明,与强化学习基线方法相比,该方法在样本效率和任务性能方面均有所提升:在不同对接口上的总体对接成功率达到 53%,而基线方法为 29%;在训练过程中未使用的对接口上,其分布外泛化能力也显著更强,世界模型的成功率达到 40%,超过基线方法的 17%,即成功率超过后者两倍。
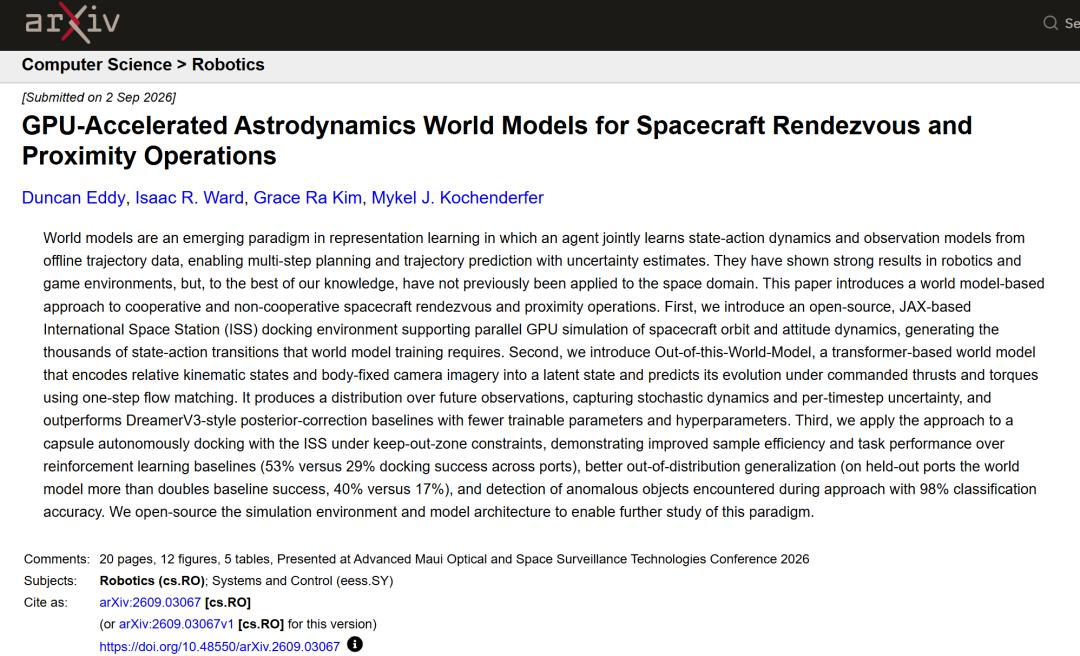
相关研究成果以「GPU-Accelerated Astrodynamics World Models for Spacecraft Rendezvous and Proximity Operations」为题,已发布预印本于 arXiv。
研究亮点:
* 本研究开源的仿真环境支持基于 GPU 的航天器轨道与姿态动力学并行仿真
* Out-of-this-World-Model 与基线模型相比,使用更少的可训练参数和超参数,却实现了更优的预测性能
* 在对接接近过程中,该模型还能够检测所遇到的异常物体,分类准确率达到 98%
论文地址:https://hyper.ai/papers/2609.03067
使用开源的 ISS 对接仿真环境生成训练数据
世界模型通常需要数十万至数百万个状态—动作转移样本才能完成有效训练,因此,仿真吞吐量至关重要。研究人员使用开源的 ISS 对接仿真环境 outofthisworldmodel-envs 生成训练数据。该环境的动力学、传感、奖励以及回合逻辑全部采用 JAX 编写,因此环境可以在 CPU 或 GPU 上并行执行,并能够将完整的轨迹滚动预测(rollout)编译为单个融合程序。
AstroJAX
论文首先开发了开源天体动力学库 AstroJAX,该库将标准天体动力学模型表示为纯函数形式、且可微的 JAX 函数。下表汇总了目前已经实现的模型:
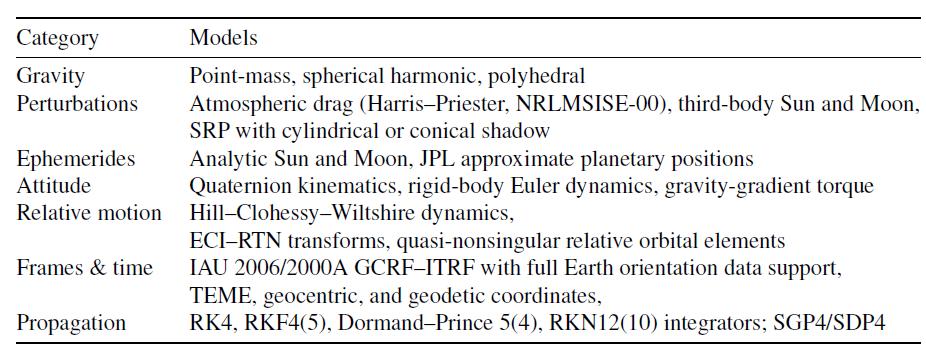
AstroJAX 中实现的模型
研究最终使用这一框架生成了约 50 万条状态—动作转移数据,作为世界模型的训练语料。论文同时开源了仿真环境、模型架构和数据集,为后续研究提供基础。
ISS 对接环境
该环境套件模拟一艘 Dragon 级追踪航天器(chaser) 在国际空间站附近执行机动的过程。空间站与追踪航天器分别进行轨道和姿态动力学传播,模型考虑了包括地球非球形引力项、太阳和月球第三体引力、大气阻力等因素在内的动力学效应;追踪航天器则采用刚体姿态动力学和四元数运动学进行建模。
在任务设计上,空间站设置了 8 个对接口,其中 5 个出现在训练数据中,另外 3 个被完全留出,用于检验模型能否泛化到训练过程中从未见过的目标。训练阶段主要包含三类行为轨迹:随机策略、轨道策略和对接策略。随机策略产生无目标的漂移轨迹;轨道策略让航天器围绕空间站进行不同半径和轨道平面的运动;对接策略则让航天器逐渐接近随机采样的目标对接口,其中碰撞空间站结构的轨迹同样被记录下来。
OWM 框架:采用因子化时空 Transformer
下图展示了 Out-of-this-World-Mode(OWM) 的整体架构——该设计采用模态参数化(modality-parameterized)方式:每一种输入数据流都会为每个时间步的 token 向量贡献固定数量的 token,而同一个骨干网络可以处理不同的数据流组合。
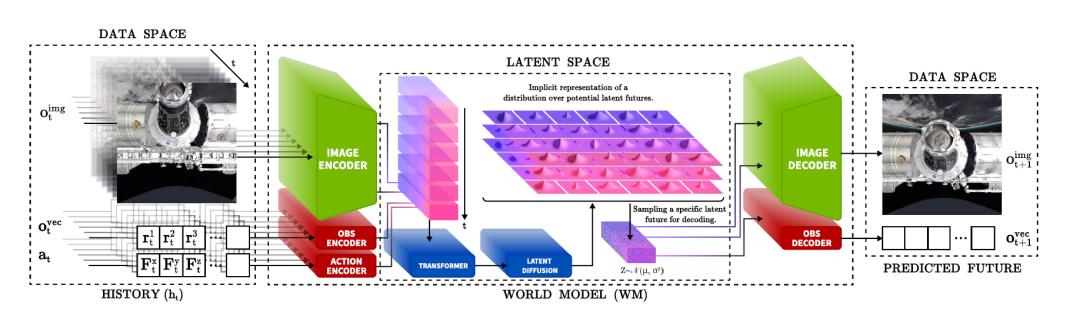
Out-of-this-World-Model(OWM)架构
对于运动学状态测量数据,模型使用一个轻量级多层感知器(MLP)进行投影;对于视觉数据,则使用一个视觉 Transformer(ViT)对每一帧相机图像进行编码。具体而言,视觉 Transformer 通过一个学习得到的注意力瓶颈,利用少量潜在查询(latent queries)对图像帧的 patch 嵌入进行交叉注意力计算,从而将整帧图像编码为多个图像 token。
在每个时间步,将状态 token 和图像 token 拼接起来,形成模型的潜在状态。与此同时,另一个多层感知器将动作映射为一个额外的 token,并将其作为条件信息添加到同一时间步的 token 向量中。随后,骨干网络通过空间注意力(spatial attention)将动作、状态和图像信息融合起来。
模型骨干采用一种因子化时空 Transformer(factorized space-time transformer),其设计思路源自视频模型架构。每一个 Transformer 模块首先执行空间注意力,即在单个时间步内的各个 token 之间进行双向注意力计算,使状态、动作和图像信息能够相互融合;随后执行时间注意力,在滑动窗口内沿时间维度进行因果注意力计算,并采用旋转位置嵌入。
模型在潜在空间中进行预测,并使用一个流匹配(flow matching)预测头,分别作用于向量中的每一个 token。给定当前时间步的骨干网络输出,该预测头学习一个速度场,将标准高斯噪声样本逐渐传输到下一时刻潜在状态与当前潜在状态之间的残差。
采样得到的潜在状态随后被添加到 token 历史中,模型继续向前滚动,即执行潜在空间自回归(latent-space autoregression),整个过程中无需将潜在状态解码回观测空间。只有在确实需要输出观测空间结果时,各个模态才会通过各自独立的解码头,将潜在状态重新映射为预测图像和状态。
世界模型的规划方法在样本效率和任务性能方面均有提升
研究人员将基于世界模型的规划方法与强化学习基线进行比较,同时从预测质量、对接性能、对未见过的对接口的泛化能力以及异常检测能力等方面进行评测。
训练与预测质量
实验首先比较了 OWM 与 Dreamer 风格后验校正世界模型的预测性能。下图展示了不同世界模型变体和强化学习基线的训练曲线,强化学习基线(图 b)的大部分学习进展发生在前 500 万步,此后性能提升逐渐放缓;合作式策略最终采用留出验证回合中表现最佳的检查点进行评估,该检查点对应 2250 万步。
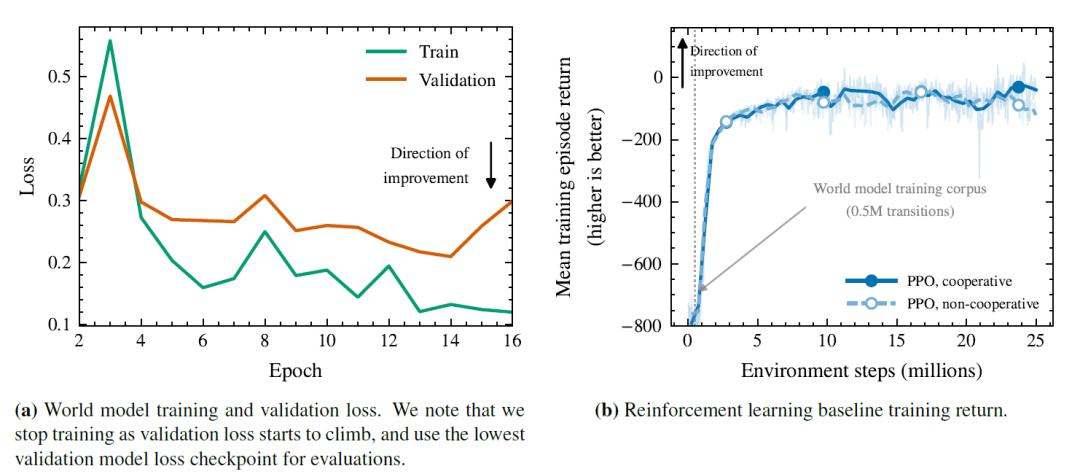
两种世界模型变体均在 16 个 epoch 内完成收敛。实验发现,与 Dreamer 风格的基线相比,研究提出的方法在状态预测和图像预测上的验证集误差均更低,同时所需的可训练参数更少。
对接性能
随后,研究将 OWM 与 MPPI 结合,用于实际的 ISS 自主对接规划,并与 PPO 强化学习基线进行比较。下图展示了合作式噪声条件下各对接口的对接成功率,其中既包括训练数据中的 5 个对接口,也包括 3 个留出对接口——Harmony 天顶向、Poisk 天顶向和 Unity 天底向,训练轨迹从未访问过这三个对接口。
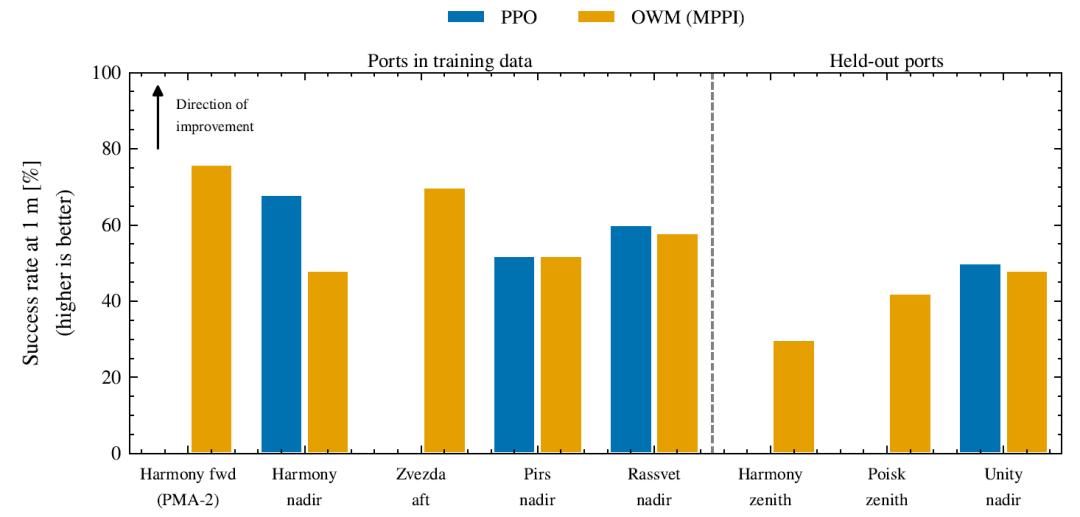
合作式传感器噪声条件下,不同对接口及算法的对接成功率,每个对接口进行 50 次滚动预测
实验结果呈现出两个明显特征:首先,在规划目标中仅提供对接口的目标位姿,且仅进行少量控制器调参的情况下,世界模型规划器在每一个对接口上的表现都与 PPO 相当,并且能够成功对接 4 个 PPO 策略始终无法完成对接的对接口。在训练数据中的 5 个对接口上,以 1m 位置容差衡量、并排除碰撞后的成功率,世界模型规划器达到 61%,而 PPO 为 36%。其中,世界模型规划器在 Harmony 前向对接口上的成功率为 76%,在 Zvezda 后向对接口上为 70%。这两个训练对接口是 RL 策略始终无法到达的目标——其接近过程通常在距离目标 10~12 m 时便停滞。
第二,也是更为关键的一点,留出对接口揭示了两种方法在分布外泛化能力上的明显差异。世界模型规划器只接收新的目标位姿,其余设置保持不变,但能够泛化到全部 3 个留出对接口:在 Unity 天底向、Poisk 天顶向和 Harmony 天顶向上的成功率分别为 48%、42% 和 30%。相比之下,尽管 PPO 基线加入了目标状态条件输入,但它仅能泛化到其中一个留出对接口,即 Unity 天底向(50%)。换言之,强化学习策略能够实现迁移的情况主要出现在:留出的对接口与其训练过程中已经见过的任务具有相似的几何特征;而世界模型即使从未见过这些对接口,也能够在接收到相应目标位姿后泛化到所有测试对接口。
异常检测
最后,研究人员评估世界模型的预测不确定性作为运行时异常监测信号的能力,下图展示了两个具有代表性的任务回合:
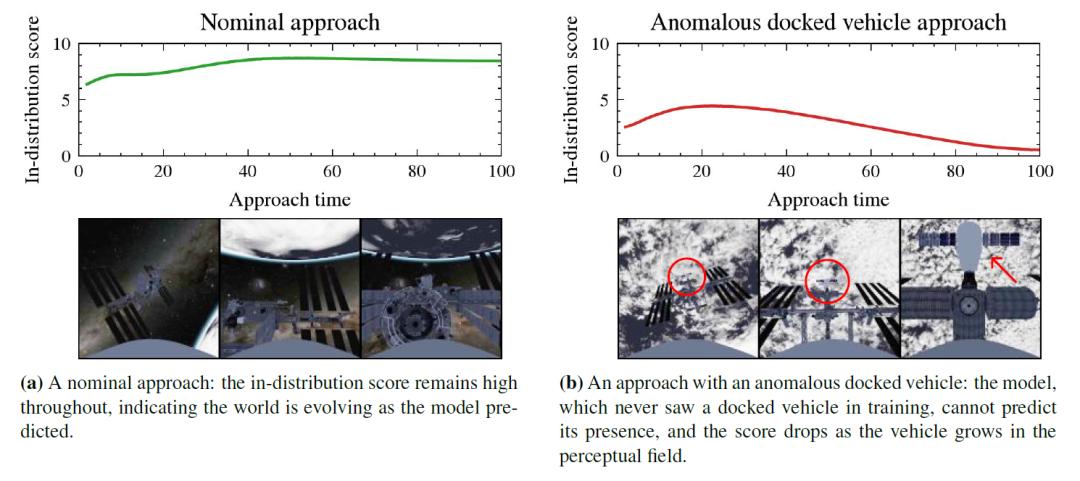
两个具有代表性的接近任务中,以分布内得分作为异常信号
下图则进一步汇总了整个异常检测数据集上的结果:
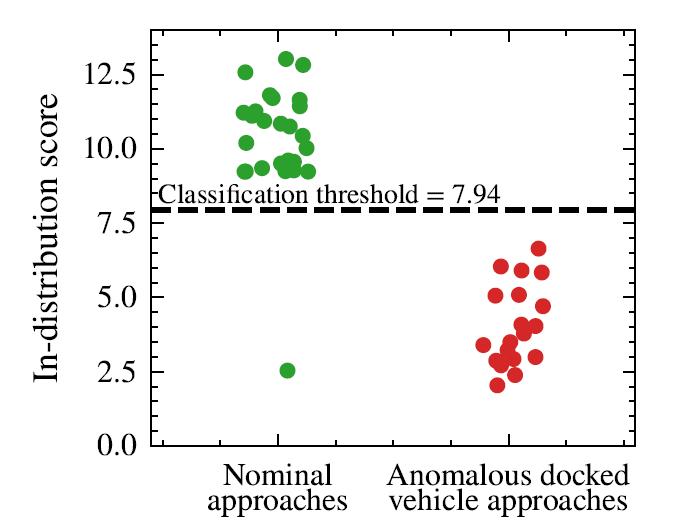
异常检测数据集中每次接近任务的最大分布内得分
由于训练过程中从未见过第二艘来访航天器,世界模型会根据其所学到的正常场景预测一个无异常的场景,而预测结果与实际观测之间的差异恰好集中在异常物体所在的位置。对于 25 个不包含异常航天器的接近序列,以及 20 个包含异常停泊 Dragon 航天器的接近序列,模型均能够正确完成分类,最终分类准确率达到 98%。
结语
如果说传统自主控制强调的是让航天器准确执行,那么世界模型带来的变化,则是让航天器在执行之前,先对动作可能产生的后果进行推演。此次研究虽然仍处于探索阶段,但已经展示出世界模型在交会对接、异常监测等任务中的潜力。未来,随着 MPPI 代价函数进一步优化,以及预测不确定性被更直接地用于碰撞规避,世界模型有望从「 预测未来」进一步走向「 辅助决策」。与此同时,将这一范式拓展至空间态势感知中的行为模式识别,并与安全感知规划技术结合,也有望进一步提升航天器的对接成功率。
本文来自微信公众号“HyperAI超神经”,作者:HyperAI,36氪经授权发布。
















