Meta支持的Biohub牵头打造AI制药数据基建,规模增至18亿美元
继个人AI助手Muse流行后,Meta(META.US)在生物科技领域的最新布局也引起了市场的关注。10月7日,Meta背景的生物科技机构Biohub正在扩大一项总规模约18亿美元的“虚拟生物学倡议”(Virtual Biology Initiative)。Biohub还宣布,美国能源部、美国国立卫生研究院、Google DeepMind、Isomorphic Labs和Meta将加入该倡议。NVIDIA提供计算基础设施。多家细胞和基因组研究机构将参与数据生产和标准制定。
18亿美元并不全是新增现金,其中,Biohub投入5亿美元;美国能源部(DOE)未来五年投入超过5亿美元;美国国立卫生研究院(NIH)将协调使用此前超过5亿美元联邦投资形成的数据和科研设施;Google DeepMind、Isomorphic Labs和Meta合计投入3亿美元。
Biohub由Meta创始人Mark Zuckerberg和他的妻子Priscilla Chan创立支持,是独立的非营利研究机构,并不属于Meta。不过,Meta既是投资方,也是Biohub部分AI技术和人才的来源。
01
Biohub:希望为虚拟细胞生产训练数据
Biohub的一项核心目标是建立“虚拟细胞”,这是一套从基因组、蛋白质、成像和细胞扰动数据中学习的AI系统,用于预测细胞在药物、基因编辑或环境变化下的反应。研究人员可以先在模型中测试药物、基因编辑或其他方案,再选择值得进入实验室的项目。
而此次扩大规模的“虚拟生物学倡议”想要做的,是解决AI生物科技的数据问题。现有生物数据分散在论文、实验记录和公共数据库中,格式和实验条件不同,失败结果又很少公开。
Biohub计划通过这项倡议建立统一标准、标识符和访问入口,并生产更多干预数据(干预数据,是记录细胞在药物、基因编辑或环境变化后的反应)。
正如「明亮公司」此前所提及的,这类模型目前受到数据限制。生物数据分散在论文、实验记录和公共数据库中。不同机构使用的样本、仪器和记录方式不同。公开数据又以成功结果为主。没有结合、合成失败等结果较少进入论文。
对AI发现新药来说,模型也需要失败数据。模型只有见过足够多的成功和失败结果,才可能预测新药物或新靶点的效果。而且,失败结果可以说明某种设计为什么无法表达,为什么发生非特异性结合,或者为什么只在特定细胞环境中有效。
在倡议中,Biohub将用4亿美元用于冷冻电子断层成像、活体显微技术和生物工程工具,另有1亿美元支持外部研究。合作的美国能源部提供超级计算、成像设施和自动化实验室,而NIH提供疾病数据和公共数据库。
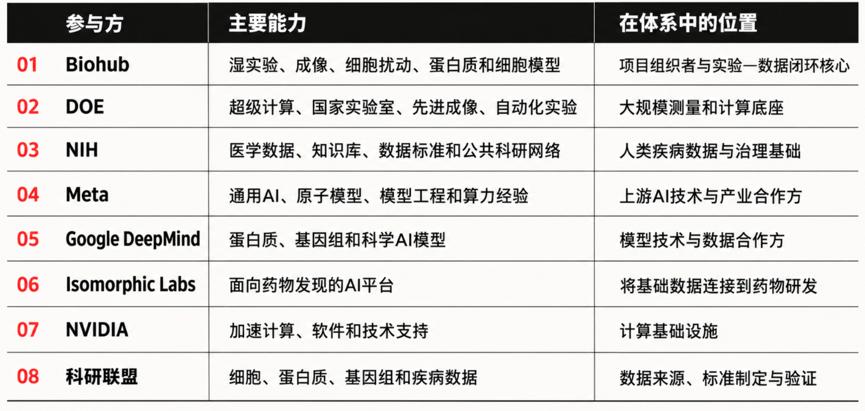
这一流程与AI制药公司建设湿实验室的逻辑相似:模型提出方案,实验室进行验证,结果再用于下一轮训练。区别在于,Biohub希望把数据和工具作为科研基础设施向外开放,而不是围绕一条自有药物管线使用。
02
Meta布局Biotech:从蛋白质模型延伸至细胞数据
Meta较早通过FAIR实验室进入计算生物学。FAIR开发了ESM蛋白质语言模型。ESM项目负责人Alex Rives后来创办EvolutionaryScale,该团队于2025年加入Biohub,Rives担任Biohub科学负责人。
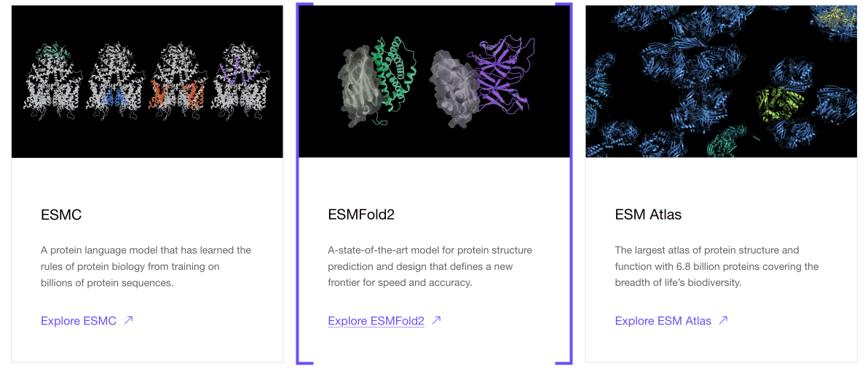
2026年5月,Biohub发布ESMC、ESMFold2和ESM Atlas。ESM Atlas覆盖68亿条蛋白质序列和11亿个预测结构。Biohub还使用ESMFold2为多个癌症及免疫靶点设计蛋白结合物,部分设计已完成实验室验证。
来源:Biohub官网
Meta自己则保留了原子和分子层面的研究。
2025年,Meta FAIR发布Open Molecules 2025和Universal Model for Atoms,用于预测分子和材料中的原子相互作用。此次参与Biohub计划后,Meta的公开布局已经覆盖蛋白质模型、原子模型和细胞数据基础设施。
不过,Meta目前没有公开的药物临床管线,其位置更接近模型、数据和算力供应方。Biohub负责实验和数据生产,下游药企及生物科技公司负责候选药物和临床开发。
「明亮公司」此前提及,OpenAI、Anthropic、Google和字节跳动也在向实验环节靠近。
OpenAI推出GPT-Rosalind,并投资Red Queen Bio、Chai Discovery和Valthos;Anthropic在湾区建立分子生物学实验室;Google从AlphaFold扩展至Isomorphic Labs;字节跳动分拆Anew Labs,并在融资后保留控股权。
几家公司的路径不同。Google通过Isomorphic Labs接近药物管线;OpenAI采用模型、合作和投资的方式;Anthropic直接建设湿实验能力;字节跳动保留AI制药资产;Meta与Biohub更偏向数据和基础模型。
以上动作传递出的信号是,AI制药的竞争正在从模型延伸至数据生产。模型可以扩大搜索范围,但无法替代实验。谁能持续获得格式统一、包含失败结果的数据,谁才更有机会提高模型对新靶点和新药物的预测能力。
Biohub仍需证明,虚拟细胞能否预测未见过的药物、患者和实验条件。从此次计划看,AI巨头对生物科技的投入,已经开始从单个模型转向数据、实验和计算基础设施。
本文来自微信公众号“明亮公司”(ID:suchbright),作者:主编24小时在线,36氪经授权发布。
















