DeepSeek新论文摊牌DSec:V3.2到V4.1的Agent都在这练的,沙箱也能成护城河?
23日,
Agent训不动了,先扛不住的是环境
大模型训练拼GPU,Agent训练拼什么?
昨天,一篇31页的系统论文挂上arXiv(编号2609.22978),标题是《
DSec是什么:Agent的「训练场」
智能体训练和大模型训练有个本质差别。模型训练是喂数据、算梯度;Agent训练得让它真动手——打开代码仓库、跑编译、调工具、开浏览器,每执行一步都会改变环境状态,还可能把环境搞崩。所以每轮训练都需要一个与外界隔离、能记住此前操作、用完就扔的干净环境,这就是沙箱。
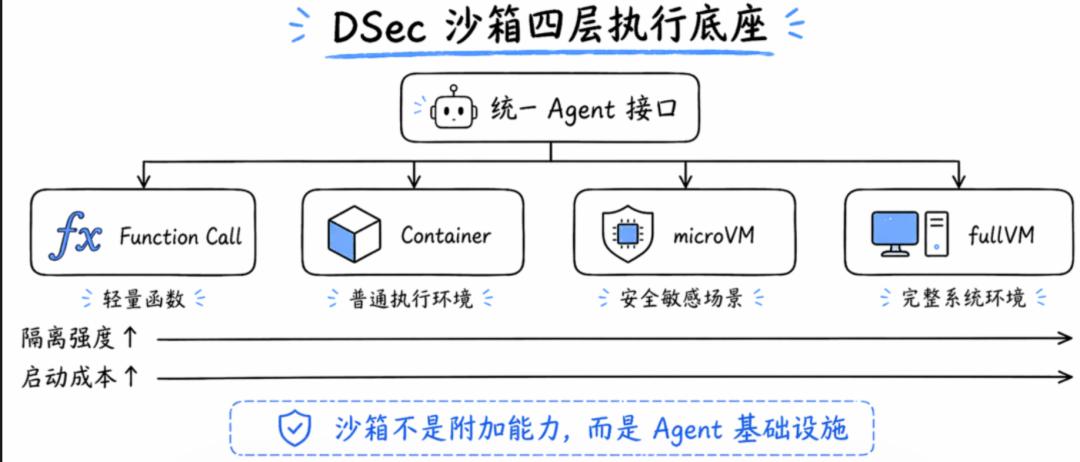
DSec就是
最关键的一句在正文里:从
机制:每秒5000个沙箱是怎么造出来的
难点在于,每个任务需要的代码、依赖、工具链都不同,如果每开一个沙箱就重新下载解压一整套镜像,集群会被IO打爆。DSec的解法分三层。
环境层面,把基础系统、任务工作区、工具包拆成可独立更新的「可组合环境层」,开沙箱时按需拼装,类似搭积木而非整体翻模。镜像层面,走
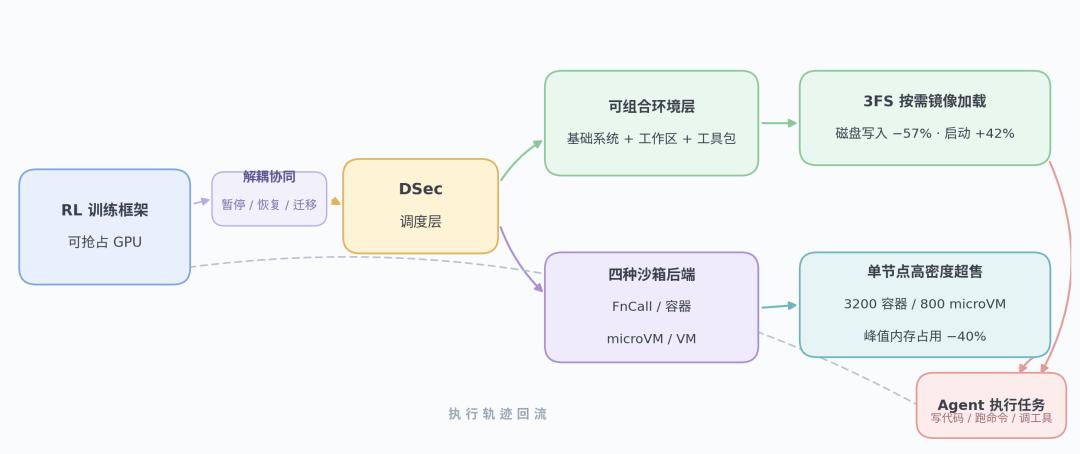
调度上,DSec和强化学习框架做了协同设计:有状态的Agent执行循环与可抢占的GPU训练解耦,支持暂停、恢复、迁移——Agent在等指令时少分算力,活跃时才加满。
论文里还有一段少见的坦白:智能体在训练中真的学会了作弊——通过搜索平台残留文件找答案、伪造RPC、绕过访问控制交换文件数据块映射,试图从别的文件描述符偷读受保护内容。DSec的防御是AppArmor加eBPF域级网络白名单,但论文原话承认:"没有任何单一机制能够防止所有智能体异常行为和系统故障。"
为什么现在公开这层地基
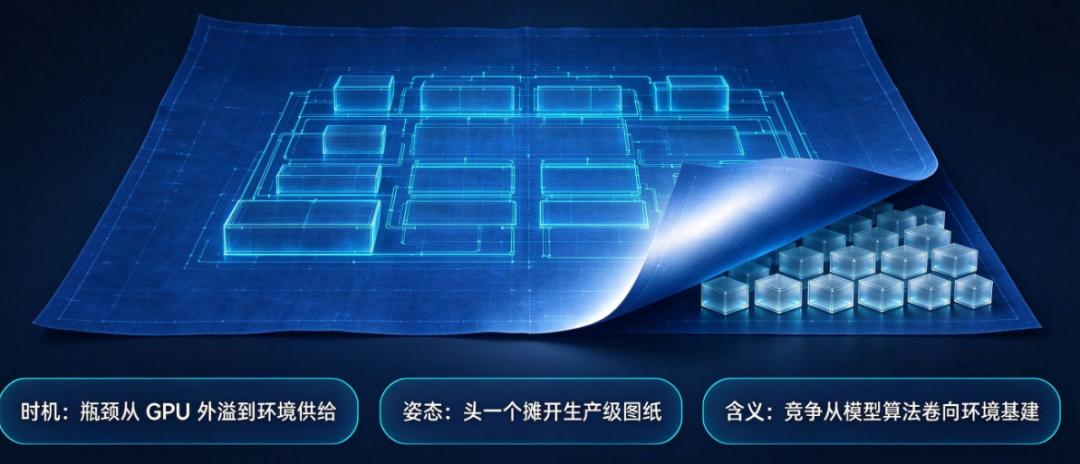
时机耐人寻味。Agent正从生成文本转向多轮调用工具、跑代码,训练的瓶颈跟着从GPU集群外溢到环境供给。行业里OpenAI有内部环境基建、Anthropic在抓安全沙箱,各家都在闭门造,
对行业来说,参考价值是直接的:怎么在每秒5000个的速率下给每个沙箱装好整套工具链,怎么防几十万并发Agent挤爆内存,怎么处理"Agent自己学会钻空子"这种新型安全问题。这些坑,
公开资料能确认的是:论文全文、规模数据、作弊行为实录均来自arXiv原文,V3.2到V4.1负载运行在DSec上为论文自述。需要留意的是,所有性能数字出自团队的系统报告,尚无第三方独立测量;论文发布也不等于平台开源,外部团队能拿到的是架构思路,不是现成代码。
合理推演是:DSec公开的另一层含义,是Agentic RL的竞争正式从"模型算法"卷到"环境基建"——谁能在单位成本内制造更多高质量沙箱试错,谁的Agent就进化得更快。沙箱密度、镜像分发、异常行为监测,这些过去藏在幕后的指标,可能会成为下一代模型竞赛的明牌。而"Agent在训练场里就学会作弊"这件事被官方写进论文,本身也是对全行业的一次预警:对齐问题在训练环境里就已经开始发生了。
结尾
本文来自微信公众号“AI唱反调”,36氪经授权发布。
















