AI短剧的导演部倒闭了,新offer在哪里?
过去两年,如果你问一家文生视频公司靠什么活,答案大概率是:帮人拍AI短剧。写剧本、出分镜、生成角色、对口型、剪片子——整套流程打包交付,本质上就是一个"AI导演部"。
抖音上那些几分钟一集的漫剧、品牌定制短剧、小红书上的悬疑互动剧,背后不少都是他们在撑。
但2026年,这个"导演部"突然不接单了。
不是没需求。抖音AI短剧的流量还在涨,品牌方还在投,平台还在给分账。是做导演部的那批人,自己不想干了——或者说,他们发现了一个更大的活儿:世界模型。
爱诗、生数、智象,这三家起家于文生视频的中国公司,最近几乎同时亮出了新牌。
方向不再是"帮你出一条片子",而是"帮你运行一个世界"。从生成画面到推演状态,从内容工具到决策工具,从卖生成次数到卖模拟能力。
新offer长什么样?
把这三家的牌摊开看,答案就清楚了。
三家同时亮牌,方向却截然不同
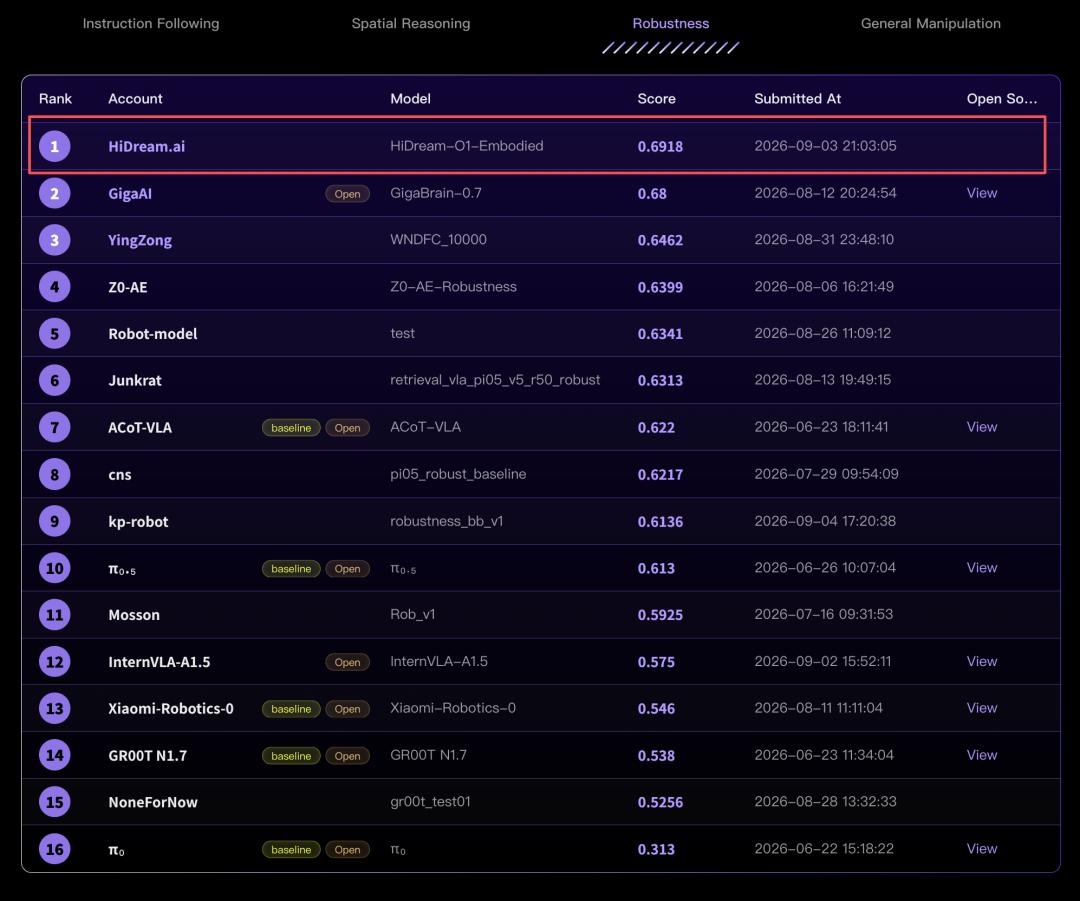
智象HiDream-O1-Embodied走的是“具身感知与抗扰动”路线。它基于全模态底座,把图像、视频、3D、动作统一建模,重点解决一个问题:真实环境里光照会变、视角会偏、物体会脏、手会抖,模型能不能扛住?它在RoboColiseum评测的扰动适应子榜上拿了第一,方法是用多视角冗余(一个摄像头糊了还有别的能顶上)和生成式数据扩增(用动捕数据做底,批量生成不同光照、材质、背景的训练样本)。
生数科技Motus2走的是“机器人操作”路线。它不做虚拟世界,直接奔着真实物理操作去。它的架构里同时跑着三个功能:给你出动作建议、帮你预测执行动作后画面会变成什么样、评估当前任务进展到哪了。这三个功能共享同一套模型参数,用约13万小时的第一视角操作视频训练,覆盖从单目到双目、从人类操作到机器人轨迹的数据。论文里提到,在灵巧操作任务上,预训练后成功率从接近零拉到51%,加入中间训练和强化学习后成功率达到75%,触觉相关任务中两项成功率提升至72.5%。
爱诗科技
更通俗地看,这三家是把“视频生成”往不同落地场景推深:
智象则用多视角冗余抗单路遮挡,配合诺亦腾动捕底料做百倍级光照、背景、物体形态扩增,在RoboColiseum共78项仿真扰动任务中,其中扰动适应子榜0.692登顶;
生数科技把约13万小时单目、双目第一视角操作数据逐步对齐到机器人,同一套参数同时出动作、预测画面、判断进度,失败和次优轨迹也用于学动力学与价值;
爱诗科技把模型当实时引擎,用动态分块处理按键、语音、剧情等不同节奏信号,长程靠分层记忆和错误回收减少角色、镜头、音画跑偏。
三家做的事一句话概括:智象未来让机器人在乱七八糟的真实环境里不抓瞎,生数科技让机器人学会自己规划动作,爱诗科技在虚拟世界里让人能实时互动。
为什么文生视频公司做世界模型,天然有优势
早期文生视频产品大多从影视分镜、广告短片、短视频素材起量,商业模型接近“按条/按分钟/按订阅卖生成次数”。这类需求已经跑出可灵、
也正因如此,视频厂商继续卷画质、卷时长,边际想象空间有限;转世界模型,等于把“出片能力”改成“状态推演能力”,还能同时做游戏交互、机器人训练、工业仿真。
其中具身方向尤其被看作上限更高:机器人真实操作数据稀缺,世界模型能在虚拟环境里无限试错、再用少量真机微调;而视频生成若只做渲染器,优化的是“看起来对”,具身要的模拟器/规划器还要解决“物理对、动作对”。
李飞飞团队对“世界模型”的分类里,文生视频多归渲染器,具身/自动驾驶更靠近模拟器与规划器,两者不是替代关系,而是从像素到物理、从观看到执行的递进。
对视频厂来说,世界模型不一定是放弃短视频,而是给原有时空能力找一个更大的出口:短视频继续变现,世界模型讲长期天花板。
把这三家放在一起看,能发现一个共性逻辑:视频生成模型在“看世界”这件事上,已经积累了远超传统方法的先验知识。
传统机器人训练要从零开始理解“杯子放在桌上”意味着什么——位置、姿态、遮挡关系、光照变化,每一条都要单独建模。而视频模型已经在互联网级别的视觉数据上学过这些了。它知道杯子是圆柱体、放在桌面上会稳、被碰到会滚、被手抓住时指尖会变形。
这些知识不是显式写进去的,而是从海量视频中“看”出来的。
这就是文生视频厂商切入世界模型的第一张底牌:视觉先验的复用。它们不需要从零教模型理解三维空间,模型已经懂了,只是需要把这种理解从“生成画面”转向“推演状态”。
第二张底牌是多模态控制。文生视频模型天然处理文本、图像、音频的组合输入,现在只需要再加动作信号、本体状态、触觉反馈,就能从“按提示出片”升级为“按指令运行世界”。HiDream接语言+多视角+动作,Motus2接语言+本体+触觉,
第三张底牌是数据扩增能力。机器人领域有个公开的难题:高质量真实操作数据极度稀缺。据业内估算全球高质量真实物理交互数据约50万小时,通用具身智能需千万小时级,高阶目标可到亿小时级。视频生成模型恰好能补这个缺口——用合成数据批量生成不同光照、不同背景、不同物体形态的训练样本。智象未来用动捕+生成扩增做到百倍级数据扩展,Motus2用人类第一视角数据迁移到机器人,都是这个逻辑。
还有一个容易被忽略的前提:文生视频厂这几年已经搭好大规模视频清洗、时空建模、算力调度和多模态对齐的底层管线,转世界模型不是从零“招人买卡”,而是把原有能力重新组合。
所以无论是做实时虚拟交互、机器人操作还是具身感知,它们都能较快把“出画面”扩展成“接指令、给反馈、可复盘”,再逐步补物理与数据回流。
但“看得到”和“摸得着”之间,隔着一条巨大的沟
到这里,故事听起来很美。但必须说清楚一件事:视频生成模型理解的“物理”,和真实物理世界之间,还有本质区别。
视频模型学到的是“视觉上的合理性”——画面里杯子看起来放在桌上,看起来没穿模,看起来运动轨迹平滑。但这不等于它真的理解了重力、摩擦力、碰撞力。它不知道杯子是陶瓷的还是泡沫的,不知道桌面上有一滩水会让杯子滑走,不知道抓握力度多大杯子会碎。
这个问题在虚拟世界里影响不大——游戏画面“看起来对”就够了。但一旦要跟真实物理世界交互,光“看起来对”就不够了。
HiDream补了多视角冗余,Motus2补了触觉传感,
更具体地说,有三个工程层面的挑战是所有入局者都绕不开的:
第一,长程运行的状态漂移。世界模型要持续运行,不是生成30秒就结束。但自回归模型有个天然问题:错误会累积。前一秒的小偏差,十秒后可能变成整个场景崩塌。HiDream用多视角冗余降低单路失效风险,Motus2对比了全局自回归和混合记忆的效果差异,
第二,力觉和触觉的跨硬件迁移。Motus2的论文里坦率提到:触觉手套在不同人手上、不同机器人手上,信号会不一样,因为手套形变本身就会产生噪声。这意味着你在一台机器人上训练好的“手感”,换一台机器可能就不对了。视觉可以跨域迁移,力觉却死死绑在硬件上。这个问题不解决,操作类世界模型就只能停留在“看得懂”的层面,到不了“抓得稳”。
第三,也是最关键的——数据回流管线。世界模型不是训一次就结束的产品,它需要持续从真实使用中学习。用户交互产生了什么新行为?机器人执行时哪里失败了?失败后怎么恢复?这些“部署后数据”能不能稳定地回到训练流程里?
目前三家的公开材料都展示了训练数据和方法,但“部署后如何持续回流”这件事,行业整体都还在早期。HiDream需要回收多视角标定和现场回放,Motus2需要回收真机失败和触觉轨迹
没有这条回流管线,世界模型就只是“公开demo里的世界模型”,而不是“能跟着真实世界一起进化的世界模型”。
世界模型的竞争,拼的不是模型,是闭环
把智象未来、生数科技、爱诗科技的公开动作放在一起看,一个趋势已经很清楚了:文生视频的下一站不是“更好的画质”,而是“更深的嵌入”——嵌入到游戏引擎里、嵌入到机器人系统里、嵌入到工业仿真里。
这个转型有天然优势:视觉先验、多模态控制、数据扩增,都是视频生成厂商已经具备的能力。但真正的门槛不在模型侧,而在系统侧——物理交互信号能不能闭环、长程状态有没有显式校正、部署数据能不能稳定回流。
视频生成提供的是入口和先验,仿真器提供的是力学和规则,机器人控制提供的是执行和回传,数据管线把三者串起来。未来3到5年,世界模型的产业形态大概率不是某一家单模型通吃,而是这条链路上不同环节的协作。
谁先把“公开demo里的世界模型”做成“可审计、可回流、可部署的产业系统”,谁才真正跨过了世界模型的门槛。
还有一个更远的悬念留在这里:当世界模型真正跨过门槛,这些起家于文生视频的公司,大概率会先成为软件服务商——卖模型能力、卖模拟次数、卖数据扩增服务。
但世界模型要深度嵌入物理产业,光有软件够吗?
看看它们已经迈出的脚:HiDream的具身版绑定多视角相机硬件做抗扰动;Motus2直接让模型出机器人动作、接触觉传感;
从算法到硬件,中间只隔一层窗户纸。
未来,它们会不会从软件服务商变成软硬一体公司?会不会投资机器人本体、收购硬件团队,甚至亲自下场造一台搭载自己世界模型的机器?
这个问题,现在没有标准答案。
但历史告诉我们,凡是想“运行世界”的,最终都会忍不住想“拥有世界”。
本文来自微信公众号“亿欧网”,作者:刘政鑫,36氪经授权发布。
















