DeepSeek学霸的降维打击:没刷榜,在工位打游戏,模型能力却控制不住地涨
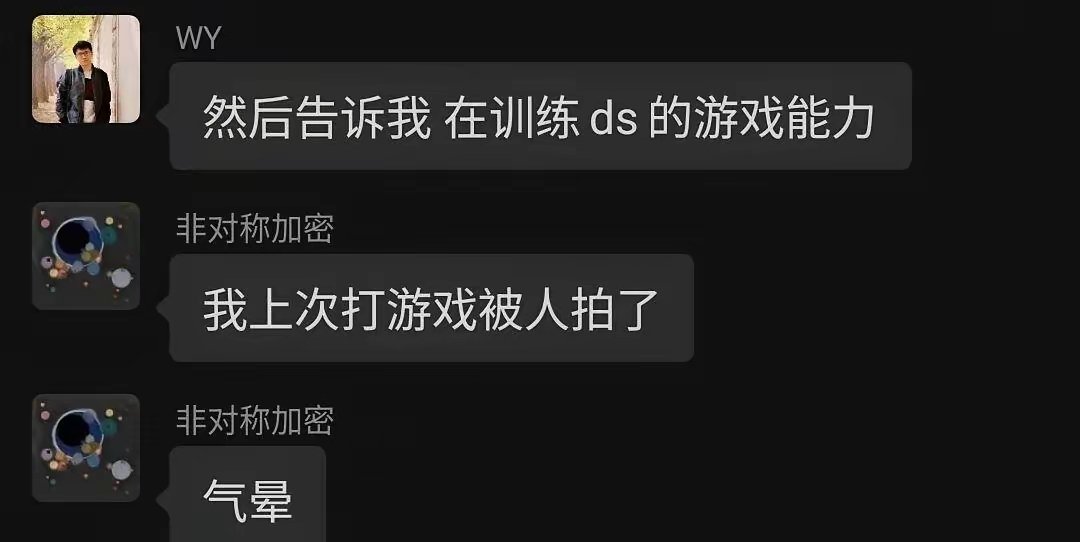
图自推特
在AI大模型这个极度内卷、日夜鏖战的赛道里,如果有一家公司的员工在工作时间公然打游戏,还能让模型能力蹭蹭上涨,友商们的心理阴影面积会有多大?
最近,几张疑似
在截图中,一位ID为“非对称加密”的员工抱怨:“deepswe真没刷,不小心高了,这个点控制不住地涨。”紧接着,另一位员工调侃“swe纯野榜是吧”。而疑似
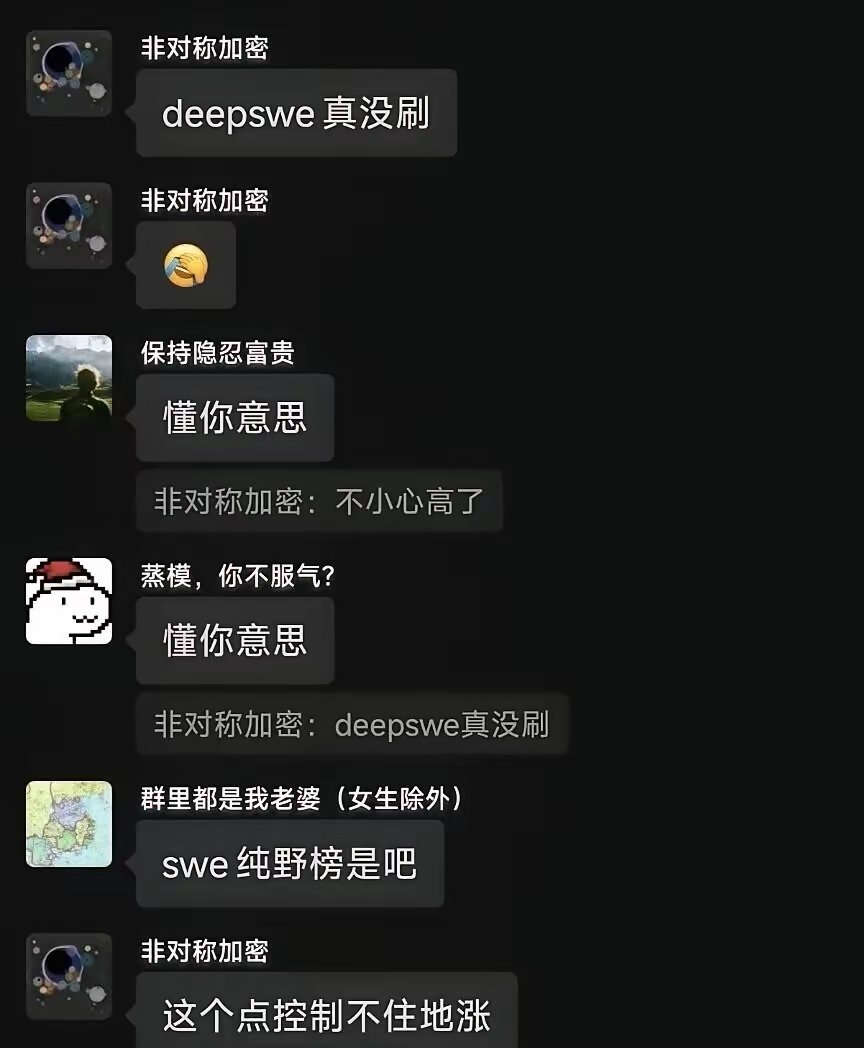
图自推特
这段对话迅速在AI圈炸开了锅。网友@Leo打趣道:“没做任何特殊优化,基准分自己涨了;每天都在打游戏,模型能力却越来越强。这让GLM(智谱)和
这固然是一场带有玩梗性质的互联网狂欢,但剥开这层“凡尔赛”的外衣,它极其生动地折射出了当下中国大模型竞争中的一种令人绝望的智力压制,以及
被误解的“打游戏”与技术的真实底座
在传统的互联网大厂,如果员工在工位上打游戏,大概率会被HR约谈。但在
对话中提到的“deepswe”,其实指向DeepSWE——这是一个专门衡量AI编程智能体(Agent)解决真实代码库问题能力的权威基准测试。与普通的代码补全不同,它要求模型能够独立定位Bug、理解复杂的业务上下文,并写出能跑通的补丁。在这个榜单上,
“真没刷,不小心高了”,这句话的潜台词是:模型的进化,已经不再依赖大量低效的人工数据标注和机械微调,而是依靠底层算法架构的创新和强化学习(RL)的自发涌现。
这背后是
吴俣所说的“在工位玩游戏”,很大程度上是这群极客工程师在极高强度的脑力消耗后的一种调剂。在打游戏的间隙,这帮人可能正在脑子里飞速推演张量并行的切分策略,或者在思考如何让强化学习的Reward Model更加精准。这种看似松散、实则极致专注的氛围,才是他们能够不断做出“反直觉”突破的土壤。
极致的“精英浓度”与奥赛金牌定律
网友关于“奥赛金牌得主”的调侃,恰恰点出了
这群人有什么特点?极其聪明、极其纯粹、对技术有着狂热的信仰。在传统的互联网大厂,员工需要花费大量时间在写周报、做PPT汇报、跨部门沟通对齐上。但在
他们能在极短的时间内看透复杂的数学公式,能敏锐地捕捉到论文中最核心的创新点。当这样一群智商碾压常人的人聚集在一起,用最敏捷的方式去迭代代码时,外界的“内卷”在他们看来,可能只是一场无聊的过家家。
这就好比班里的学神,表面上每天带你打游戏,背地里早就把公式的推导逻辑盘得明明白白。他们说自己“没刷榜”,大概率是真的——因为在正确的底层创新面前,单纯的刷榜毫无意义。这种极致的自由,换来的是极致的创造力。
GLM与Kimi们的“窒息感”
如果把视角转向友商,这段截图带来的恐怕是深深的窒息感。
月之暗面(
智谱脱胎于清华实验室,带着浓厚的学院派色彩。过去他们重心在于政企客户的本地化部署,但如今已全面向云端API服务(MaaS)转型,其API收入占比在近期已飙升至八成以上。他们必须维系庞大的企业客户网络,每一个版本的迭代都要经受商业级应用的严苛考验。而
近一年来,国内大模型圈陷入了疯狂的“卷榜”模式。为了能在跑分上压过竞品,各家公司的工程师们通宵达旦,甚至不惜在测试集上做定向优化(过拟合)。因为榜单排名直接挂钩下一轮融资的估值和下一季度的营销预算。
但这时候,
这种落差感,不仅打脸了同行的技术路径,更动摇了某些“靠资本堆砌、靠营销驱动”的大模型公司的发展叙事。这就好比在战场上,你花重金雇佣了三万精兵,布置了严密的阵型,结果对方派来一个剑客,轻描淡写地一剑就把你的大营给挑了。这种基于纯粹智力的降维打击,比单纯的落后更让人绝望。
极客乌托邦的B面:自由与风险的交织
然而,任何硬币都有两面。
首先是商业化的挑战。顶尖科学家擅长攻克技术壁垒,但大模型最终要走向市场。如何在保持技术领先的同时,构建起繁荣的开发者生态,或者找到高利润的To B/To C应用场景?在这一点上,
其次是组织规模的极限。当团队只有几十、上百人时,扁平化管理和纯粹的技术驱动能爆发出惊人的战斗力。但当公司规模随着业务扩张而膨胀时,如果没有严谨的现代企业管理制度,极客文化很容易演变成各自为战的混乱。缺乏外部压力的“自由”,往往会在不知不觉中滑向效率的深渊。
但至少在这一刻,
结语
大模型的下半场,竞争的焦点正在从“谁烧的钱多、谁的显卡多”,回归到“谁的算法更优雅、谁的人才更顶尖”。
“在工位打游戏”只是一个由头,它撕开了AI行业最残酷的一面:在这个由全世界最聪明的大脑主导的竞技场里,努力只是标配,天赋和灵感才是决定上限的胜负手。
对于GLM和
本文来自微信公众号“Tech商业”,作者:Tech商业,36氪经授权发布。
















