DeepSeek新模型登场,用户要给AI付的钱又少了
当性能与成本的边界被重新划定,模型竞争开始进入另一种算法。
在一场大崩溃之后,宕机的真相水落石出,10月17日,
看模型后缀会觉得这是一次小版本更新,但是主题和方向非常清晰,那就是继续降低AI的使用成本,甚至活久见的是
在
这也牵扯出一个普通用户该关心的问题,当模型已经能够完成复杂编程任务,用户究竟应该为多少智能付费?
目前,
与此同时,
一边是更便宜、更高效的任务执行,一边是向外开放更多基础能力。
01
想办法让AI更便宜
过去两年,大模型行业习惯于用榜单解释竞争。
谁的推理能力更强,谁的编程得分更高,谁能在数学、知识问答或代码测试中领先,往往构成模型发布时最醒目的叙事。参数规模、训练数据和推理能力,也因此成为衡量模型进步的主要尺度。
但随着模型开始进入真实的软件开发流程,单纯的分数已经不够了。
一个能够回答编程问题的模型,与一个能够理解需求、调用工具、修改代码、运行测试并反复修复错误的编程智能体,实际上是两种不同的产品。前者主要提供答案,后者需要把答案转化为可交付的结果。
成本也随之发生变化。
用户购买的,不再只是模型生成的若干Token,而是一个任务最终完成所消耗的全部资源。模型思考得越久、调用工具越频繁、失败后重试越多,最终账单就越难由单次调用价格解释。
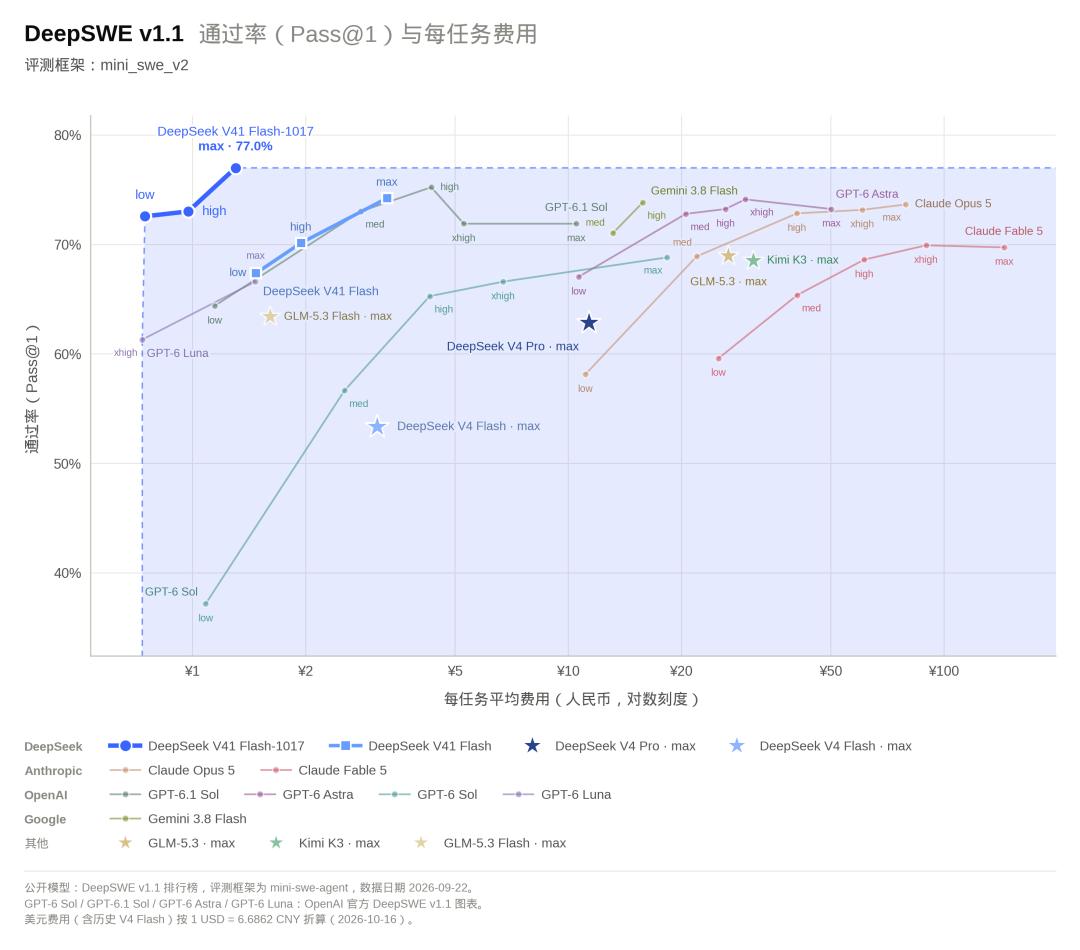
图表横轴是每项任务的平均费用,采用对数刻度;纵轴是Pass@1,即在给定评测条件下,单次尝试通过任务的比例。图中不同模型的不同推理档位被放在同一坐标系里,性能和价格由此形成一组可以直接比较的关系。
不少海外模型需要付出数十元乃至更高的单任务平均费用,才能获得与低成本模型接近的通过率。
这才是这次升级真正值得关注的地方。
如果一个模型只是从70%提升到72%,却需要付出成倍增加的推理成本,那么它的优势未必能够转化为商业优势。反过来,如果模型能够在提高成功率的同时减少运行时间和输出长度,它带来的就不仅是性能改善,还有单位任务经济性的变化。
当然,这张图并不能证明
但
02
真正的考场,不是写出代码,而是交付项目
如果说77%的通过率证明了模型在特定测试中的进步,那么
在官方发布的案例中,
这些案例有一个共同点:用户提出的不是一道边界清晰的编程题,而是一个需要从零开始构建的完整项目。
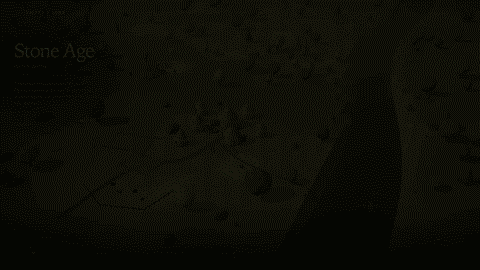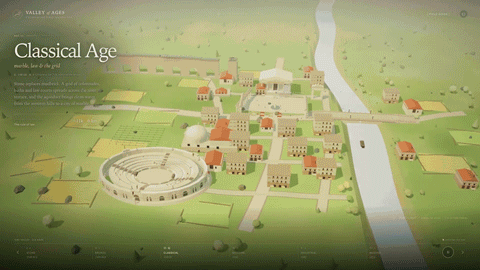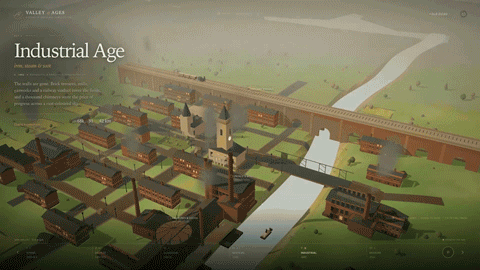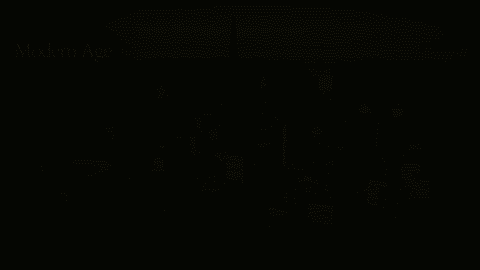
以游戏开发为例,模型需要理解需求,组织场景和交互逻辑,生成代码,再通过运行和调试逐步修正问题。一个看似简单的游戏,背后可能涉及碰撞检测、物理运动、摄像机控制、关卡设计和用户交互。3D建模项目则还要处理空间结构、材质、光照与场景组织。
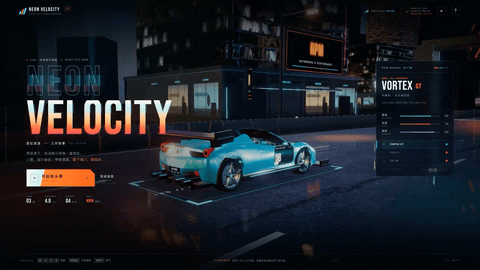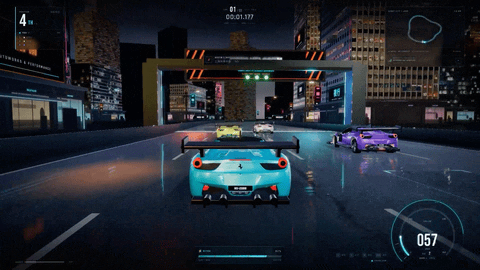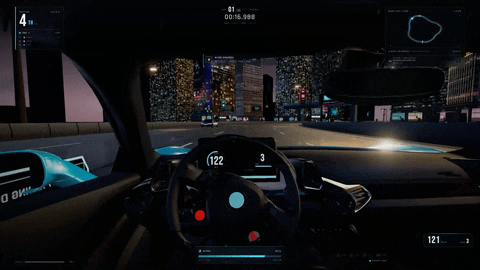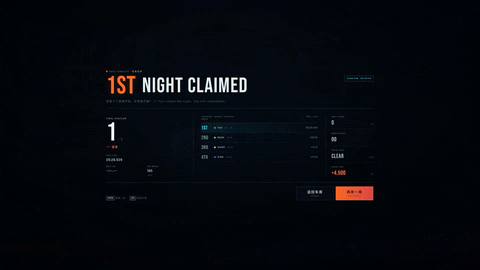
图|
这类任务很难仅靠一次生成完成。
用户真正想要的,通常也不是一段漂亮的代码,而是一个能够运行、能够交互、可以继续修改的作品。
图|
所谓“许愿式编程”,并不意味着用户不需要表达需求,更不意味着复杂软件可以完全脱离工程约束。它指向的是一种交互方式的变化:用户不必事先掌握每一项技术细节,也可以先描述自己希望实现的结果,再让模型承担更多从需求到实现的中间工作。
过去,用户需要知道如何写代码;现在,用户可以先描述想做什么。
两者之间的距离,决定了AI编程工具能够进入多大范围的用户群体。
这也是为什么Harness正在成为竞争的重要组成部分。
模型本身提供推理和生成能力,Harness则负责把模型放进一个可以持续工作的环境:组织任务、调用工具、管理上下文、执行代码、读取结果,并在失败后继续尝试。模型能力决定了它能否解决问题,运行框架则影响它能否以稳定、可控的方式解决问题。
这并非
这意味着,模型的进步并不只发生在参数或训练方法层面,也发生在它与外部软件环境的连接之中。
03
从模型价格到工具收费,DeepSeek开始补齐另一块拼图
此次更新还有一个容易被编程案例遮住的动作:
按照官方介绍,
两个接口的价格均为每1000次成功请求5元。官方文档同时说明,只有请求成功且产生有效结果时才计费。通过Claude Code和Codex等工具调用搜索能力的免费安排,则将在官方规定的两周窗口后转入收费机制。
表面看,这是一次API产品线的扩展;放在整次更新里,它还有另一层意义。
智能体要完成一个真实任务,往往不只需要一个足够聪明的模型。它还需要获取外部信息、阅读网页、调用软件工具,并把这些环节组织成连续的工作流。
当模型开始承担更复杂的任务,搜索、抓取和工具调用就不再只是附属功能,而是决定任务能否完成的重要基础设施。
过去,模型厂商更容易围绕Token建立商业模式:输入多少、输出多少,按照调用量收费。随着智能体走向更复杂的工作流程,成本结构也在变得更加多元。模型推理、搜索、网页抓取、代码执行和反复验证,都可能成为一项任务的成本组成部分。
但开放接口不等于已经建立完整的商业生态。接口的稳定性、搜索结果质量、调用限制、开发者使用规模,以及这些工具与模型之间的协同效率,最终都会影响它能否成为可持续的业务。
尤其值得注意的是,
从这个角度看,
如果模型更聪明,却需要大量调用和重试,成本优势可能被消耗;如果模型足够便宜,却无法稳定完成复杂任务,低价也难以形成真正的竞争力;如果模型能够执行任务,却缺少可靠的信息获取与工具协同,智能体的应用边界依然有限。
真正的竞争,最终取决于这些环节能否形成一个有效的整体。
这条路并不轻松。随着任务复杂度上升,用户对可靠性、响应速度和交付质量的要求也会同步提高。低成本可以降低尝试门槛,却无法自动解决复杂任务中的失败、错误与维护问题。
因此,
它要求模型厂商回答的不再只是“我的模型比你强多少”,而是“在相同的预算里,我究竟能替用户完成多少工作”。
当模型能力越来越接近,任务成本、运行效率和工具生态就可能成为决定商业化空间的关键变量。对用户而言,这意味着更多工作有机会以更低成本交给AI;对行业而言,则意味着曾经由模型能力差距支撑的价格空间,可能需要重新评估。
本文来自微信公众号“凤凰网科技”,作者:Dale,编辑:董雨晴,36氪经授权发布。
















