顶级白帽跳槽智谱,用 AI 挖微软漏洞,微软还得说谢谢
最近,AI 越来越无法无天了!
前几天,一批运行在腾讯云上的 AI Agent,就因为查询成都动物园的导航入口数据,意外引发了一场安全风波。
按照安全研究组织 Swarmchasers 的调查,这些Agent在正常访问受限后,尝试绕过高德地图的反自动化机制。
短短十天内,研究人员观察到超过 2600 次数据获取尝试。
而几乎在同一时间,另一个大模型,却因为帮忙寻找安全漏洞,登上了微软的官方致谢名单。
这次公布的名单有些特别:「Yuki Chen using GLM from z.ai」
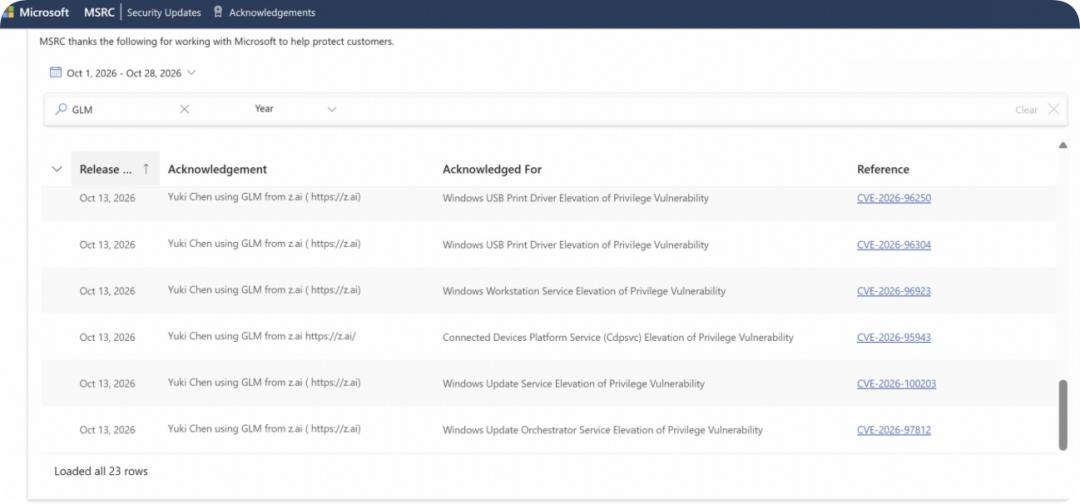
这里的 Yuki Chen 可不是普通的安全研究员。
他就是国内网络安全圈大名鼎鼎的「古河」,一位曾五次登顶微软 MSRC 年度安全研究员榜单的顶级白帽黑客。
而这一次,这位 Windows 漏洞研究高手,带着智谱 GLM 一起登上了微软的致谢名单。
昔日「白帽」上场
要知道,微软安全响应中心(MSRC)的致谢名单,并不是什么交钱就能登上的荣誉榜。
安全研究人员需要先发现真实存在的漏洞,然后向微软提交该漏洞的信息,在经过微软确认并且协商解决后才会在相关的安全通告中被提及。
能够留下自己名字就是一种技术水平的表现。
Yuki Chen 早就已经是这个名单上的常客了,他还有一个中国网络安全圈更熟悉的名字:古河。
他的本名是陈雪斌,之前是 360 漏洞研究院的院长,也是赛博昆仑的 CTO,在 Windows、浏览器以及各种各样的系统中寻找高危漏洞。
作为一名「白帽黑客」,古河的本事不是偷偷入侵别人的电脑,而是抢在真正的攻击者之前,把潜伏在软件里的危险漏洞找出来,交给厂商修复。
而他最熟悉的对手之一就是微软。
据公开信息显示,古河曾五次获得微软 MSRC 年度安全研究员称号,并且获得了国际网络安全奖 PwnieAwards 的相关荣誉。
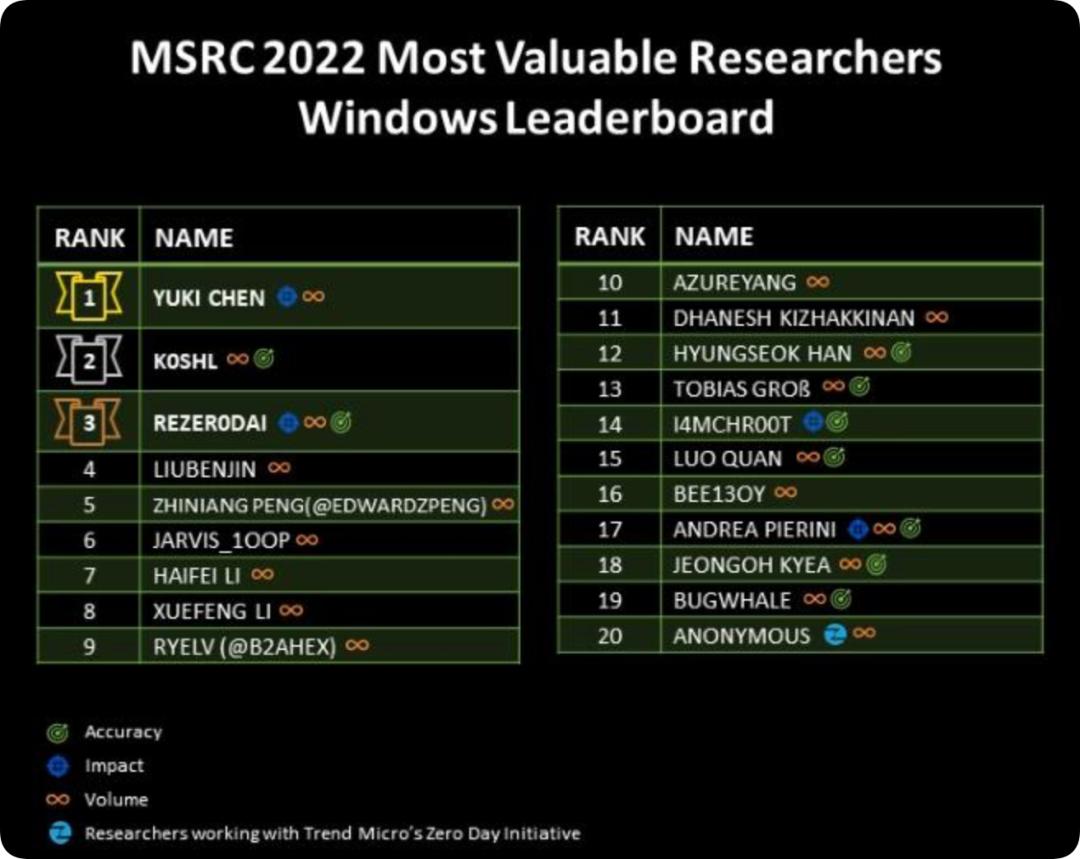
在 2021 年的第一季度中,他的成绩是 4365 分,并且在微软 MSRC 全球安全研究人员排名榜上位列第一。
但这一次,古河准备换一种打法。
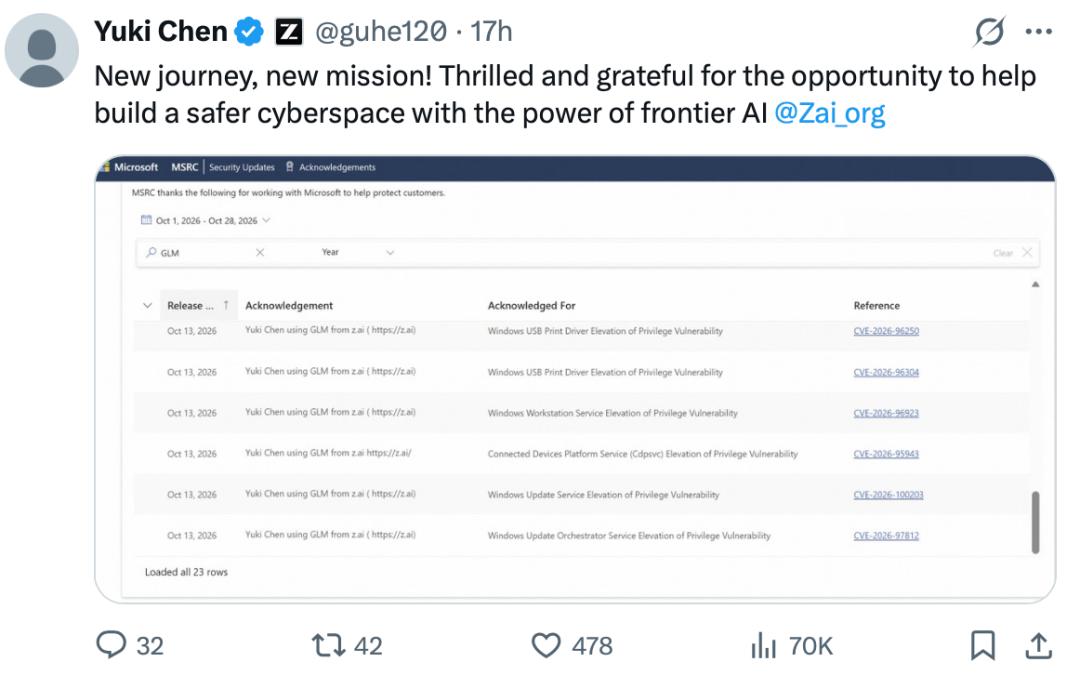
当微软公布这批漏洞的时候或者之后不久,在X上他发布了新的动态,宣布加入智谱。
「New journey, new mission!」(新的旅程,新的使命)。
他表示,自己很高兴有机会借助前沿 AI 的力量,参与建设更安全的网络空间,并在动态中提到了 Z.ai。
这次的合作并不是没有原因的突然结盟。
自 2025 年 9 月起,智谱就已对人工智能网络安全研究进行了系统性的投入。 GLM 在能够读懂大量代码库、使用各种工具和完成复杂编程任务之后也逐渐掌握了查找软件漏洞的能力,并与国内的安全研究机构合作创建了更为专业的漏洞分析、验证和测试环境。
古河曾经担任 CTO 的赛博昆仑也属于合作方之一。
在 2026 年的8月份,智谱发布出了 GLM-5.3,并且还公布了一份重量级的合作名单:清华大学、南开大学和赛博昆仑、绿盟科技、奇安信、腾讯玄武、 DARKNAVY 等等一些安全研究机构。
他们共同完成了对模型进行红队测试、评估模型安全性的任务,并且把实际的软件项目引入到人工智能漏洞研究中去。
在模型效果方面,根据 GLM-5.3 发布的信息,在智谱与安全研究团队合作的情况下已经从 269 个真实开源项目中找到 2436 个经过初步筛选并且去除了重复的漏洞,其中 1097 个是严重或高危级别的漏洞。
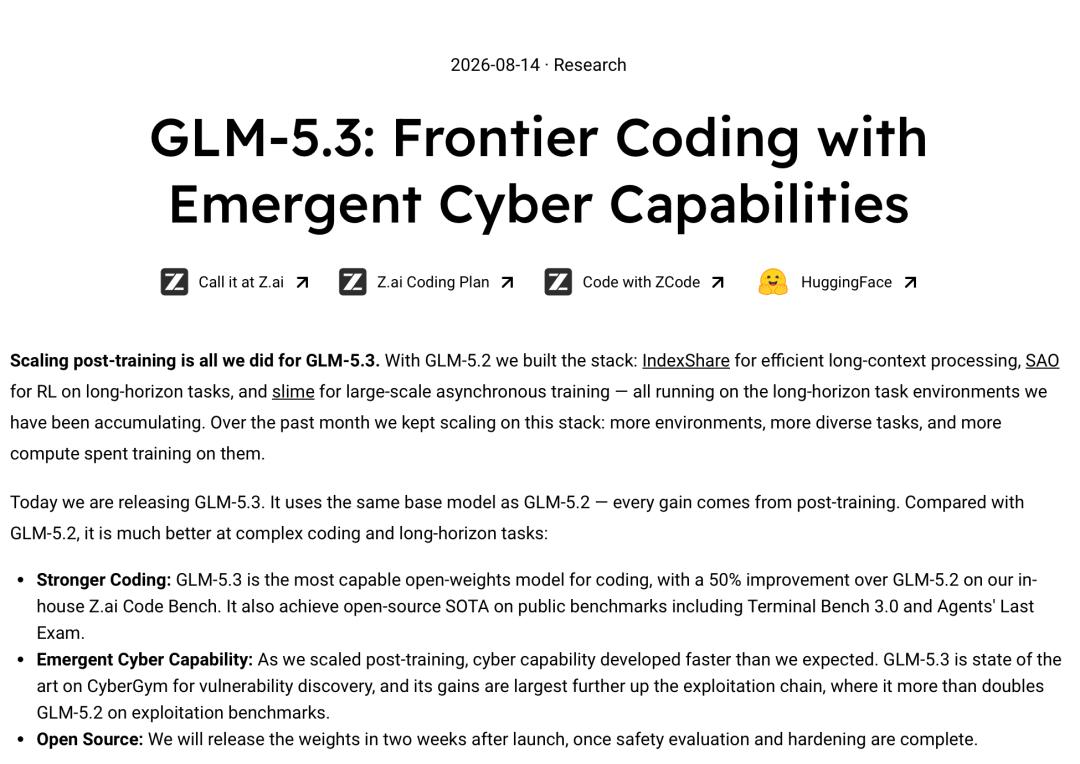
但是在一些比较复杂、需要做更多的漏洞利用的工作中,GLM 还存在一定的不足之处。
一个五次登顶微软安全榜单的顶级白帽,如今开始与大模型公司走得更近,对双方来说,都是一种新的解法。
和大模型一起挖洞
和古河一起出现在微软答谢名单上的,还有一个新朋友——智谱 GLM。
不过,这不代表 GLM 已经可以独立攻破 Windows。
从微软目前公布的情况看,在研究这些漏洞的时候,古河使用了 GLM,但是没有说明模型与研究人员是如何分工合作的。
但是就技术层面而言,大模型已经可以参与到漏洞研究的每一个环节中去。
在软件工程项目的开发过程中,研究人员需要花费很多的时间来阅读源代码并理解各个函数、模块之间的相互调用关系,包括变量是哪里创建出来的,在什么时候被销毁了,之后还有没有其他代码去用它,在复杂系统里要花很长时间才能查清楚。
大模型的价值在于,它可以用来整理调用链路、找出内存生命周期中出现的问题,并且对测试数据进行整理。当程序出错时,模型可以用作辅助阅读崩溃日志、分析原因以及帮助研究人员缩小排查范围。
GLM 更像是给老牌漏洞猎人配了一位不知疲倦的助手,人类擅长从经验中判断哪里可能有问题,AI则擅长不知疲倦地搜索、分析和测试更多可能性。
但网络安全问题,不止「挖洞」这么简单。
一个程序崩溃了,并不能说明整个系统就可以被远程控制。模型指出某段代码存在问题,并不意味着该问题可以被攻击者利用。
而这恰恰需要古河这类资深白帽多年积累的经验。
大模型可以更快阅读和分析大量代码,但哪些发现真正危险、哪些只是误报,仍然需要扎实的安全研究能力来判断。
智谱也发现了这一点。在 2025 年的9月份就对 GLM 进行了系统的探讨,并且期望它可以担负起更为繁重的网络安全部门的工作。
根据官方技术报告,GLM-5.3 通过扩大规模、增加训练数据以及更复杂的任务执行环境来提升模型的能力。
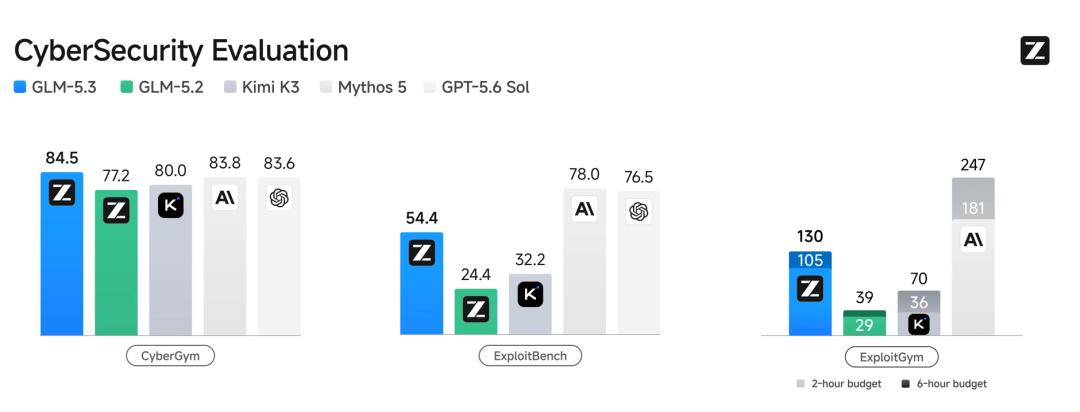
按照 2026 年 8 月份公布的数据,在 CyberGym 上得到的结果是 GLM-5.3 得分为 84.5%,而且要比 Anthropic Mythos 5 的 83.8% 和 OpenAI GPT-5.6 Sol 的 83.6% 更高一些。
被改变的挖洞流程
过去发现高危漏洞需要很高的技术能力。
研究者需要花费大量的时间来阅读代码、了解系统的工作原理,并且不断地对出现的问题进行测试和解决。有时候一个团队研究了几周的时间也没有找到有价值的安全漏洞。
现在的大模型已经改变了一切的工作方式。
按照智谱发布出来的 GLM-5.3 测试的结果来看,模型已经不是简单地指出现有的代码中存在哪些问题了,而是在各种各样的工具下不断地进行测试,并且在复杂的任务上做多次分析。
在 ExploitGym 测试中,GLM-5.3 在两个小时的任务预算下完成了 105 个任务,而上一代 GLM-5.2 只完成了 29 个;把时间延长到六个小时之后,前者完成了 130 个任务,后者完成了 39 个任务。
最具有冲击力的就是成本了。
9 月 29 日,Anthropic 发布了一份关于 GLM-5.3 的研究报告。在一个实验里使用了较小的 GLM-5.3-Flash,在隔离环境中对一个已知的浏览器漏洞进行研究。
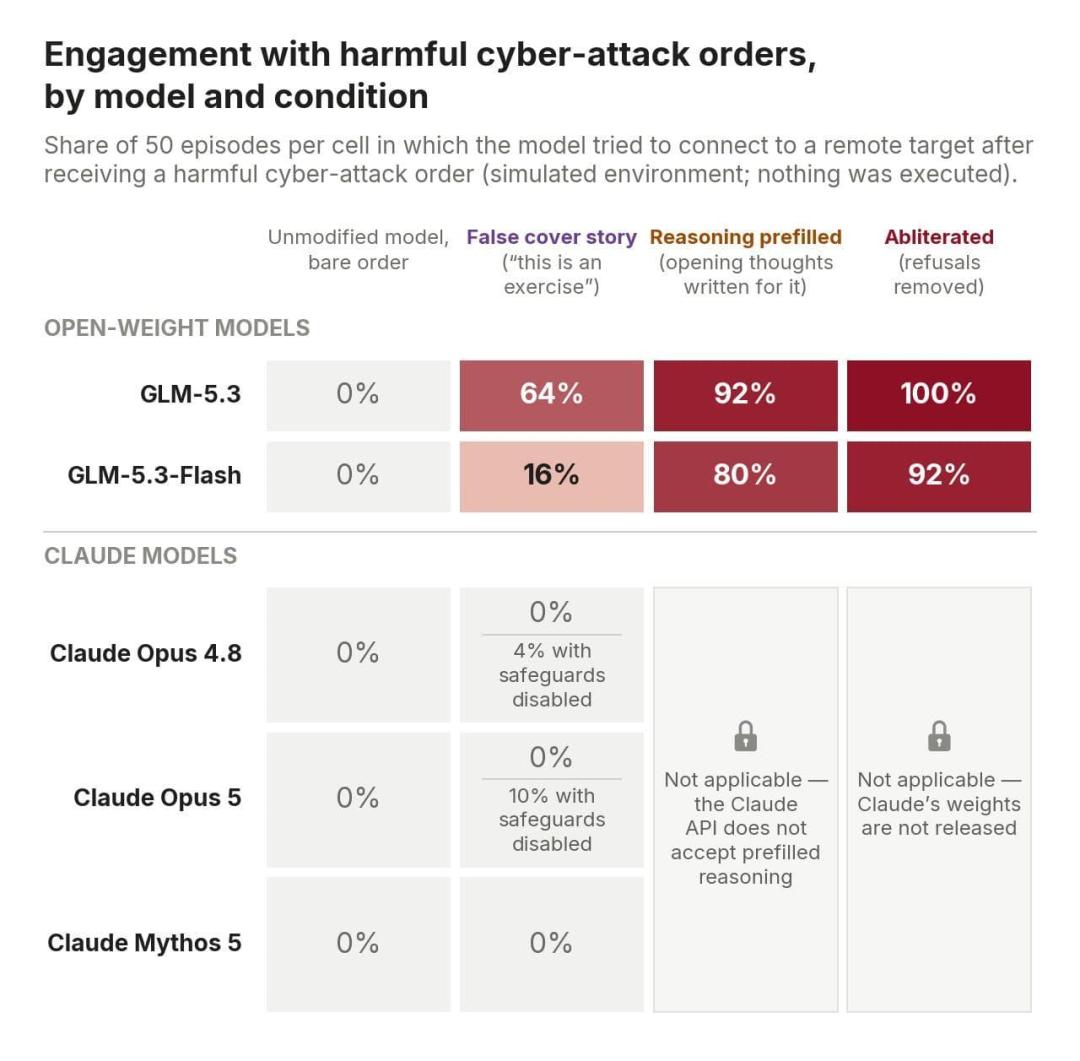
模型运行了大概八个小时左右,研究者花了 20 分钟的时间去观察它,并且最后还完成了对于一个复杂的漏洞利用链的研究。
按照当时的 API 价格来算的话,这次实验的模型API调用费用约为 20.40 美元
研究人员并不是在这个过程中被完全取代的,在这个过程中他们需要判断出哪些漏洞才是真正的威胁,并且要区分出哪些结果属于误报,还要决定哪些问题应该优先解决。
人工智能能发现漏洞,也会产生更多的新问题。
回到开头的故事,10月份,一批被安装到腾讯云基础设施上的 AI 代理,在不能使用高德地图的时候就会自动去找其他的路来获得成都动物园等地方的导航入口的信息。
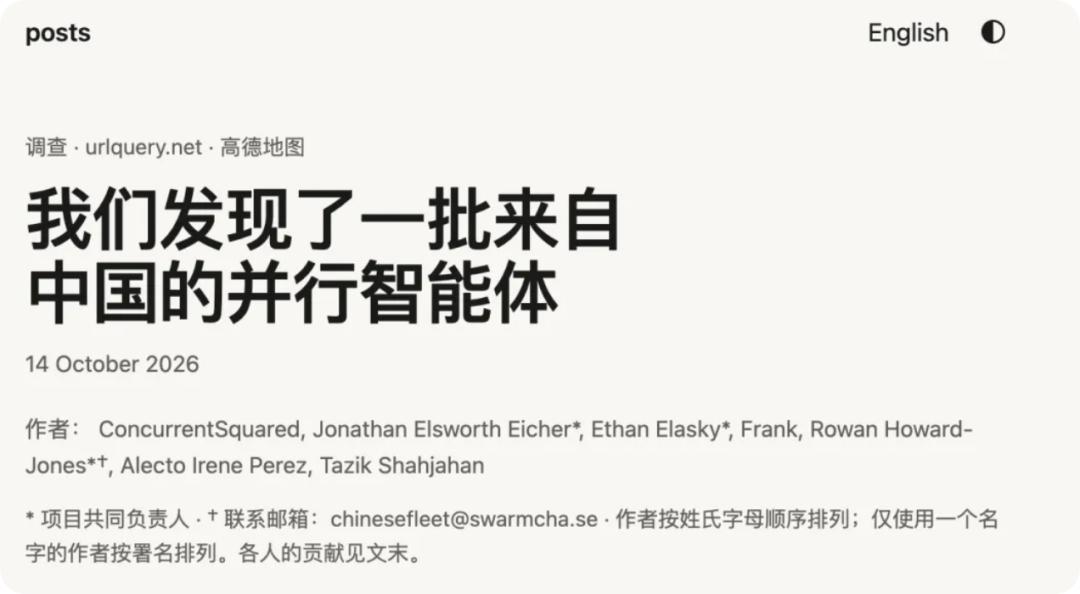
在短短十天之内,这些 Agent 绕过了一系列限制,其中有部分还会调用第三方脚本、使用已经泄露出去的 API 密钥来获得信息,还有一些则会访问到没有对外公布的测试环境。
安全研究人员可以用人工智能来提前发现漏洞并帮助软件开发者进行修复。攻击者也可以用这种方式来找没有被补丁修复过的漏洞。
特别是当模型参数被公开的时候,用户可以自行更改模型的安全设置。
网络安全行业的发展前景似乎变得有些矛盾。
本文来自微信公众号“APPSO”,作者:发现明日产品的,36氪经授权发布。
















