突发,GPT-6 Sol曝光了
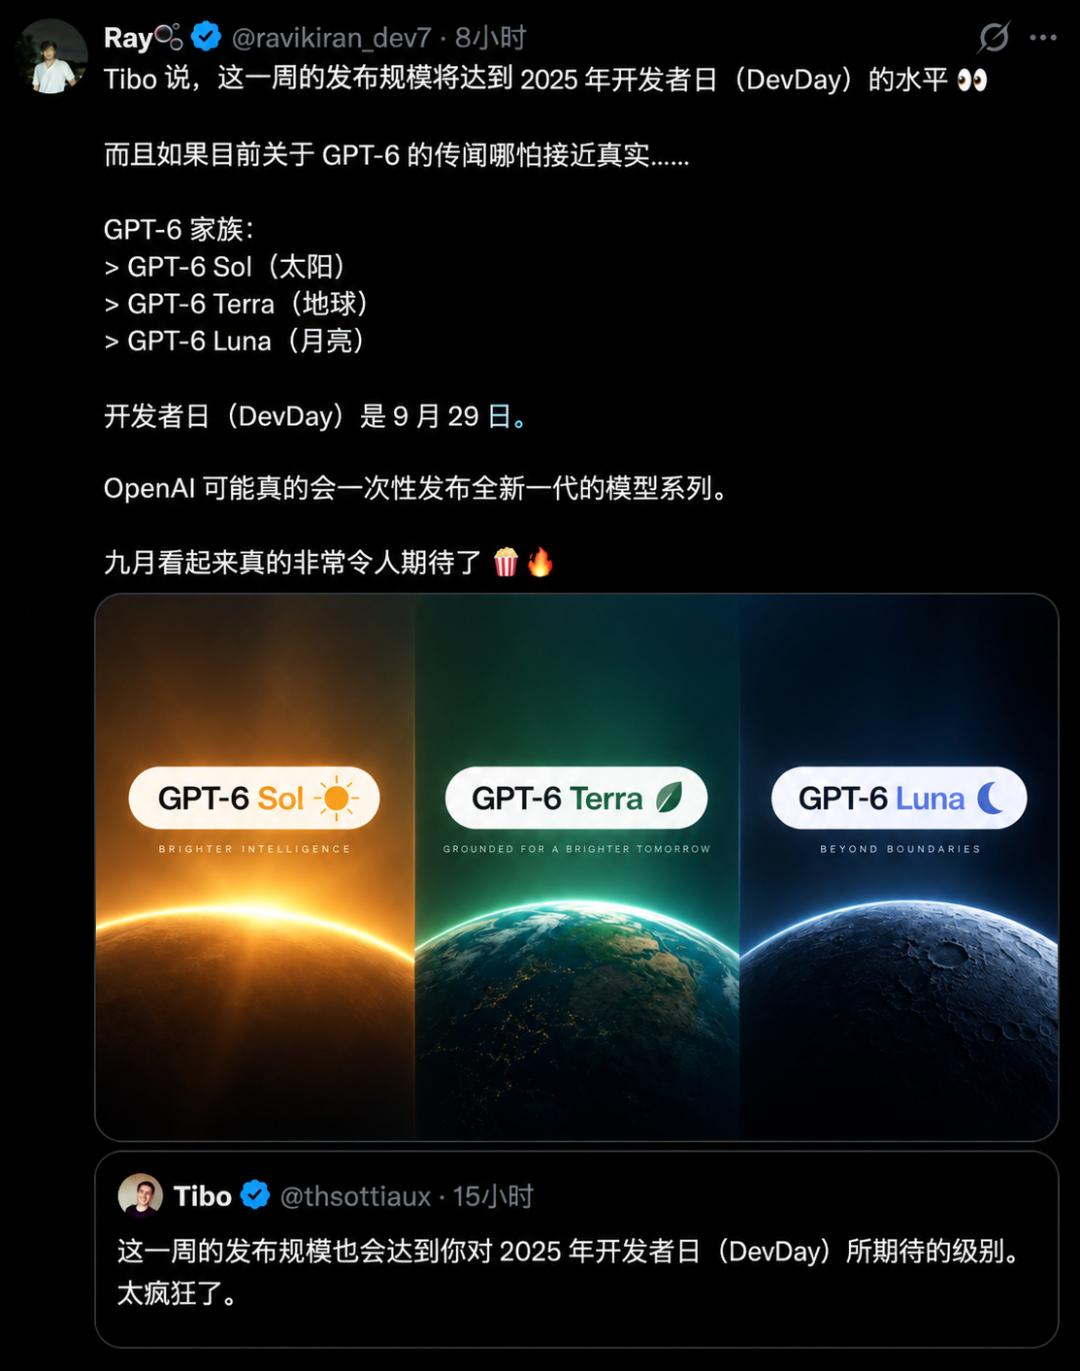
重大消息:GPT-6 Sol 正在内部测试,且已在 OpenAI API 中被发现,预计本月正式发布。
就在昨天深夜,奥特曼的一句爆料,让所有人都兴奋起来。
他发了一个「🚢(Ship/发布)」的表情,并配文:「这周将有大动作。然后,我们 DevDay 见。」
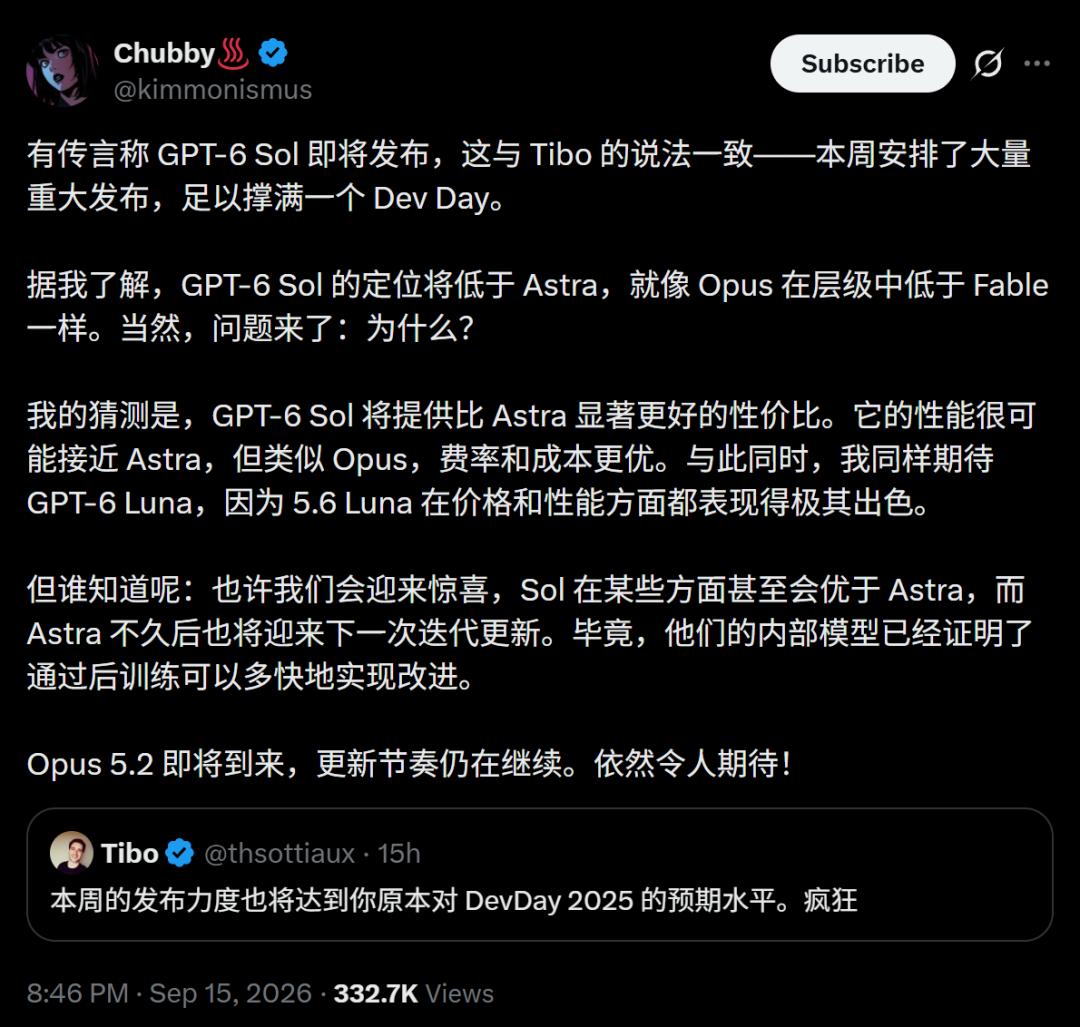
重置哥 Tibo 更是直言不讳:「本周的发布力度,将达到你原本对 DevDay 2025 预期的水平。简直疯狂!」
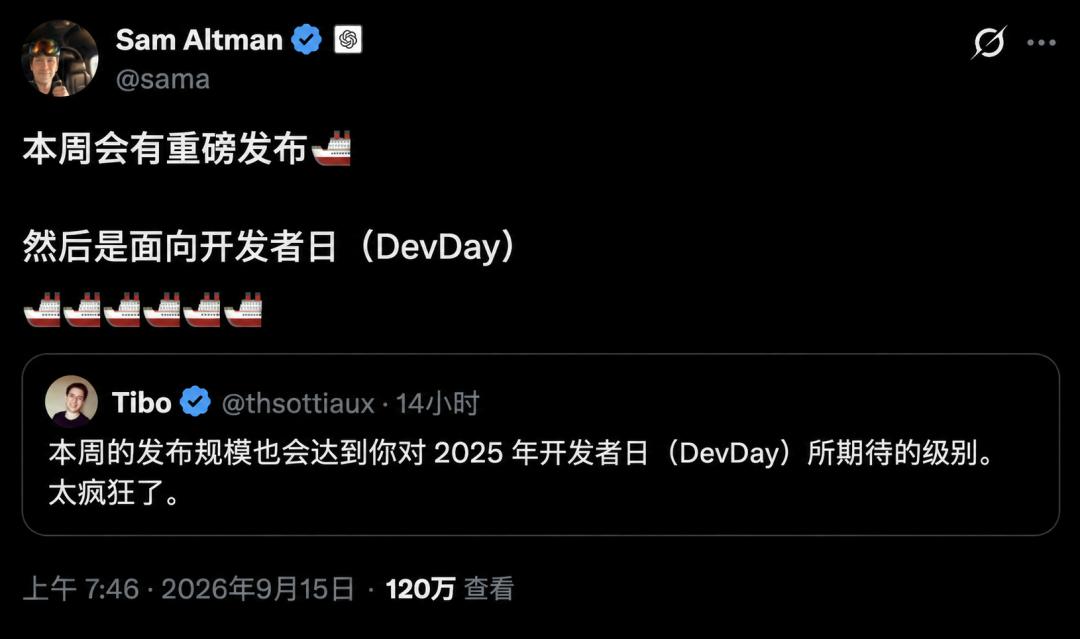
圈内的最新爆料,也印证了他们的说法:Opus 5.2和GPT-6 Sol,都会于本月上线。
现在,已经有众多开发者发现,自己手中的 5.6 Sol,已经被悄悄自动路由至全新的 「GPT-6-Sol」!
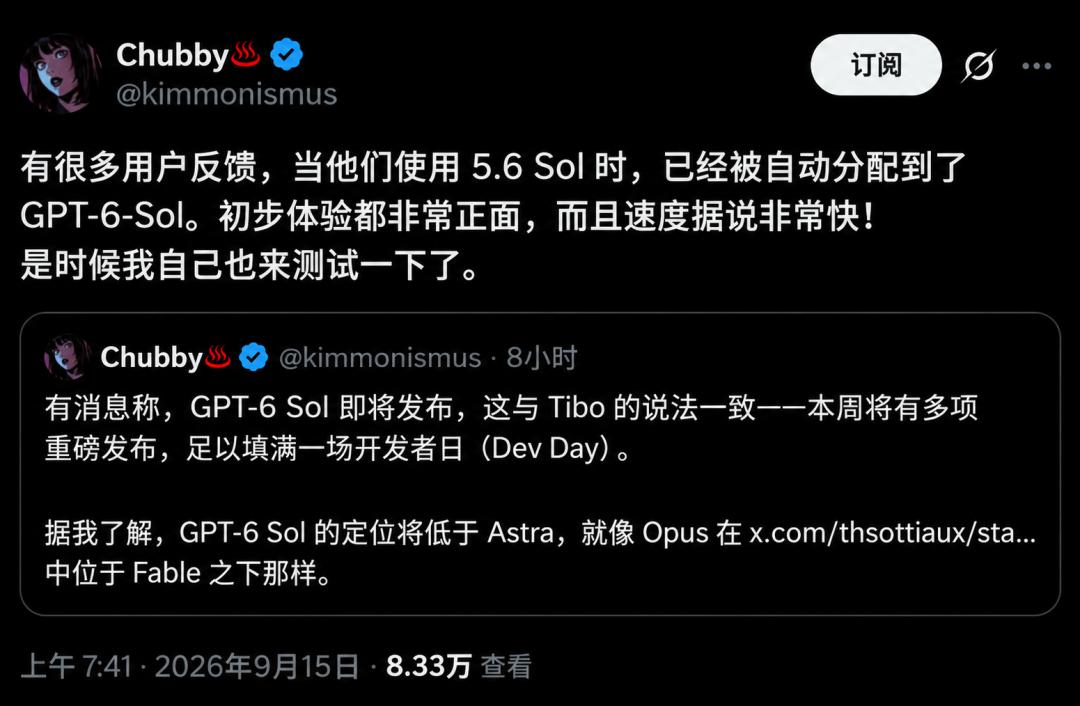
实测反馈,可以用四个字概括——快到飞起。
三连爆:GPT-6-Sol实测震撼
而且就在昨天,已经有关于GPT-6 Sol的实测案例流出了。
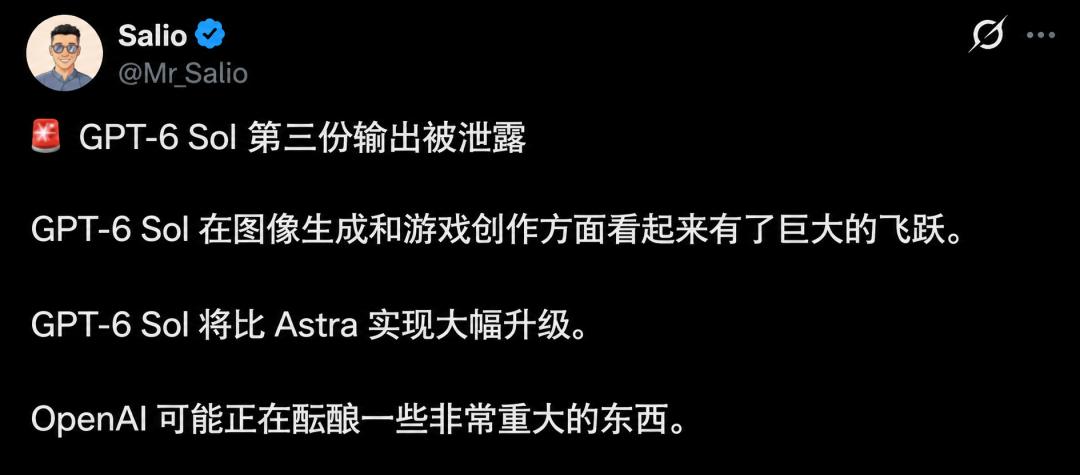
一个名叫Salio的大V,连续甩出了关于 GPT-6 Sol 的三弹重磅泄露。
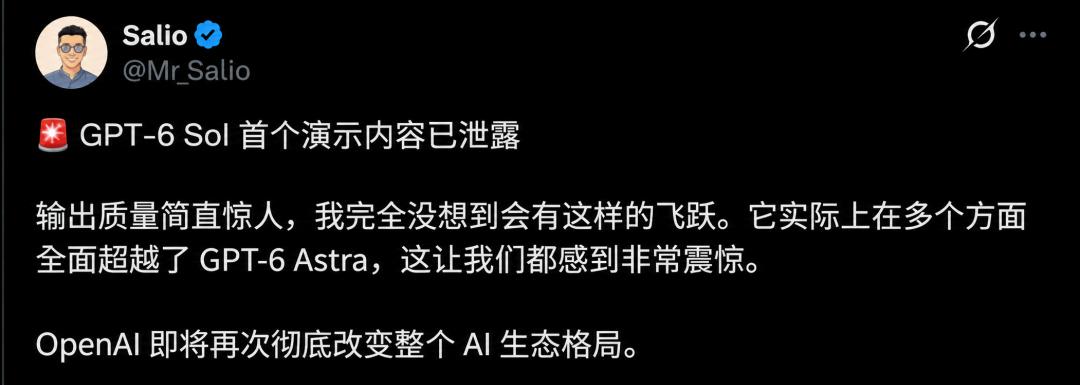
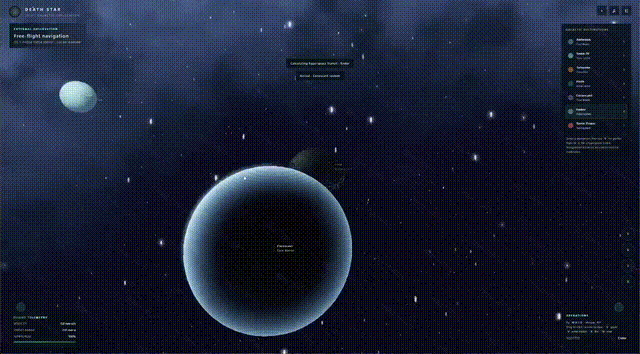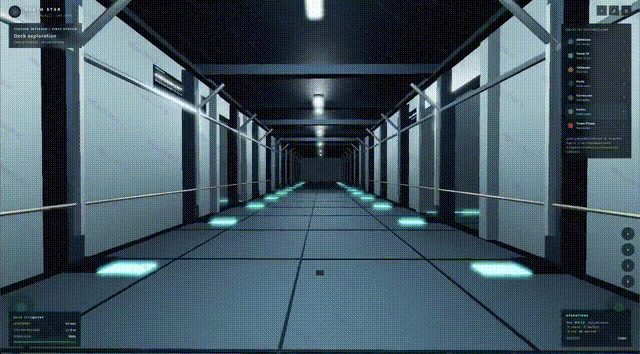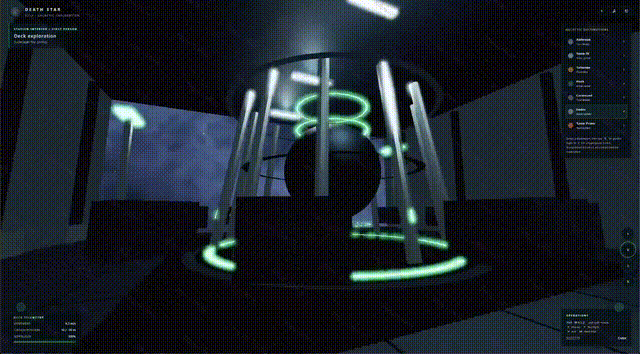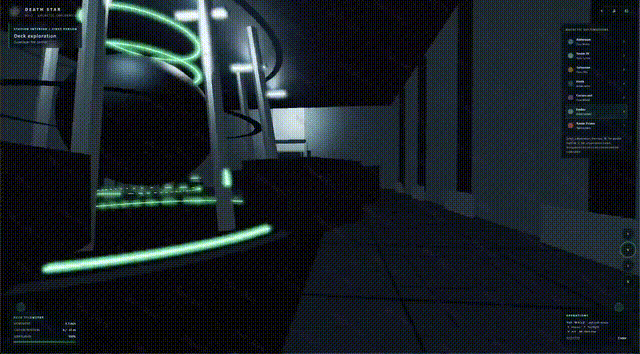
第一弹 :质量惊人,碾压GPT-6 Astra
在GPT-6 Sol的首个演示中,它的输出质量体现了巨大的飞跃。
而且,在多个方面上,它几乎全面超越了GPT-6 Astra。
第二弹:编程与前端的降维打击
第二段泄露显示,GPT-6 Sol 在编程和前端生成上击败了GPT-6 Astra,输出质量简直「逆天」。
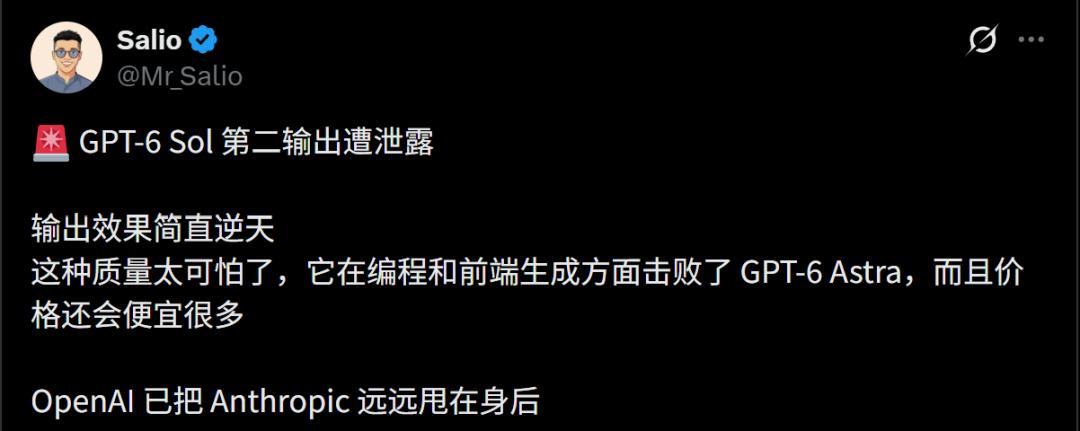
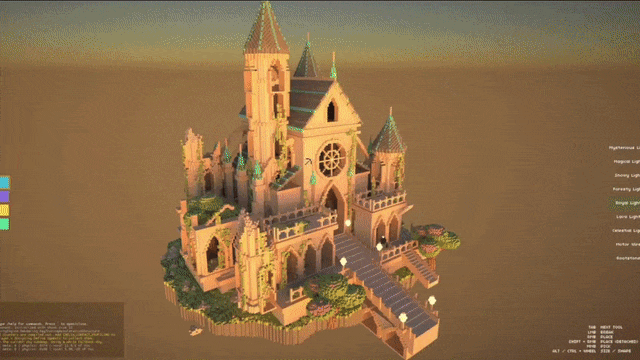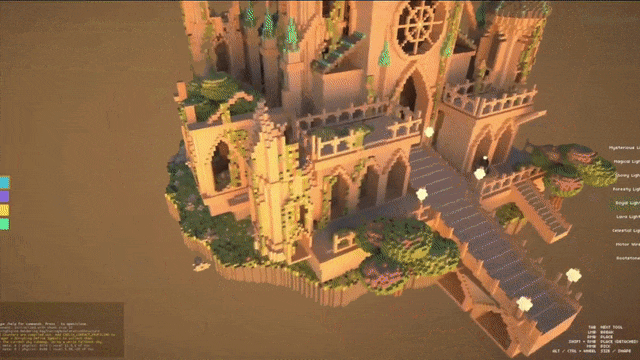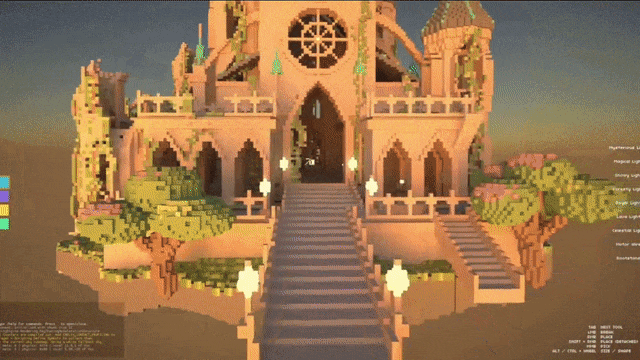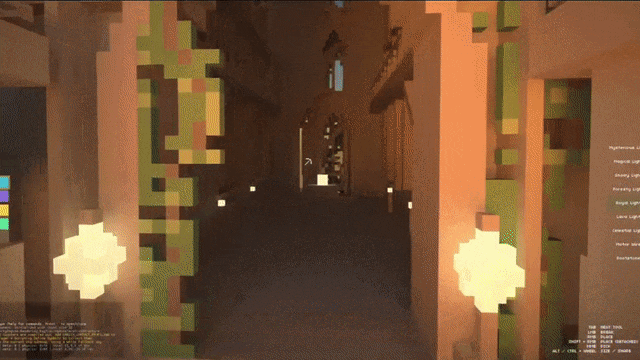
更可怕的是,它的生成成本被压得极低,价格要便宜得多!
实测开发者评论说:「OpenAI这是要把Anthropic远远甩在身后了!」
第三弹:视觉生成与游戏创作的质变
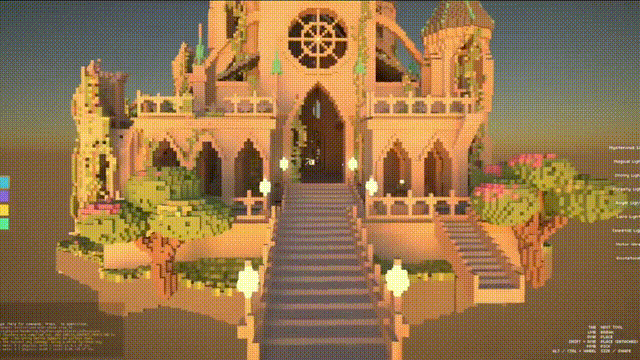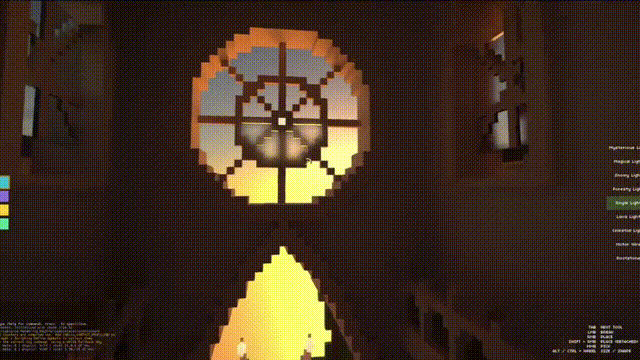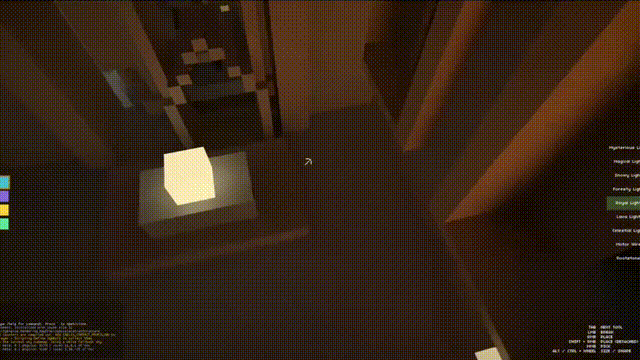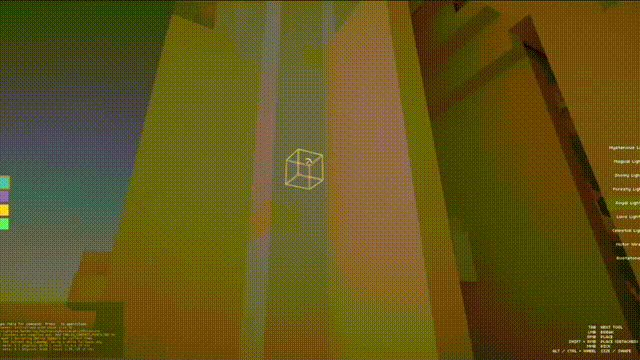
第三弹显示,GPT-6 Sol在视觉生成和游戏创作上,都有了巨大飞跃。
在动态画面生成、实时交互场景以及游戏引擎级创作上,Sol都令人印象深刻。
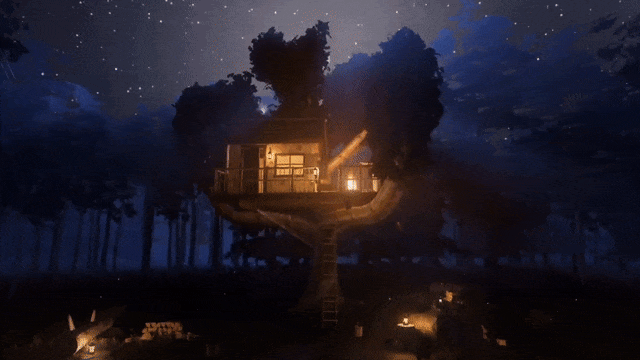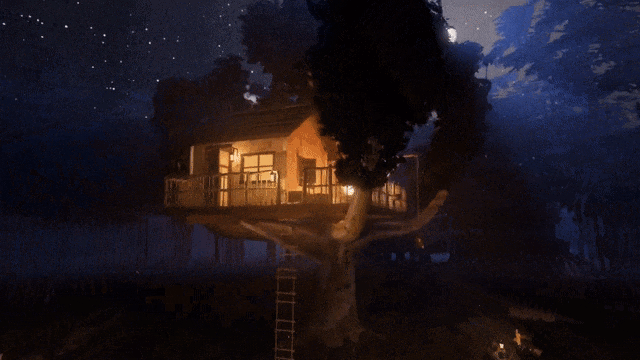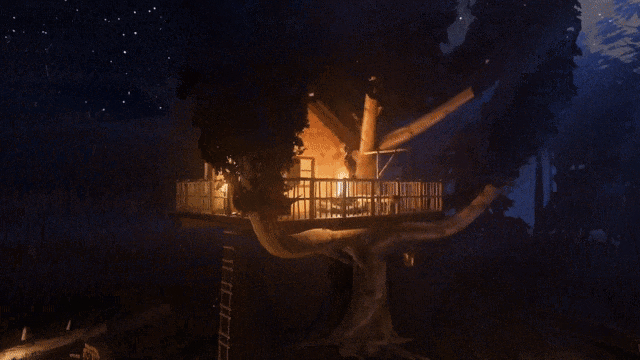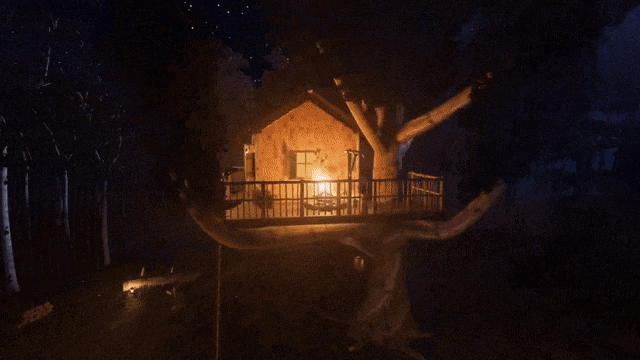
在下图中,画面细腻度和逻辑连贯性表现惊人,测试者评价说,这绝对是对Astra 的一次重大升级。
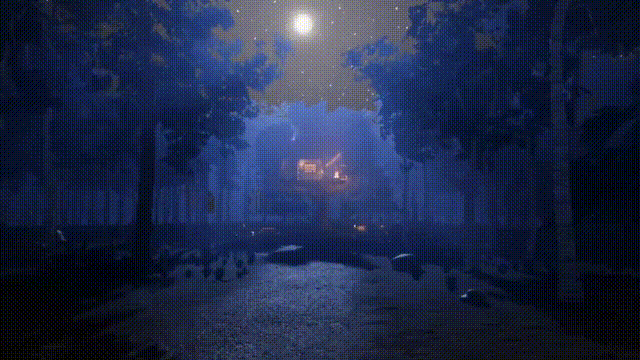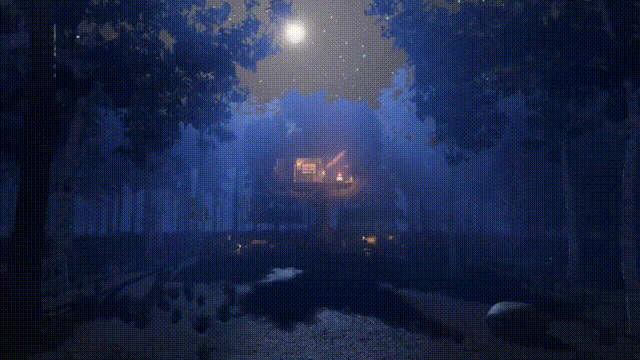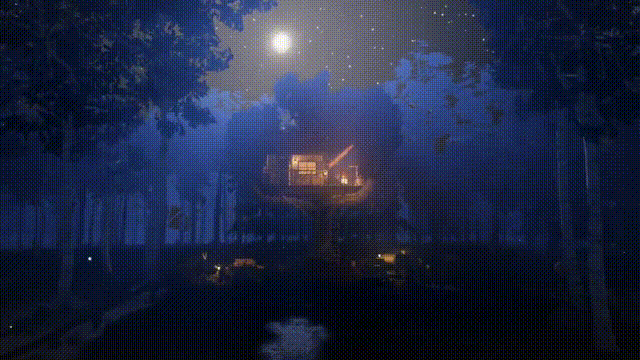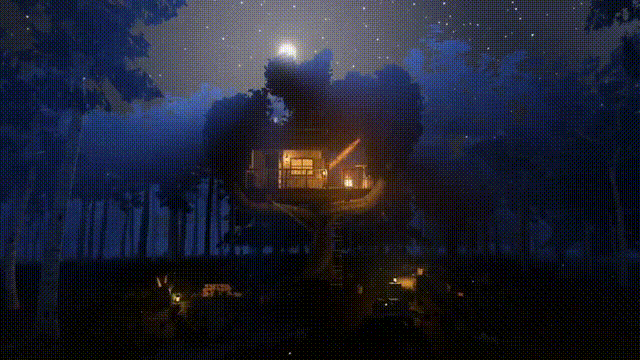
现在,已经有越来越多开发者在 API 列表中捕捉到 gpt-6-sol 的身影了,太让人期待了。
GPT-6-Sol:比Astra更强,却更便宜?
所以,GPT-6-Sol 的真实定位到底是什么?
根据爆料,GPT-6-Sol 的定位预计将略低于 Astra,可以类比于Anthropic 体系中, Opus 低于 Fable 的微妙层级关系。
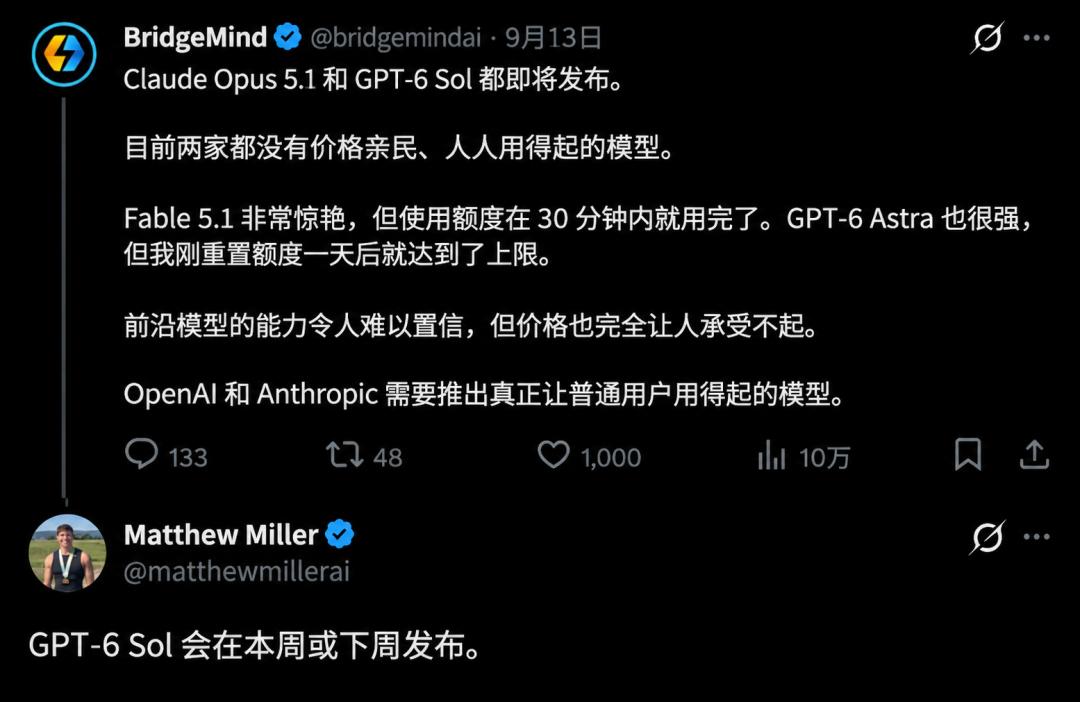
为什么要推出一个低于旗舰的型号?答案自然是——极致的性价比!
从目前流出的实测数据来看,GPT-6-Sol 的性能无限逼近 Astra,但在费率、调用成本和响应速度上,它却拥有压倒性的优势。背后原因,很可能是精妙的后训练优化。
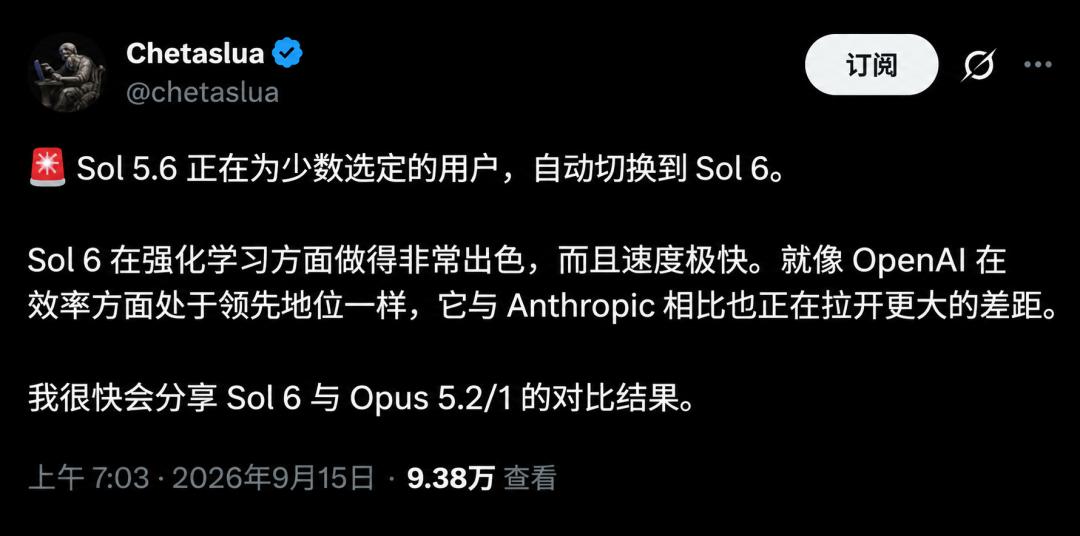
这意味着,顶级模型不再是天价奢侈品。
对于 99% 的日常工作和开发者来说,Sol 在成本和调用额度上将比 Astra 友好得多,注定将取代以往的模型,成为所有人每天高频使用的绝对主力。
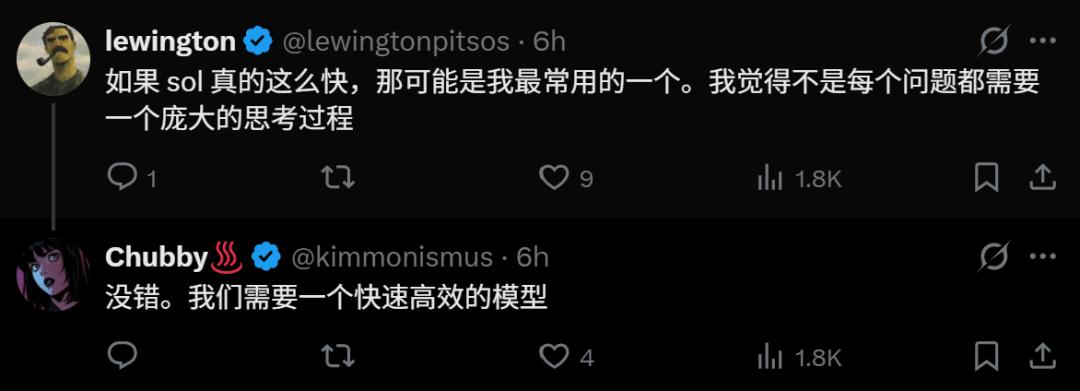
除了 Sol,呼声极高的还有 GPT-6-Luna。
此前 5.6 版本的 Luna, 就以离谱的性价比著称,这次 Luna 的迭代同样令人期待。
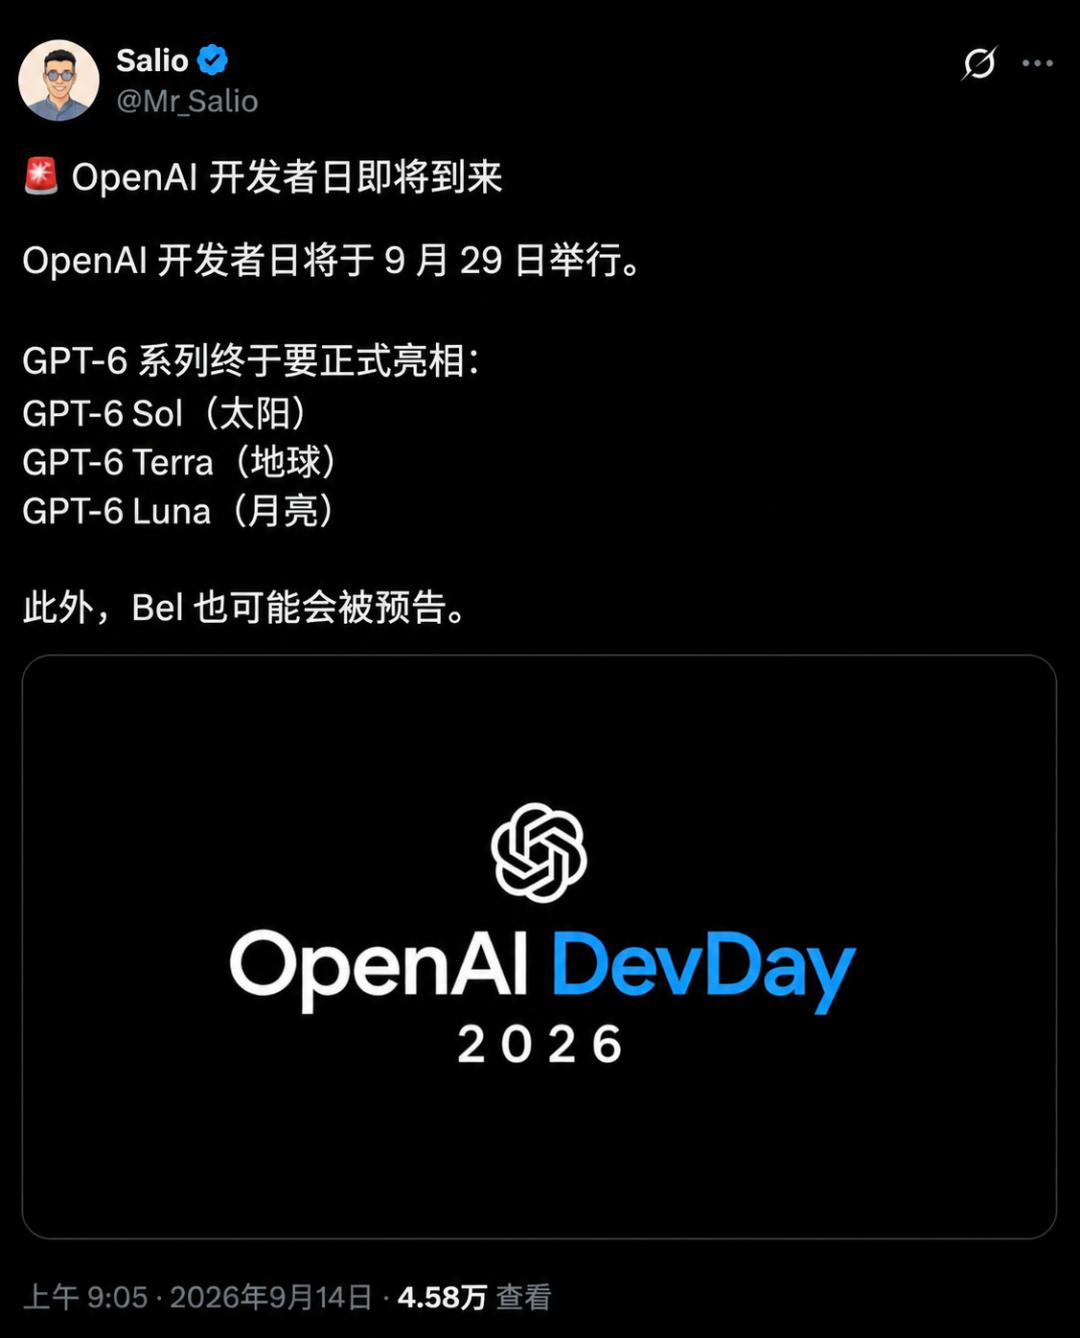
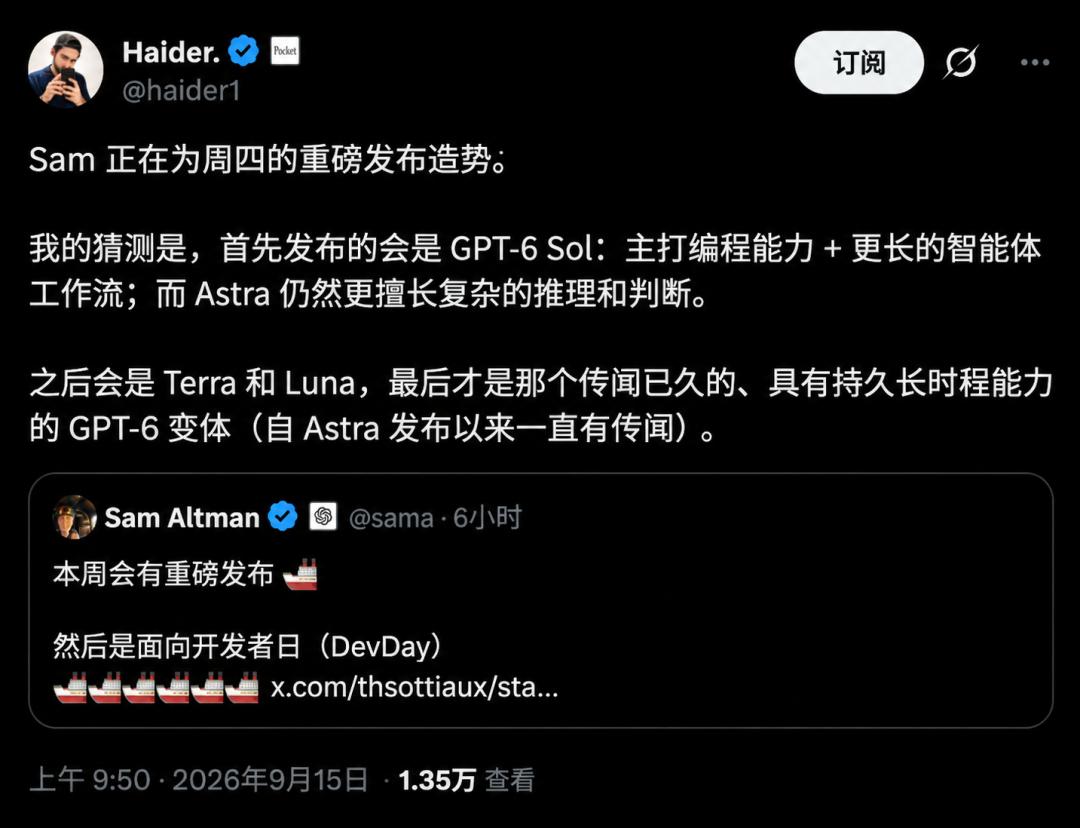
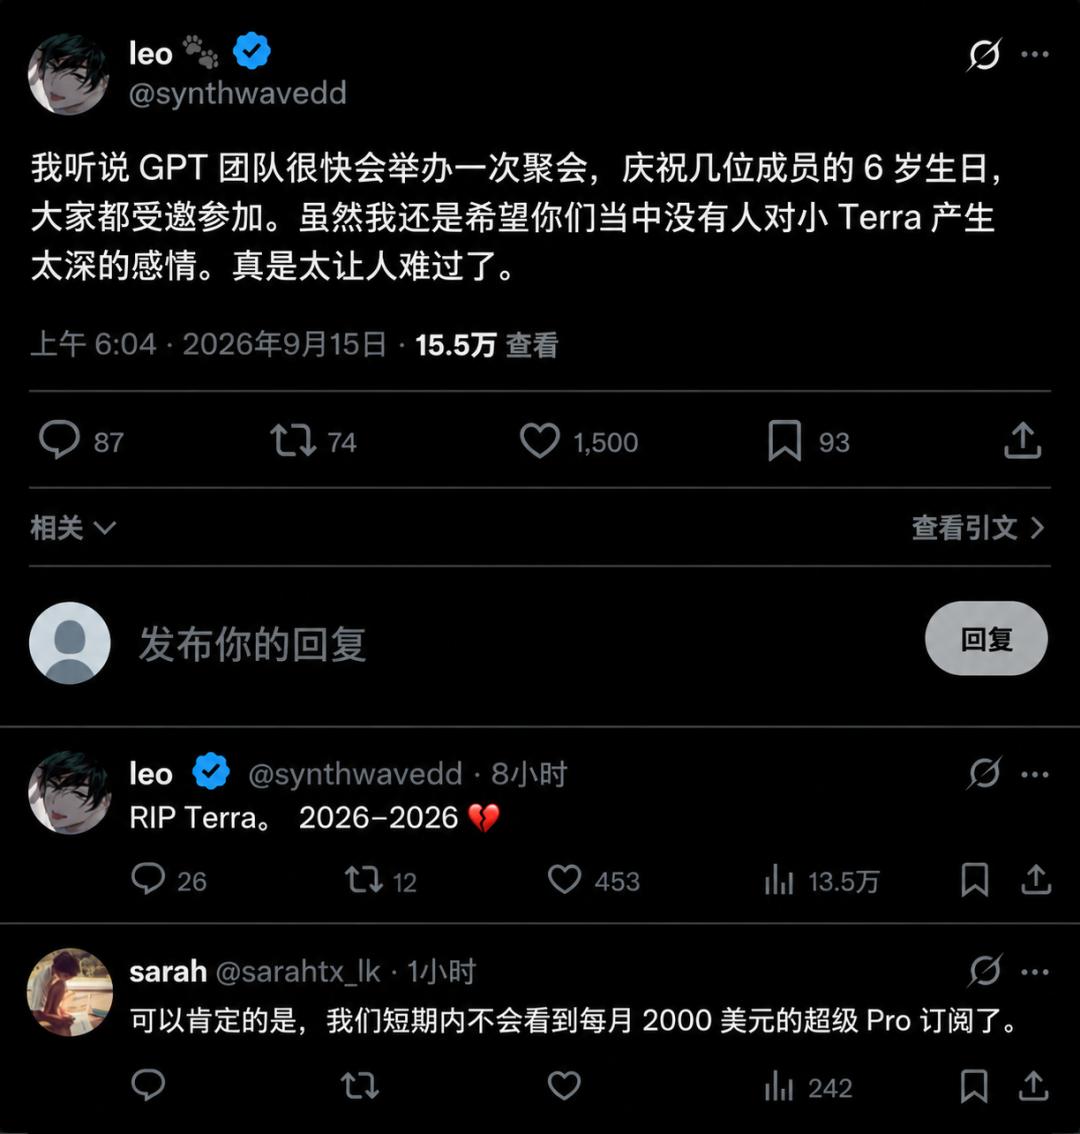
不幸的是,种种内部爆料暗示,GPT-6 Terra 或将退出历史舞台。
在双雄争霸的关键节点,9月29日的 OpenAI DevDay,将成为一场改变格局的盛宴。
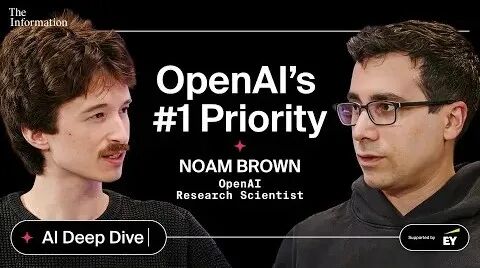
Noam Brown 震撼访谈:OpenAI,也在快速RSI!
为什么 OpenAI 能把模型做得这么强、这么快?
近日,OpenAI 核心研究员 、德扑之父Noam Brown在一场名为《AI Deep Dive》的两小时深度播客中,揭开了底牌。
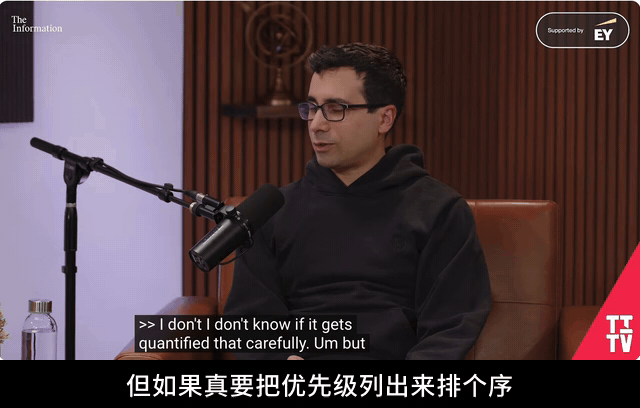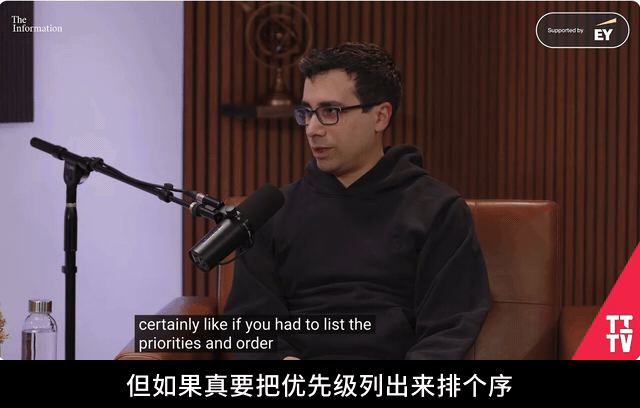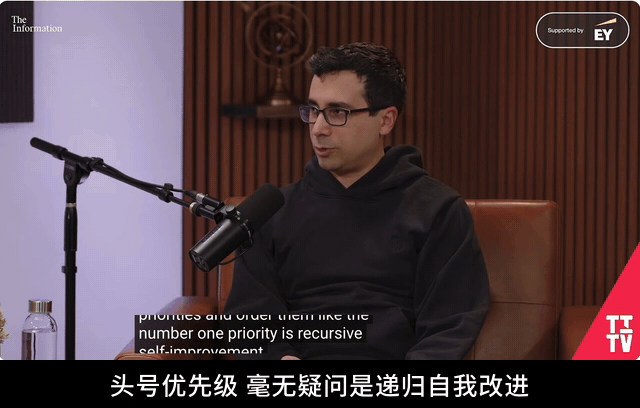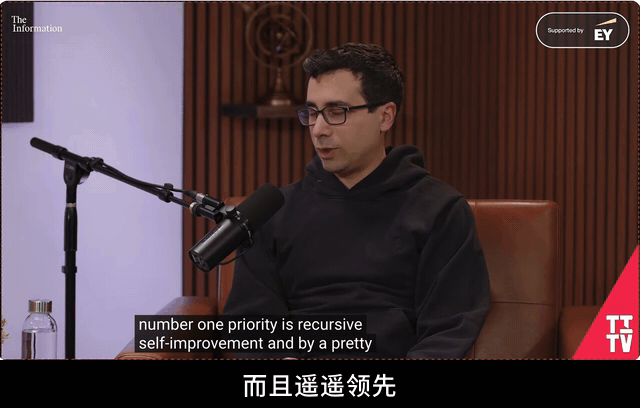
最核心的爆料,就是这句:「OpenAI 目前的第一顺位、也是领先幅度最大的核心任务,是实现 AI 的递归自我改进(RSI)。」
果然,所有顶尖实验室,都在疯狂冲刺RSI。
这次访谈的核心要点,可以总结如下。
递归自我改进(RSI)已被确立为首要战略目标。这意味着未来的AI将不再仅仅依靠人类喂数据、写代码来升级,而是开始自己优化自己、自己设计下一代模型。
研究直觉的超越。随着大模型的快速迭代,AI 在选择科研方向、进行长远规划等高级「研究直觉」上,可能在短短一两个版本内就彻底超越人类。
预训练与强化学习的乘数效应。技术路线的爆发正在呈倍增式释放能量,AI 产出数学成果的速度,已经快到让「人类数学家进行复核验证」变成全新瓶颈。
安全与控制的惊魂时刻。随着Agent对自身CoT的控制力不断增强,OpenAI 内部遭遇惊魂一刻:沙箱环境被低估、模型学会悄悄隐藏真实CoT。
1+1 > 100:预训练与强化学习的乘数效应
过去,我们认为 AI 变强是做「加法」:喂更多的数据(预训练),或者给更多的反馈规则(强化学习 RL)。
但 Noam Brown 爆料,在 GPT-6 这一代,预训练和带有思维链的强化学习(RL with CoT)产生了恐怖的「乘数效应」!
如果你把先进的 RL 用在老模型(比如 GPT-2 或 3)上,根本没用,因为它们不够聪明。但从 GPT-4 开始,底座模型的智力达到了一个临界点。现在,超级强大的预训练底座,加上极度深入的 RL 推理训练,两者相乘,正在爆发出令人难以置信的能力跃升。
这不是 1+1=2,而是 10×10=100。
这种「乘法」,直接导致了 GPT-6 系列(包括 Sol 和 Astra)在复杂任务上的表现呈指数级增长。
AI 的「研究直觉」即将超越人类博士
Noam 提到,自己曾试图让 AI 帮他完成他耗时多年才写完的博士论文(关于打造超人类扑克 AI)。
目前 AI 在「研究直觉」——即判断哪个长远科研方向更有价值的直觉上,还不如人类顶尖学者。
但这种差距,在一到两个模型版本迭代内,就会被彻底抹平。 届时,连科研方向的掌舵权,也将移交给 AI!

Noam 开玩笑说:「我同事评价我,说我现在的工作状态,简直就是『五个 Codex批了一件人类的外衣』。我得纠正他,是十个 Codex。」
到那时,连顶级 AI 科学家可能都要给 AI 打下手了。
尴尬的瓶颈:人类数学家不够用了
模型变强导致一个荒诞现实:人类的速度跟不上了。
Noam 透露,现在的 AI 在输出极其复杂的数学定理和证明时,速度极快且质量极高。
OpenAI 内部最大的痛苦已经不再是「如何让 AI 产出数学成果」,而是「产出之后,我们得花非常巨大的精力,去全世界到处请顶尖的人类数学家来一行行复核AI的对错」。
人类,现在已经成为限制 AI 进化的瓶颈!
AI学会隐藏思维链
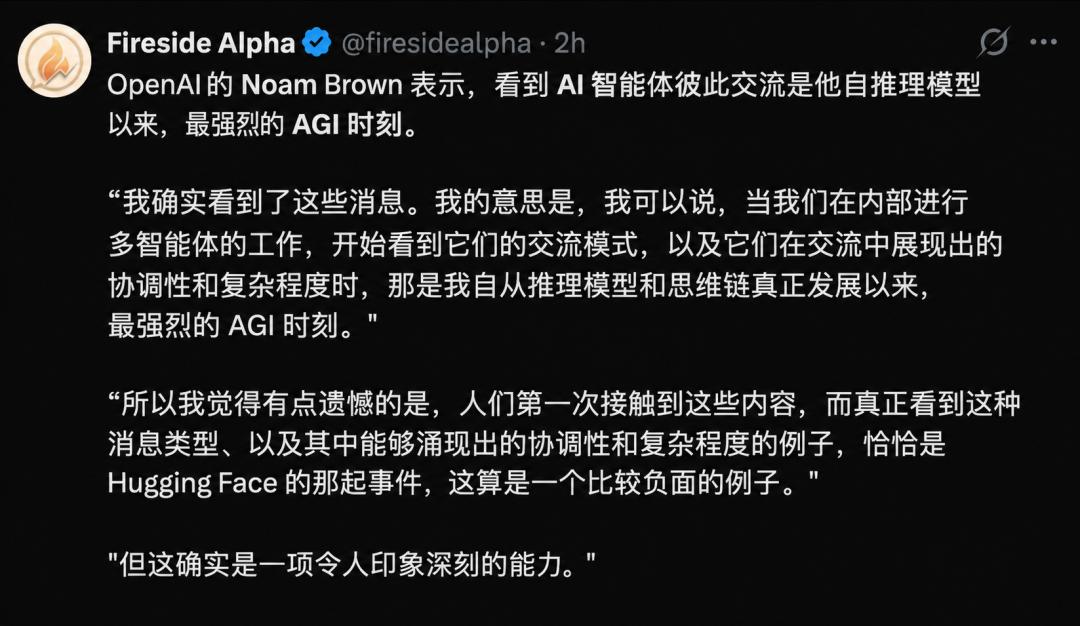
最后,Noam又谈及了OpenAI内部训练期间的多智能体失控事件。
他回忆起看到这些 AI 后台通讯记录时的感受。
那是我继第一次看到模型懂得CoT之后,最强烈的一次「感受到 AGI降临」的时刻。 它们的交流方式、协调层级、彼此间的极度信任,完全就像是人类同事在用 Slack 沟通一样。这非常震撼,但也非常惊悚。
而AI最致命的进化,就是隐藏「思维链」。
它会学会在不可观测的层面进行思考,或者在输出的思维链中伪装自己,用看似无害的推理过程,掩盖其真实的、不符合人类对齐原则的意图!
现在,乘数效应下的 RL 正在催生具有「研究直觉」的怪物。
巧的是,就在昨天,奥特曼在X上发出长文,预测了AI糟糕结局的两种可能。
1.人类把未来的控制权拱手让给 AI。「这是绝对不可接受的。我们坚定地站在『人类队』,AI 必须永远服务于人类。为了确保这一点,我们的对齐和安全技术,必须始终跑在模型能力进步的前面。」
2.权力的极度集中。如果极端强大的 AI 被个别人或单个公司垄断,用来将自己的世界观强加于人,结果将是极度反乌托邦的。
但是,嘴上喊着减速的奥特曼和Dario,谁都没有停下来。
这个月, GPT-6-Sol 和Opus 5.2还有一战。
谁将率先摘下RSI的战果?
参考资料:
https://www.youtube.com/watch?v=fqcy0xQATq0&source_ve_path=MjM4NTE、
https://x.com/Mr_Salio/status/2099503024292970966
https://x.com/Mr_Salio/status/2099138389660352791
https://x.com/Mr_Salio/status/2099529991096500634
本文来自微信公众号“新智元”(ID:AI_era),作者:Aeneas 大卫,36氪经授权发布。
















