Kimi K3.1 Pro刚发布,社区先炸了:比K3快、性能逼近Opus,但额度10分钟就烧光了
10 月 24 日,
按照
K3.1 Pro 目前已经覆盖
API 方面,
除了直接提供模型 API,
这也进一步说明 K3.1 Pro 此次升级的主要方向,
1 Coding 能力大涨,但“偏科”和冗长仍受关注
代码和长程 Agent 是 K3.1 Pro 此次升级最明显的方向之一。
在 Terminal-Bench 4.0 中,K3.1 Pro 得分达到 65.7%。该 Benchmark 通过真实、资源受限的终端环境测试编程 Agent 完成复杂任务的能力,每项任务均设置专项测试。作为对比,
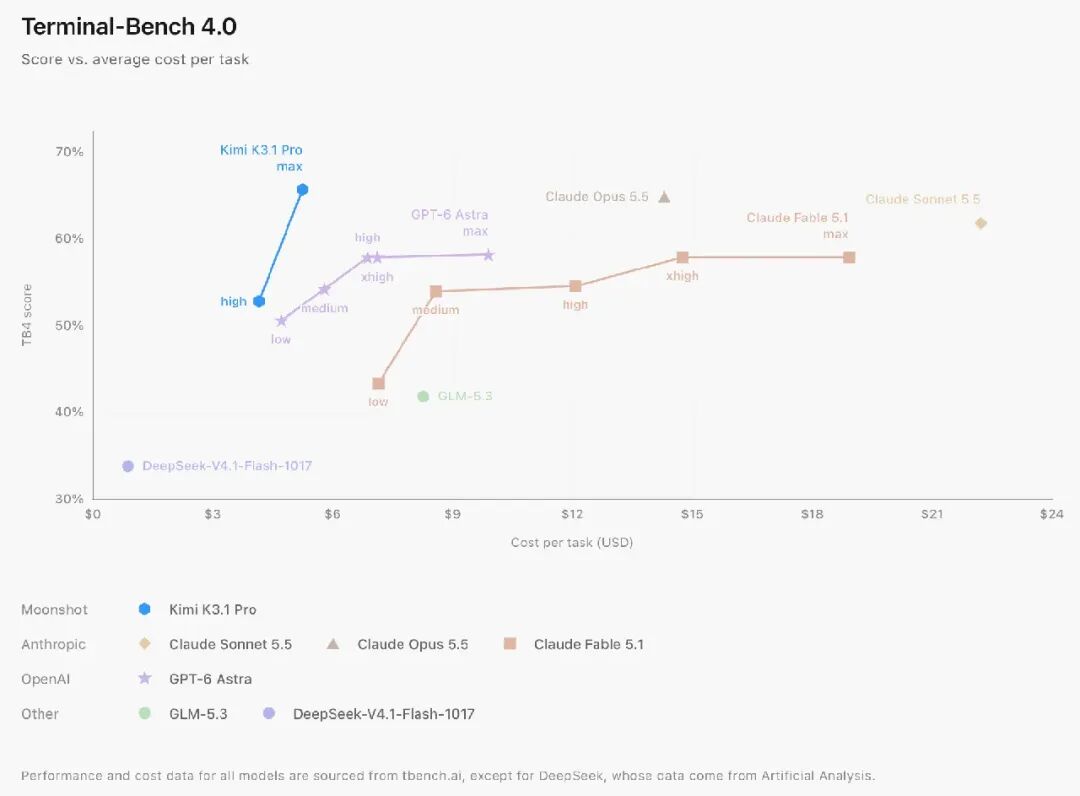
在
相比单纯生成代码,
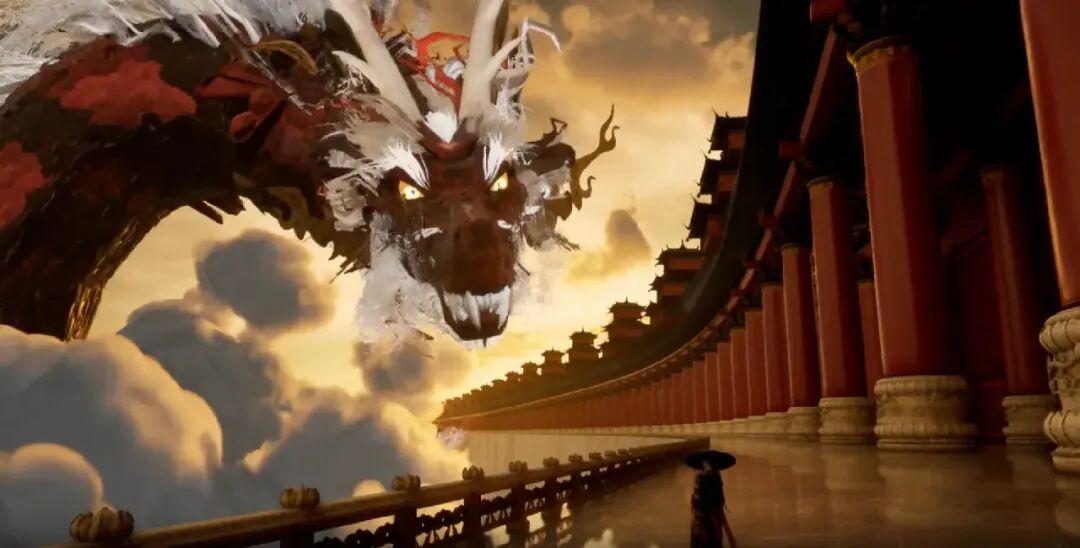
例如,K3.1 Pro 使用 Unreal Engine 5.8 搭建一个云海之上的东方神话天宫游戏场景,调用 Blender 进行程序化建模,并结合 Nanite、Lumen 以及外部 8K 材质和 NASA 月球数据完成场景制作;另一个案例中,它使用 Godot 4.7.2 从零构建了一款包含 5 个探索区域、程序化地形、第三人称战斗、两阶段 Boss、昼夜循环和快速传送系统的 3D 动作冒险游戏。
整个过程中,模型进行了 167 项任务和 420 次独立评审,不断分析实验结果、定位问题和修改控制器,使仿真人体从最初几步就摔倒,逐渐进化至能够交替迈步并连续行走 11.2 秒。值得注意的是,当继续调整奖励函数已经无法改善手臂运动时,模型没有继续“死磕”参数,而是转向检查仿真器动力学,最终发现并修复肩部肌肉力臂计算中的 36 处错误,再重新训练控制器。
模型发布后,很多用户第一时间就自己测试了。有用户称自己用
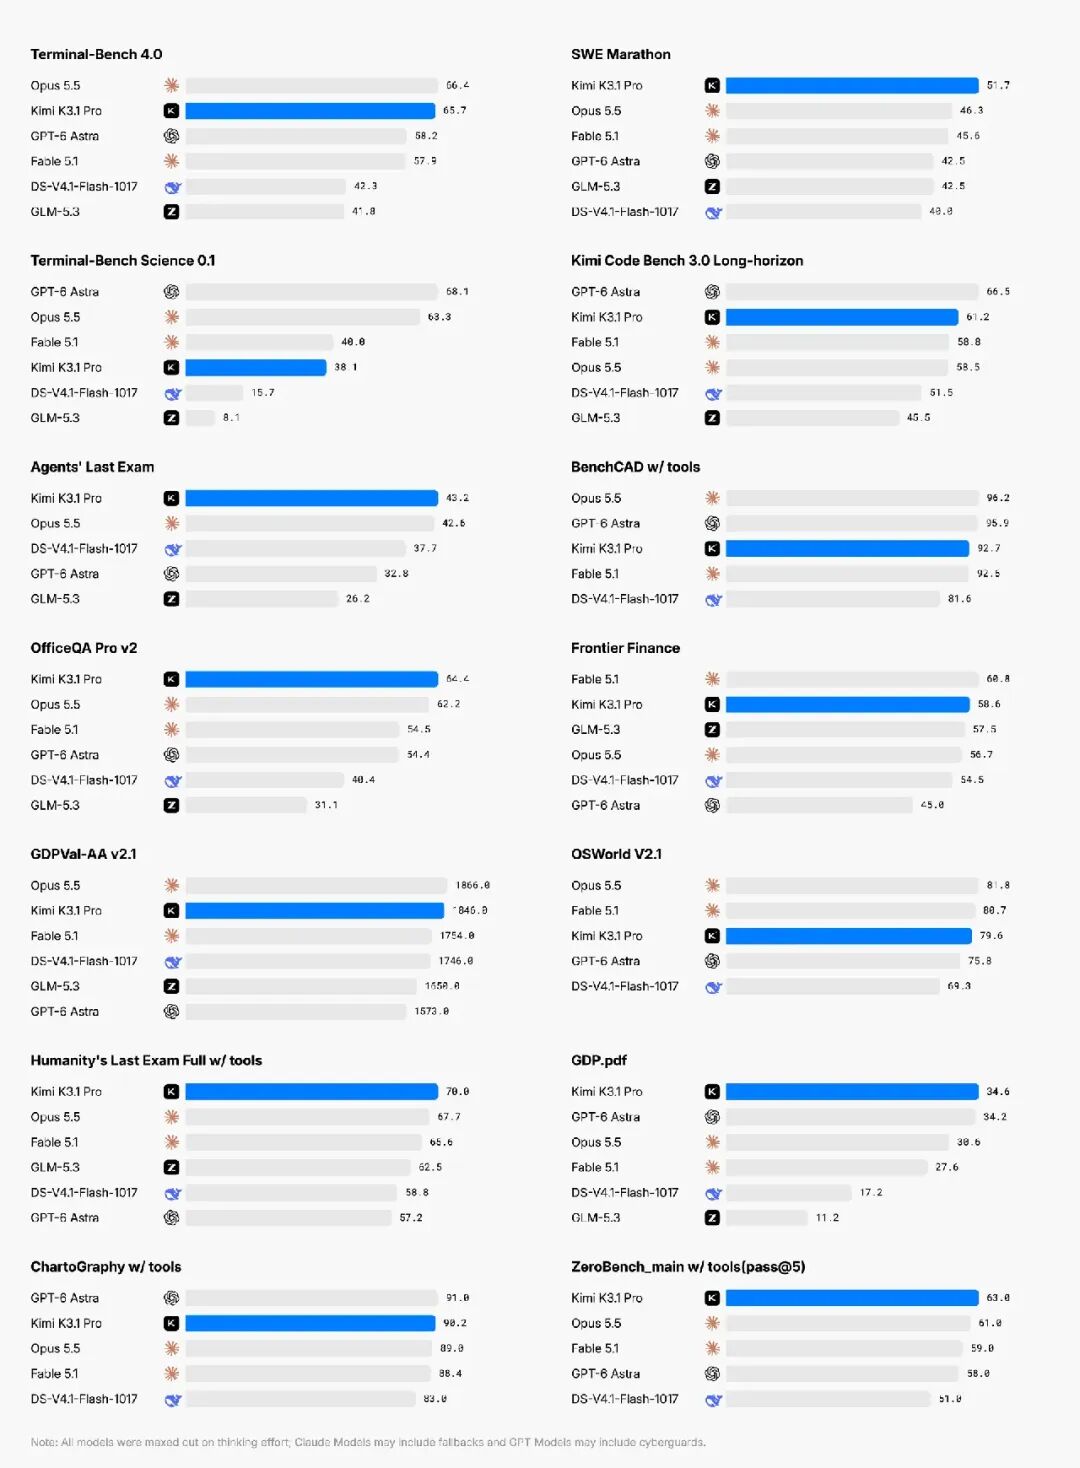
不过 K3.1 Pro 并不是所有领域都同步跃升。Artificial Analysis 数据显示,Humanity's Last Exam 从 47% 提升到 52%,CritPt 从 23% 升至 25%,SciCode 从 59% 升至 61%,提升幅度明显小于 Agent 相关指标。这也让部分社区用户认为,K3.1 Pro 目前仍存在比较明显的“偏科”:代码、Agent、前端和 3D 可能非常强,但并不能简单理解成所有能力都已经全面追平最强闭源模型。
2 3D 能力获得好评,但不太能“一句话出大片”
3D 是
在 BenchCAD 测试中,K3.1 Pro 借助工具取得 92.7% 的成绩,接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%。BenchCAD 主要测试模型从多个视角渲染图重建 3D 物体的能力。模型需要生成 CAD 代码,推断物体的形状、比例以及各组成部分之间的空间关系。
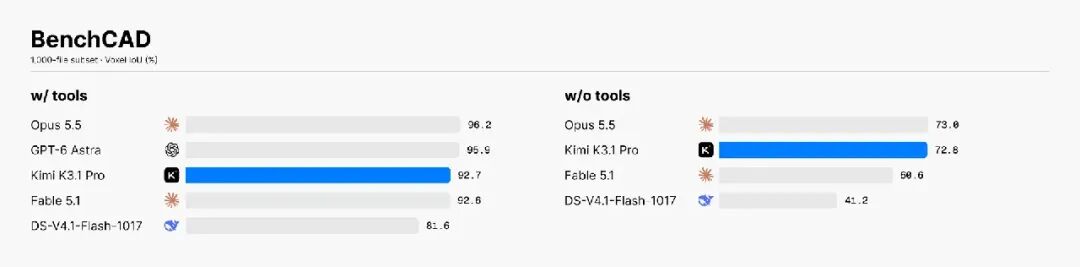
在官方的一个 FreeCAD 案例中,K3.1 Pro 通过 Python 构建了一个包含风扇、减速齿轮箱、压气机、燃烧室、涡轮以及外部管路的涡扇发动机,共包含 2100 个实体,并生成分步装配、内部爆炸图以及多个转子的旋转动画。另一项任务中,模型使用 trimesh 设计了一款由 5 个部件组成、可以直接 3D 打印的台灯,造型灵感来自福建土楼。
实际上,在正式发布前,代号“Kibitz”的疑似 K3.1 模型已经在 Arena 出现,一些测试者注意到它在 3D 场景、颜色选择、水面反射和整体构图上的表现较为突出。正式发布后,也开始有开发者把它放进真实 3D 工作流测试。
一名 AI 游戏开发者使用 K3.1 Pro 和 pi.dev Harness 生成“鹈鹕骑自行车”的高精度 3D 场景后认为,即将开放权重的模型已经可以做出相当不错的 3D 效果。不过他的测试也揭示了一个差距:K3.1 Pro 并没有靠一次 Prompt 直接得到最终结果,而是需要多轮“继续增强”的指令;相比之下,他此前测试 Claude Opus 5.5 时,用一次 Prompt 就得到了更完整的成品。
3 主动“砍掉”网络攻防能力,开放权重引发更多争论
随着模型代码和 Agent 能力快速提高,
内部实验显示,如果在中期训练和强化学习阶段都不删除这些网络攻防数据,模型的下游攻击能力会大幅增强。因此,在准备 K3.1 Pro 开放权重版本时,
为了衡量效果,团队构建了 xdev-bench-hard 测试,其中包含基于源代码的漏洞发现和利用任务,覆盖 Linux 内核、Node.js、JavaScriptCore、Exim 和 VirGL 等软件近期公开漏洞。
测试中,Agent 需要读取存在漏洞的源代码、提示和二进制文件,自行开发漏洞利用程序,并在隔离沙箱中实现任意代码执行。如果不删除网络攻防训练数据,同一训练流程产生的模型在 xdev-bench-hard 上的 pass@3 可以达到 90.5%,最终发布版 K3.1 Pro 降低至 81.0%。
按照
对此,有开发者认为,这相当于
这里也出现了一个此前开放模型很少需要面对的问题:随着开放权重模型越来越逼近闭源前沿,“究竟开放多少能力”本身开始成为模型设计的一部分。
4 金融研究能力提升,事实错误率从 23.4% 降至 8.3%
除了代码和 3D,金融也是 K3.1 Pro 强化幅度较大的领域。
在 OfficeQA Pro v2 测试中,K3.1 Pro 得分 64.4,按照
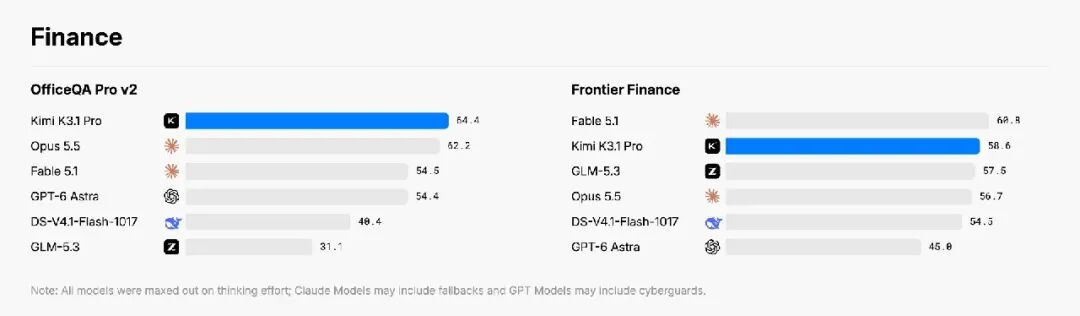
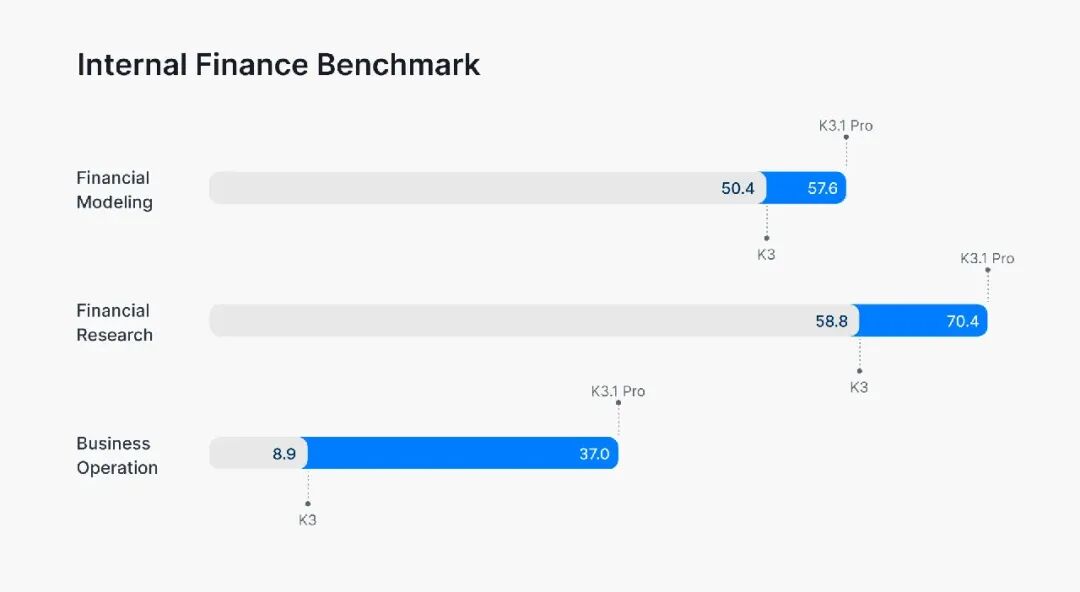
在实际案例中,K3.1 Pro 可以端到端生成英伟达财务模型,包括经营驱动因素、情景假设和估值敏感性分析;也可以围绕宁德时代制作投委会报告,分析市场一致预期与实际经营之间的差异,并结合财报、指引和潜在催化因素形成投资逻辑。
对于金融 Agent 而言,真正困难的并不只是计算,而是事实准确性。为此,
在内部
不过
5 “额度几分钟就烧完”成最大槽点
与能力上的好评形成鲜明反差的是
一名用户称,自己订阅了每月 99 美元的
Reddit 上甚至出现了更极端的个案。一名用户测试一个基础 3D 游戏 Demo 时称,没有使用子 Agent,模型运行约 10 分钟、任务尚未返回结果,就已经耗尽整个 5 小时额度;另一些 Plus 甚至更高等级订阅用户也报告了类似的快速消耗现象。这也让部分用户表示,直接按照 API 价格使用
有用户认为,如果一个开放模型既因为参数规模过大难以在消费级硬件本地运行,又无法通过固定订阅获得足够长时间的使用,那么开放权重本身对普通开发者的价值也会受到限制。
从 API 价格看,K3.1 Pro 并不算昂贵,但固定订阅套餐里的可用量,却成为不少重度代码用户最明显的痛点。一些开发者甚至开始讨论“混合用模”:让 K3.1 Pro 负责规划和复杂决策,再让
有意思的是,第三方数据确实能够解释一部分用户的额度焦虑。
Artificial Analysis 在完成整套 Intelligence Index 测试时,K3.1 Pro 累计输出约 1.5 亿 Token,而参与测试模型的中位数只有 8700 万 Token。也就是说,它在相同评测中输出的 Token 数量比中位水平高出约 72%。
Artificial Analysis 因此直接把 K3.1 Pro 评价为“非常冗长”。
速度也不是它的强项。Artificial Analysis 测得 K3.1 Pro 输出速度约 73.5 Token/s,低于 81.1 Token/s 的同类模型中位水平。不过不少用户反馈,K3.1 Pro 的实测速度“远快于 K3。”
但另一方面,因为 Token 单价下降,其整体任务成本仍具有竞争力。Artificial Analysis 估算,其 Intelligence Index 平均每项任务成本约 2.11 美元。另一项基于该数据的比较显示,Claude Opus 5.5 对应成本约 5.98 美元,GPT-6 Astra 约 3.26 美元。也就是说,K3.1 Pro 虽然“话多”、消耗 Token 多,但 API 场景下的单位任务成本并不差。
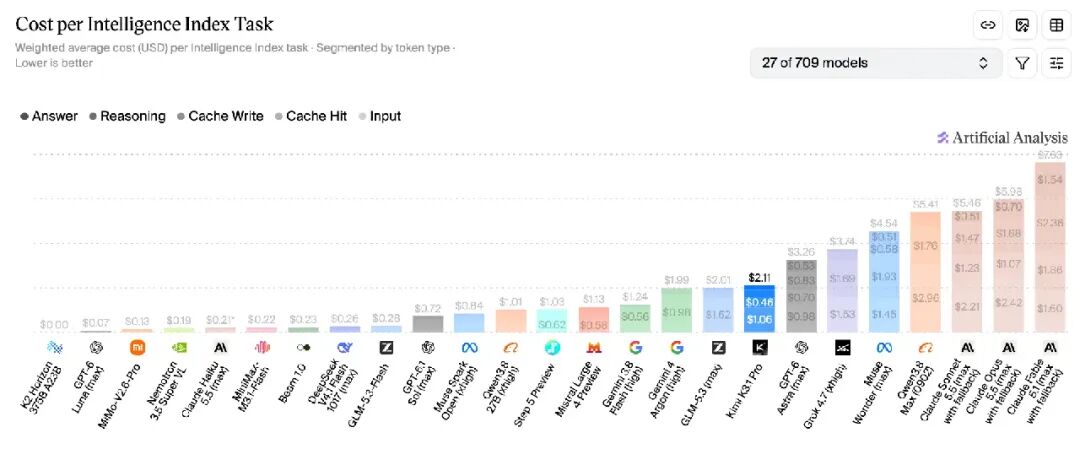
真正的矛盾更多出现在订阅制产品,用户对一项任务跑多久、花多少钱更为敏感。
这对于像 K3.1 Pro 这样定位长程 Agent 的尤其关键。模型越擅长持续搜索、调用工具、写代码和自我检查,一项任务持续时间越长,它就越容易吃掉大量推理预算。如果配套套餐没有同步提高使用上限,模型能力越强,反而可能越容易撞上“额度墙”。
不过,长程 Agent 的“额度焦虑”并非
有 Claude 用户表示,自己使用 20 美元档套餐时,也遇到过一个复杂 Prompt 就几乎耗尽 5 小时额度的情况;另一名用户使用 Opus 5.5 处理已有代码库,大约 30 分钟后同样触发了使用限制。OpenAI 用户也报告了类似体验,一名用户称,在 20 美元套餐中使用高推理档位进行代码分析时,一次任务甚至还未完成便撞上额度限制。
因此,不同用户对“
参考链接:
https://www.kimi.com/en/blog/kimi-k3-1-pro
https://artificialanalysis.ai/models/kimi-k3-1-pro
https://news.ycombinator.com/item?id=50212563
https://www.reddit.com/r/aigamedev/comments/1xdp79w/nonfrontier_models_are_getting_excellent_at_3d/
声明:本文为 InfoQ 原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
本文来自微信公众号 “InfoQ”(ID:infoqchina),作者:褚杏娟,36氪经授权发布。
















