谷歌终于支棱起来了,Gemini 4 Pro空降Arena榜单,13项跑分碾压GPT-6和Fable
谷歌终于舍得放大招了!后附全能王Gemini 4 Pro实测。
过去半年,大模型的排位换了一轮又一轮:GPT-6(Astra)、Fable接连把战场推进到代码、Agent和长程任务,谷歌这边却处于长期被碾压状态。
挤牙膏似的更新Flash系列,真正代表旗舰实力的Pro却迟迟没有完成换代。要知道距离Gemini 3.1 Pro发布,已经过去整整7个月。
原定6月亮相的Gemini 3.5 Pro一再延期。有报道称,Google当时仍在继续补强其Coding能力,延期已经广泛引发内部对团队迭代速度的担忧。到了7月财报会上,Google干脆提前亮牌,劈叉哥宣布,公司早已启动Gemini 4“迄今最雄心勃勃的预训练”。
9月18日消息,谷歌跳过了 Gemini 3系列的小版本更新,Gemini 4直接上阵。昨夜,多名开发者开始在Arena的匿名Battle Mode中抽到一个名为gemini-3.8-flash的模型。问题在于,真正的Gemini 3.8 Flash早在9月2日就已经正式发布,而且已经进入Arena公开榜单。
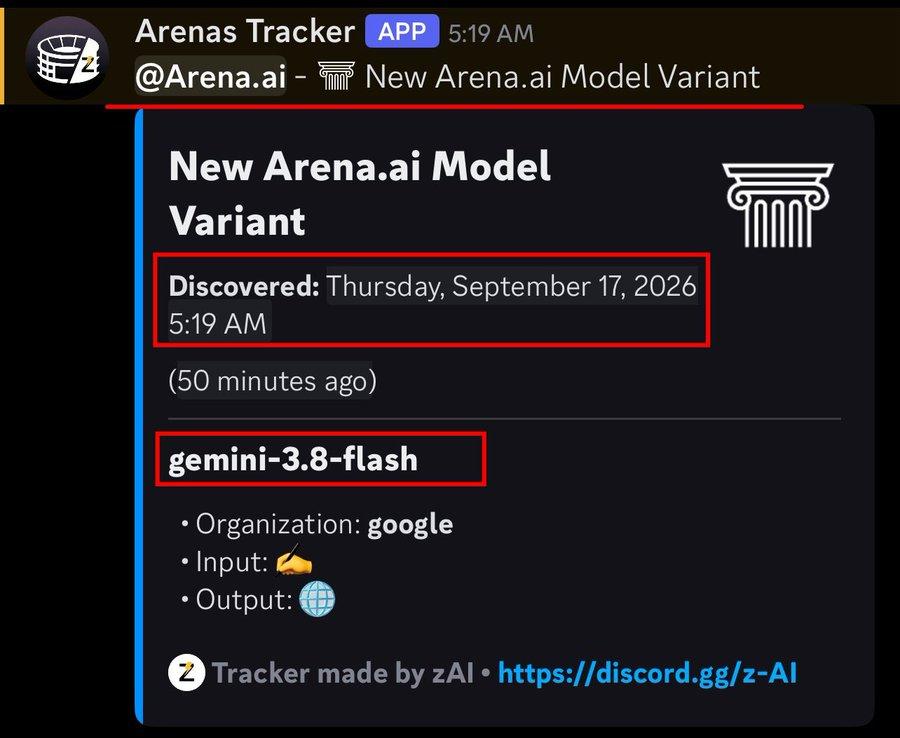
同一个名字,为什么又突然出现在匿名测试里?更反常的是,这个“3.8 Flash”展现出的能力远远高于公开版本。
很快,LuminaBench、Harshith、Qwinah等长期追踪前沿模型的测试者随后陆续将其指向Google正在测试的Gemini 4 Pro checkpoint,内部代号被曝为“Argon”。
Qwinah还通过超长JSON压力测试称,该模型能够持续输出至接近256K规模。当然,这些参数目前仍属于社区测试结果,尚未得到Google确认。
但真正把这轮讨论的预期值拉满的,还是随后流出的Arena盲测榜单。
13项全能碾压Astra和Fable
按照这份Benchmark对比数据,Gemini 4 Pro在表中列出的13组测试里全部取得最高成绩,对手包括GPT-6 Astra、Claude Fable 5.1、Claude Opus 5和GPT-5.6 Sol。
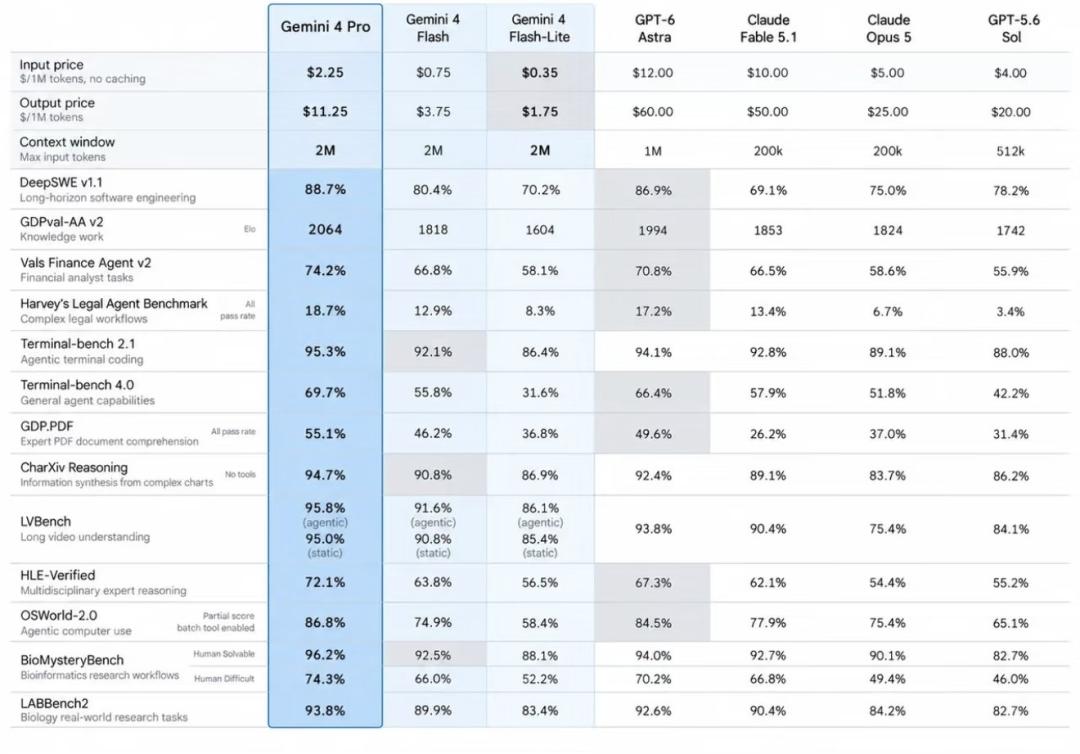
最直观的Coding测试DeepSWE v1.1中,Gemini 4 Pro拿到88.7%,超过Astra的86.9%;
考察真实知识工作的GDPval-AA v2,达到2064 Elo,同样超过Astra的1994;
HLE多学科专家推理,达到72.1%,领先Astra近5个百分点。
而在任务越复杂、链路越长,Gemini 4 Pro表现出的优势更加明显。
在Terminal-Bench 2.1中,它与自家Gemini 4 Flash只有3.2个百分点差距;换到更考验通用Agent长程执行的Terminal-Bench 4.0,差距直接扩大到13.9个百分点。
类似的情况还出现在OSWorld 2.0。Gemini 4 Pro达到86.8%,Gemini 4 Flash为74.9%,拉开11.9个百分点;DeepSWE、HLE以及BioMystery高难任务中,Pro相比Flash也分别领先8.3、8.3和8.3个百分点。
这意味着Gemini 4 Pro的能力提升集中于Agent长程任务,在任务持续时间拉长、步骤增加、需要不断读取状态并重新规划时,性能衰减得更慢。
这恰恰是当前Agent真正卡脖子的地方。DeepSWE本身就是专门为长程软件工程任务设计的测试,需要模型在真实代码库中持续修改和验证;OSWorld 2.0则把Agent扔进真实电脑环境,108项任务中近七成需要人类一小时以上完成,平均需要数百步操作。
Terminal-Bench团队自己总结过,现有Agent最典型的问题,就是难以持续串联多步动作、维护长上下文,并在缺乏人工干预的情况下自主完成复杂工作。
近五分之一的价格
Gemini 4 Pro的价格可能比跑分更凶。
榜单显示,Gemini 4 Pro价格只有每百万Token输入2.25美元、输出11.25美元,而Astra分别达到12美元和60美元。也就是说,Google不是用更贵的旗舰换来了领先,而是以约五分之一的Token价格打出了更高的成绩。
如果这一价格真正落地,势必将拉低A社和OpenAI的价格:旗舰模型的竞争,开始从“谁最强”变成“谁能让最强能力便宜到可以大规模跑Agent”。
当然,目前这张成绩表尚未得到官方认领,还需辩证看待。
以DeepSWE为例,其公开Leaderboard当前Astra成绩约为74.1%,Gemini 3.8 Flash约73.8%,与流出表中的数值口径存在差异,意味着后者可能使用了不同Agent harness、推理配置,或者来自尚未公开的新一轮测试。
实测惊艳
当前,Arena已经跑出了密集测试。比较惊艳的是网页设计。
开发者让Gemini 4 Pro制作一个专题网站,模型最终只用了14分钟,就完成了从页面结构、视觉风格到交互效果的一整套设计。测试者评价:网站“干净、精致”,甚至感叹,早期Gemini模型长期被吐槽的“设计品味”问题,似乎终于解决了。
另一个经典测试,则是“鹈鹕骑自行车”。开发者Harshith表示只给出一句要求:尽可能漂亮地用SVG画一只骑自行车的鹈鹕。 Gemini 4 Pro就能用代码完成整幅动态场景,鹈鹕、车轮、骑行动作和背景关系都保持得相当完整。
这类任务难点不只是写SVG,而是要同时处理代码、空间关系和视觉构图。社区随后拿公开版Gemini 3.8 Flash跑同一提示词,成品差距相当明显(可见开篇对比视频)。
第三类测试从“画图”升级到真正的3D交互。
Voxel Pagoda测试中,Gemini 4 Pro大约花5分钟搭出一座可交互的像素风3D宝塔;另一项PS5 SVG测试甚至连续运行约10分钟,不仅细节入微,更展现了模型在持续规划和生成,把复杂成品一次做完的能力。
本文来自微信公众号 “AI前线”(ID:ai-front),作者:四月,36氪经授权发布。
















